如果家庭个人电脑上的LLM智能体需要等待100秒才能吐出第一个词,那么这种对话就很难保证实际可用性。然而,据2026年11月2日报告,仅依靠普通游戏显卡和标准内存,无需数据中心或云基础设施,即可将这一等待时间缩短至26秒,使智能体会话的感知速度提升20倍1。
核心不在于加快运算速度,而在于不丢弃已计算结果,而是对其进行复用。应用于Strata引擎中的“KV Splice”和“Resident-only Routing”两项技术,特别是在系统提示词需要频繁变更的编码智能体环境中,已被验证能够有效消除瓶颈1,2。本文将具体确认该案例在何种硬件上,依据何种原理消除了延迟。
瓶颈不在于“推理”,而在于“提示词重处理”
当我们感觉LLM智能体速度慢时,通常会联想到令牌生成速度,即推理速度。然而,在Strata项目和OpenCode智能体环境中观测到的瓶颈并非推理,而是提示词输入阶段1,2。
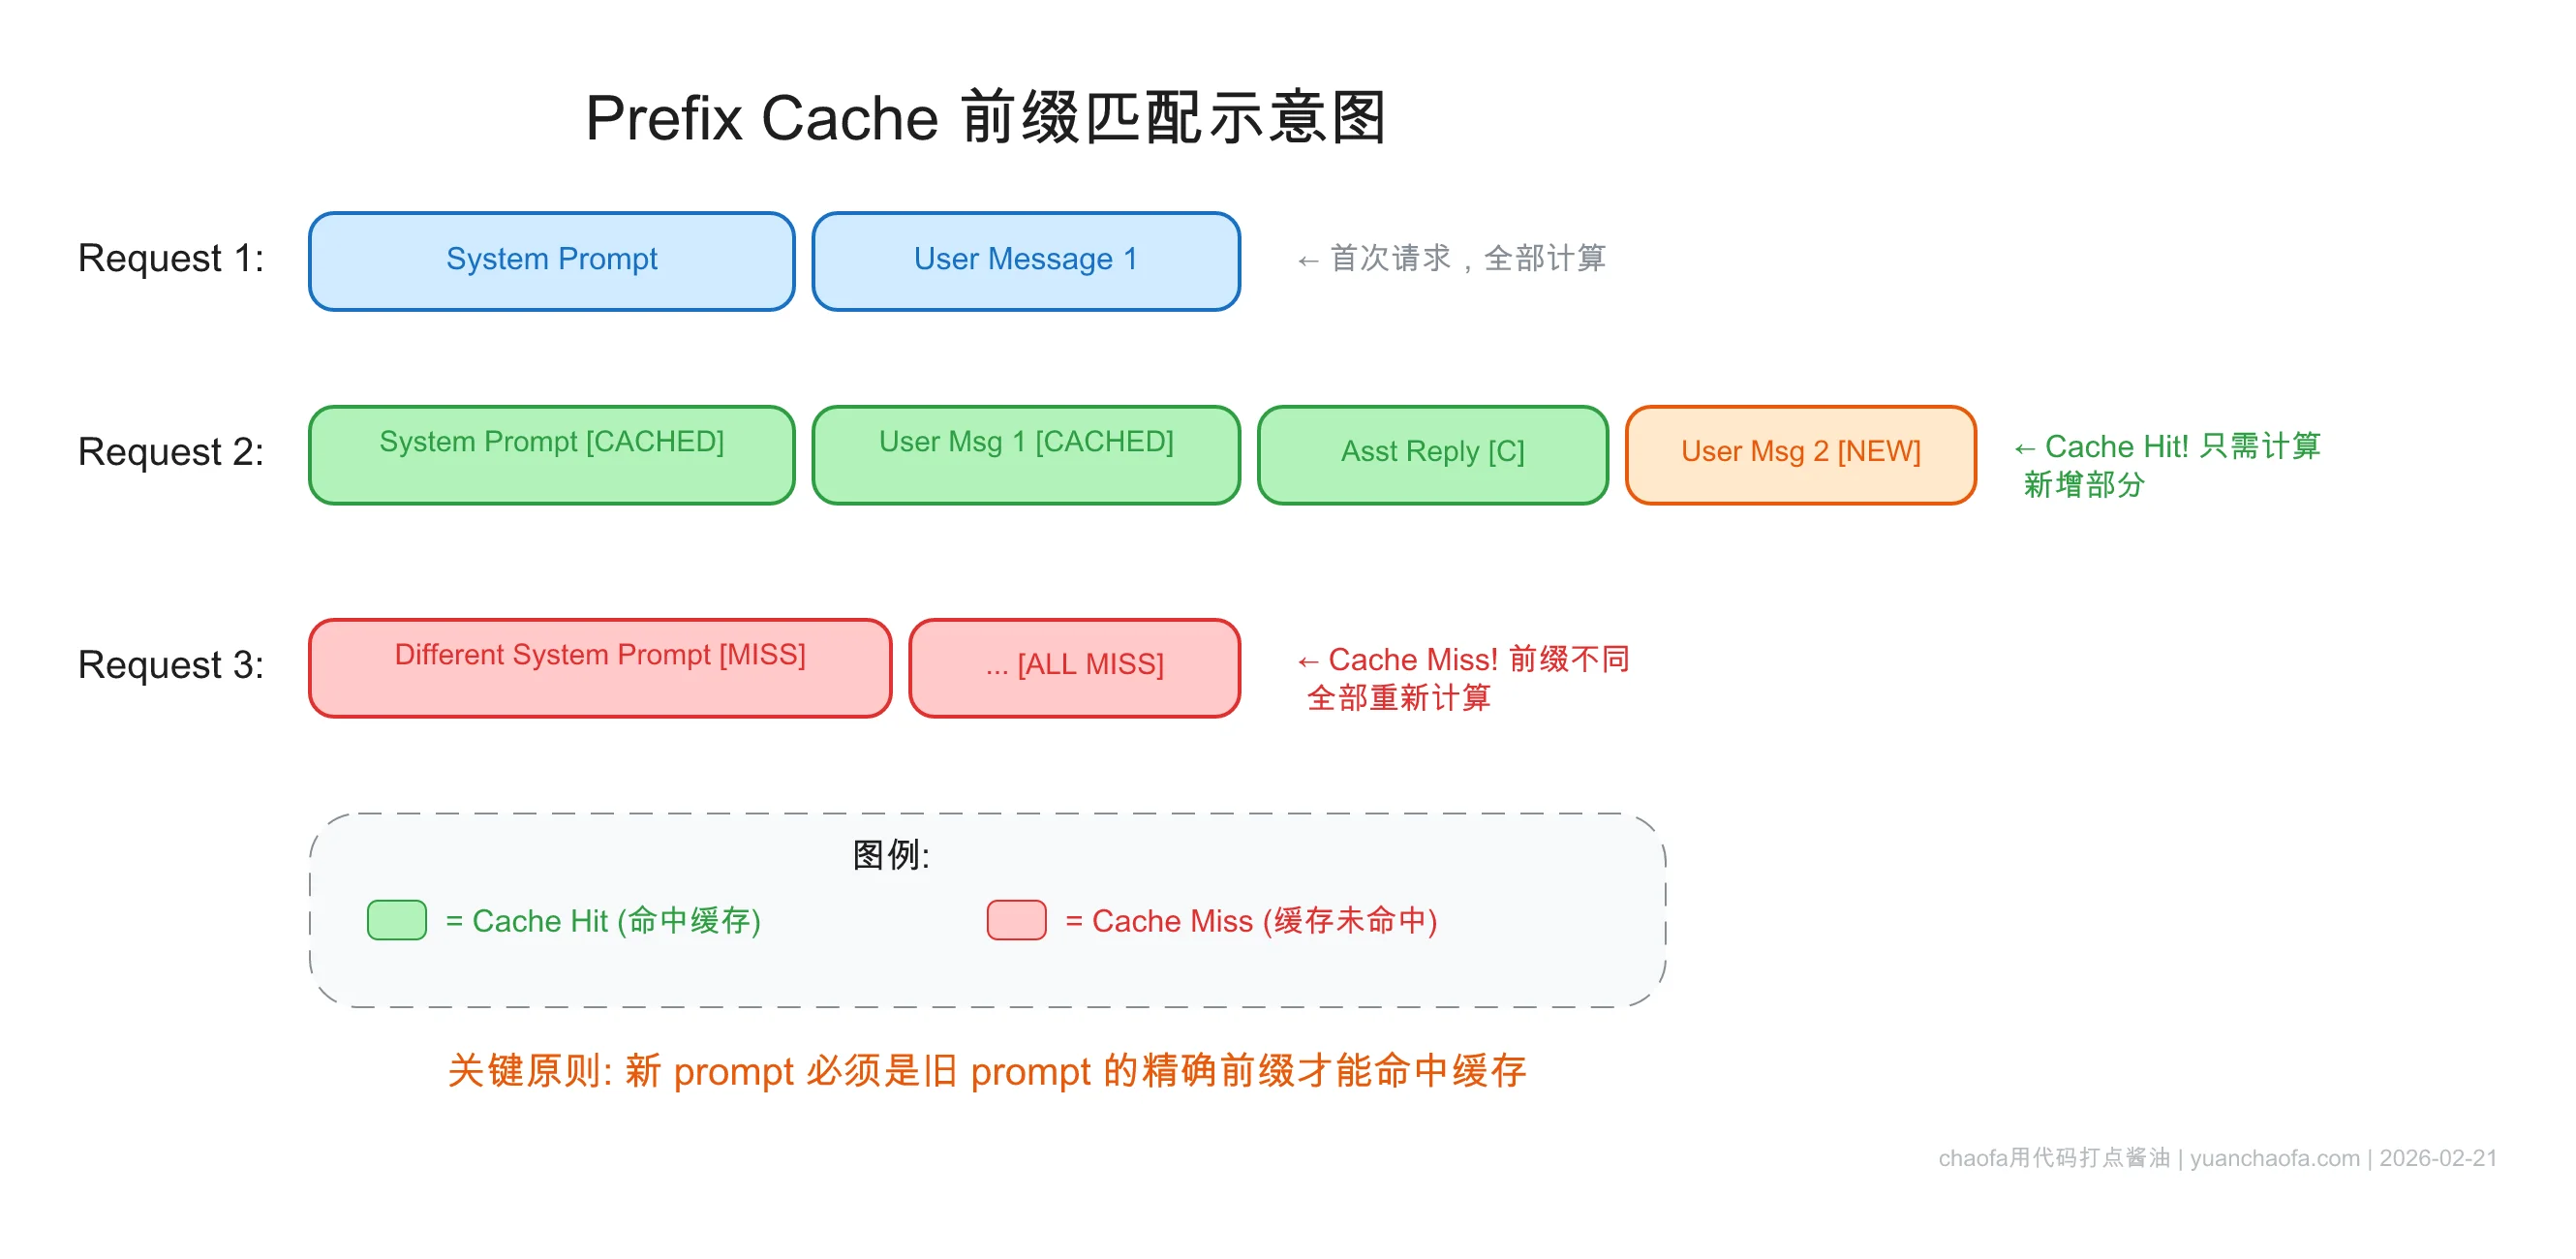
编码智能体OpenCode在每次会话开启时,都会将工作目录、当前日期、Git状态等上下文信息插入到系统提示词的顶部2。这些信息每次都会略有不同,导致频繁发生提示词缓存未命中(Prefix Cache Miss)现象1,2。一旦缓存失效,模型就必须重新读取甚至包括其已掌握的内容。实际测量显示,OpenCode环境中的系统提示词长约37K个令牌,因此每个会话都要重复约37K个令牌的重处理延迟1,2。
结果,生成第一个令牌所需的时间飙升至约100秒1,2。在由RX 9070 XT显卡、Ryzen 5800X3D CPU、DDR4 64GB内存以及PCIe 3.0 NVMe SSD组成的家庭个人电脑上,DeepSeek V4.1 Flash模型的提示词处理时间记录到了约100秒1。由于该阶段并非真正“生成”大模型输出的部分,而是重新刷新已读取上下文的部分,因此问题的性质显而易见。
KV Splice:仅读取变更行,而非全量重算
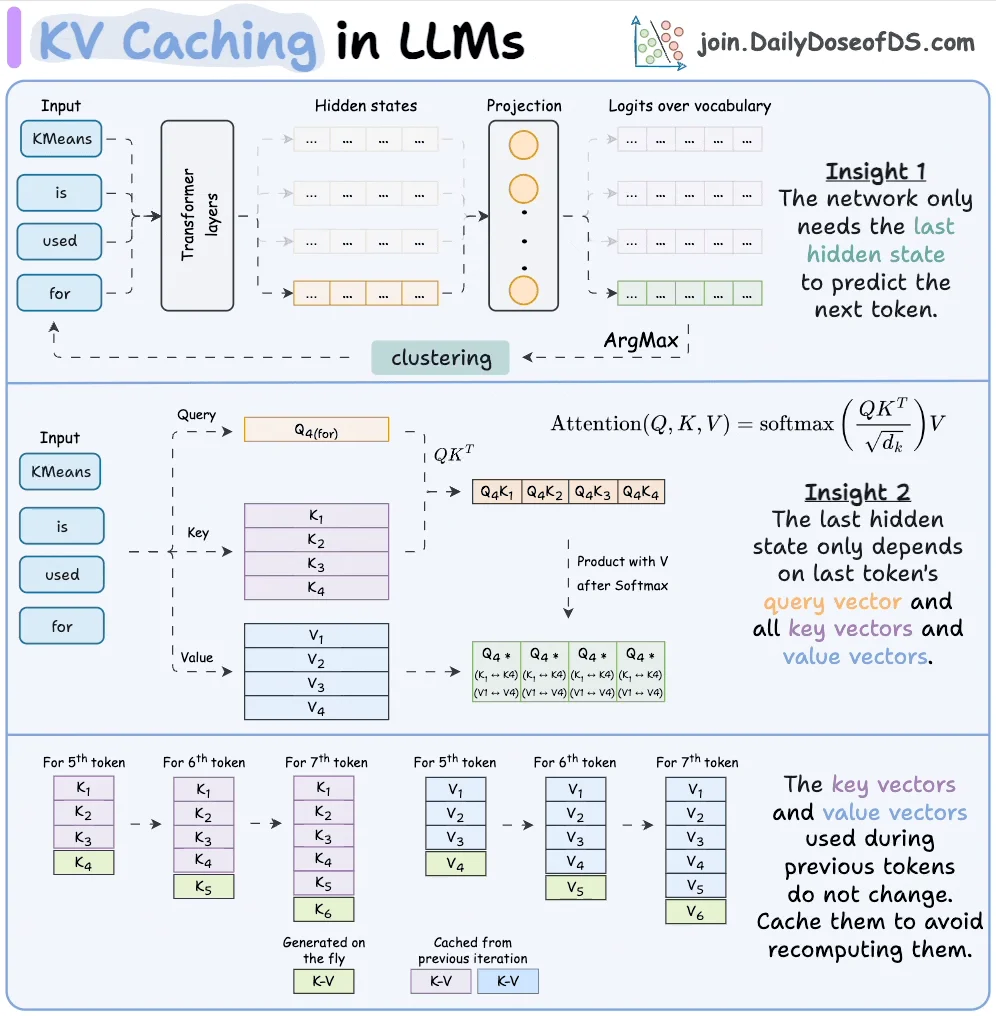
解决这一瓶颈的首要技术是KV Splice。该技术通过分析现有会话中已计算好的KV Cache状态,仅读取提示词发生变更的行1,2。也就是说,它并非从头重新读取全部37K个令牌,而是保留可复用的缓存,仅对发生变化部分进行增量处理。
根据提议的工作原理,引擎将模型内部状态和保留的对话以32令牌为单位对齐为令牌运行(token runs),以选择最大复用路径2。当对话不连续时,保留状态中的删除行将被截断,随后调整源行和窗口环2。为了处理位置值的跳跃,会记录RoPE间隔(rope_off),此删除表以DS4CUTS1尾注形式存储在槽位中2。通过RoPE间隔移动缓存行的方式,实现了近似的复用1。
应用此方法后,提示词处理时间从约100秒缩短至26秒1。这实现了约4倍的加速,并通过复用36,097个令牌达成1,2。在简单合成会话测试中,第二个会话的令牌复用率超过99%,约10秒即返回响应,并在处理5.4万令牌对话后续时,证明了复用53,080个令牌的高效性2。提示词处理速度提升4倍最终带来智能体会话感知速度提升20倍,是因为绝大部分等待时间都集中在这一输入阶段1。
Resident-only Routing:消除提示词读取中的SSD流式传输瓶颈
第二项技术是“Resident-only Routing”。该技术在提示词读取时,通过路由优先使用已加载至VRAM和RAM中的专家(Expert)模块,并与KV Splice并行应用1,2。
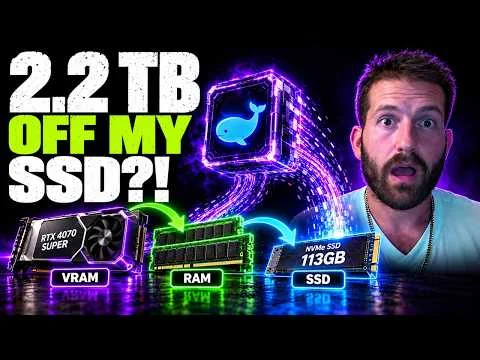
Strata采用从SSD直接流式传输无法载入内存模型的方式3,4。如DeepSeek V4.1这样的大规模模型需要250GB以上的磁盘空间,无法放入内存的数据从SSD读取3,4。问题在于,这种流式传输在提示词读取阶段是不必要的。在原有方式中,即使在读取提示词期间也会出现从SSD流式传输大量数据的瓶颈,甚至曾报告出现过处理小提示词时从SSD流式传输58GB数据的情况1。
Resident-only Routing在提示词读取阶段抑制SSD流式传输,强制仅使用已加载到VRAM和RAM中的专家模块1,2。这样就消除了输入阶段的I/O瓶颈。作为参考,在RTX 4070 SUPER 12GB和32GB RAM环境下,曾观测到19分钟内从SSD读取总计2.2TB数据的流式传输负载,这是直接流式传输模型权重而非交换内存(Swap)的结构导致的现象5。Resident-only Routing通过在提示词输入区间绕过这一结构特性来工作。
这种组合为何带来“20倍”的感知提升
整理数字可知,仅使用KV Splice即可将提示词处理时间从100秒缩减至26秒,实现约4倍加速1。在此基础上并行应用Resident-only Routing,进一步消除了输入阶段的SSD流式传输瓶颈,报告称整体智能体会话响应速度提升了20倍1。4倍与20倍之所以不同,是因为会话启动延迟的大部分由提示词输入占据,而该输入区间内部还叠加了缓存未命中和SSD流式传输这两层瓶颈1,2。只有同时解决这两层瓶颈,感知延迟才会急剧下降。
在实现阶段,该功能以STRATA_DS4_REORDER=1选项形式通过选择启用(opt-in)方式提供,在公开的测试分支中默认启用,并可通过STRATA_DS4_REORDER=0禁用2。这表明实验性技术已经以可应用于用户环境的形式,即基于环境变量的开关,部署到了生产环境中2。
家庭个人电脑也能实用化智能体的原因
此案例受到关注背景在于,在不依赖云的情况下,已具备使用本地智能体的环境。Strata引擎使消费者级硬件上DeepSeek V4.1 Flash的输出速度达到4~6 tok/s水平,并以RTX 5070等环境作为基准3。由于支持本地的OpenAI和Anthropic兼容API,OpenCode或Codex CLI等编码工具可直接连接到家庭个人电脑上的模型3。
即智能体框架不变,仅优化本地推理引擎的输入阶段,就能改善会话感知速度。Strata兼容Qwen3.8-Flash-Next等多种轻量化模型,提供了在家庭个人电脑上构建智能体的环境3。无需等待云API调用,而是从本地主机返回响应的结构已经成立,这一点与本次优化的切入点相契合。
该技术遗留的近似性质与验证范围
这种优化并非准确复制运算本身,而是通过移动缓存进行复用的近似方法。复用的令牌包含了被删除文本的上下文进行计算,具有移动后的行被放置在系统提示词尾部之后的近似特性2。由于RoPE间隔导致位置值产生跳跃,且对齐过程可能会增加主机负载,这一点也被明确指出2。路由变更可能导致回答发生细微变化,这一局限性也被指出1。
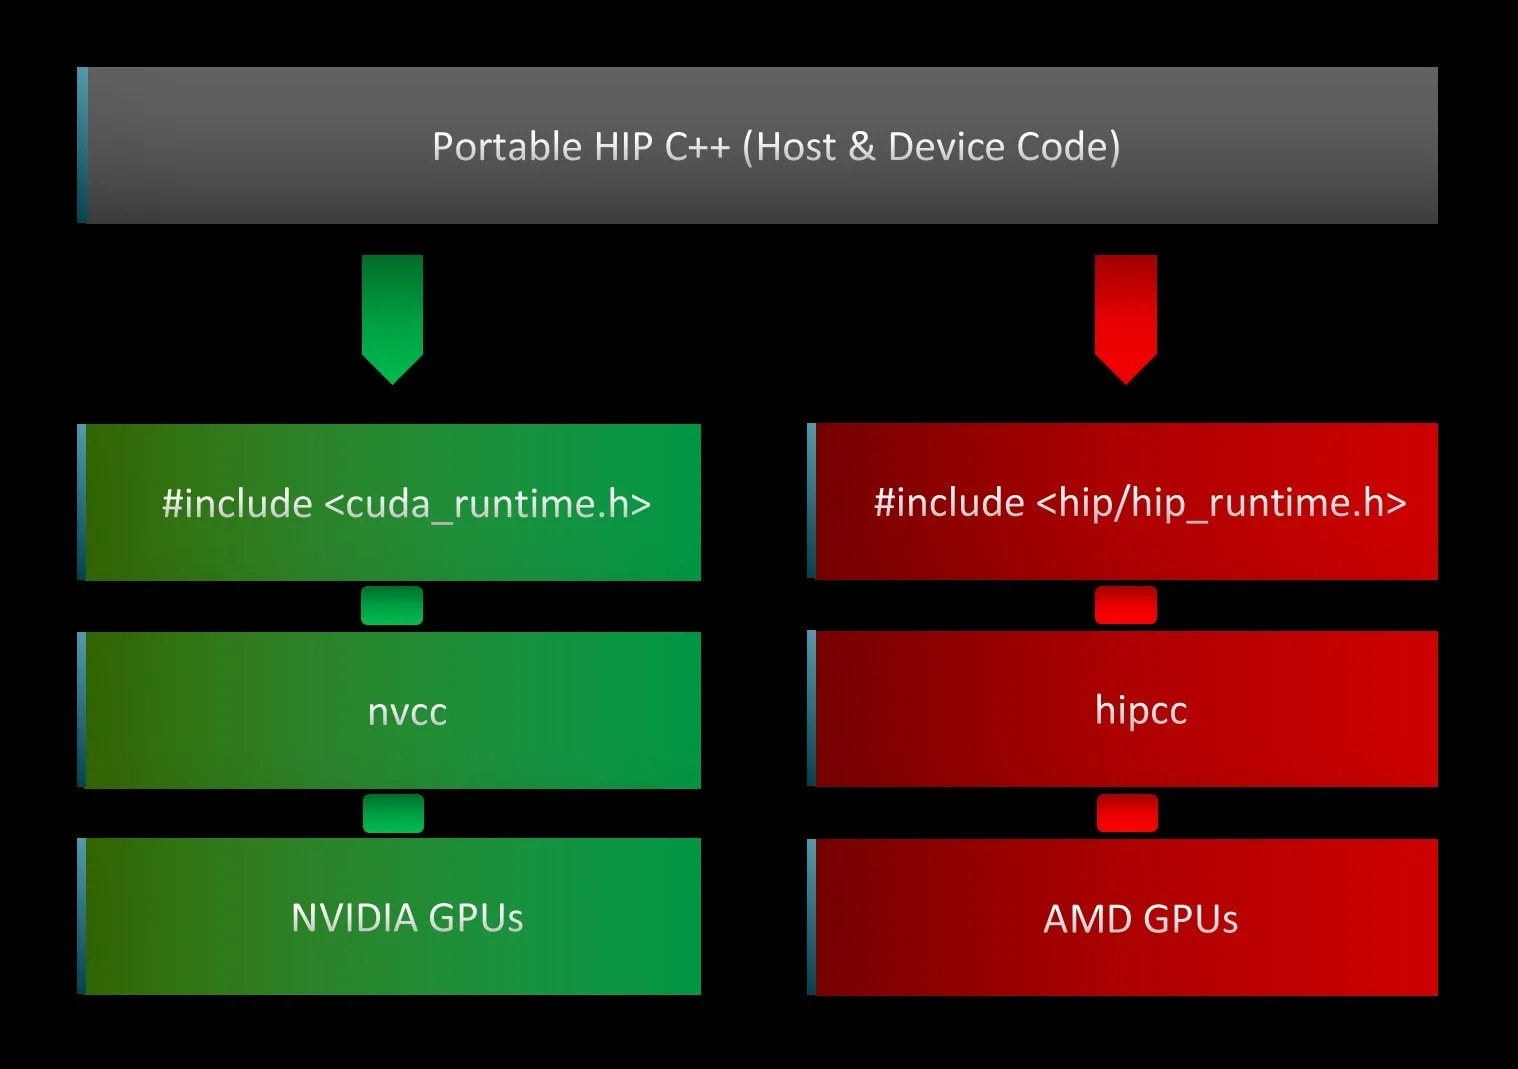
验证范围也仅限于当前状态。此补丁专用于HIP (gfx1201) 平台,仅在RX 9070 XT和ROCm环境中通过HIP构建进行了验证,CUDA、SYCL、Metal构建以及C++测试套件的验证尚未完成1,2。因此,“20倍”这一数值是在经过验证的硬件和平台条件下报告的结果,不应被视为适用于所有本地环境的保证1,2。
改变智能体速度优化视角的启示
让家庭个人电脑上的LLM智能体变快的视角,并不仅仅在于购买更快的GPU。如何复用已计算的KV Cache,以及在输入阶段如何阻止不必要的SSD流式传输,被指定为会话启动延迟的主导变量1,2。KV Splice将37K令牌的重处理转变为36,097个令牌的复用,使提示词区间缩短4倍1,2;Resident-only Routing通过路由在输入期间仅使用VRAM和RAM中加载的专家,消除了SSD瓶颈1,2。当在家庭游戏GPU组合中同时应用这两种技术时,就形成了从100秒降至26秒,即会话感知加速20倍的案例1。
最终,“无需数据中心”这一条件并非承认硬件局限的前提,更接近于可以通过设计绕过输入阶段瓶颈(如缓存复用和路由控制)的前提。如果要在本地使用像OpenCode这样顶部提示词频繁变化的智能体,这两项技术所涉及的区间——缓存未命中和流式传输瓶颈——将成为速度优化的实际起点。虽然这一在HIP和ROCm环境中验证的案例,留下了后续验证其在扩展到CUDA等其他构建时是否维持同等收益的课题2,但作为将看待本地智能体速度的视角从“推理速度”转移到“输入瓶颈”的起点,它已绰绰有余。



