Si un agente LLM que se ejecuta en un PC doméstico tuviera que esperar 100 segundos antes de emitir la primera palabra, resultaría difícil garantizar que fuera realmente utilizable en la práctica. Sin embargo, se reportó el 2 de noviembre de 2026 un caso en el que, sin depender de centros de datos ni de la nube, utilizando únicamente una GPU estándar de juegos y memoria común, este tiempo de espera se redujo a 26 segundos, aumentando la velocidad percibida de las sesiones del agente en un factor de 20 1.
La clave no estaba en hacer los cálculos más rápidos, sino en no descartar y reutilizar los resultados ya calculados. Las dos técnicas aplicadas al motor Strata, «KV Splice» y «Resident-only Routing», se demostraron eficaces para eliminar cuellos de botella, especialmente en entornos de agentes de programación donde los prompts del sistema sufren cambios frecuentes 1, 2. En este artículo se examina detalladamente en qué hardware y bajo qué principios se logró eliminar esta latencia.
El cuello de botella no estaba en la «inferencia», sino en el «reprocesamiento del prompt»
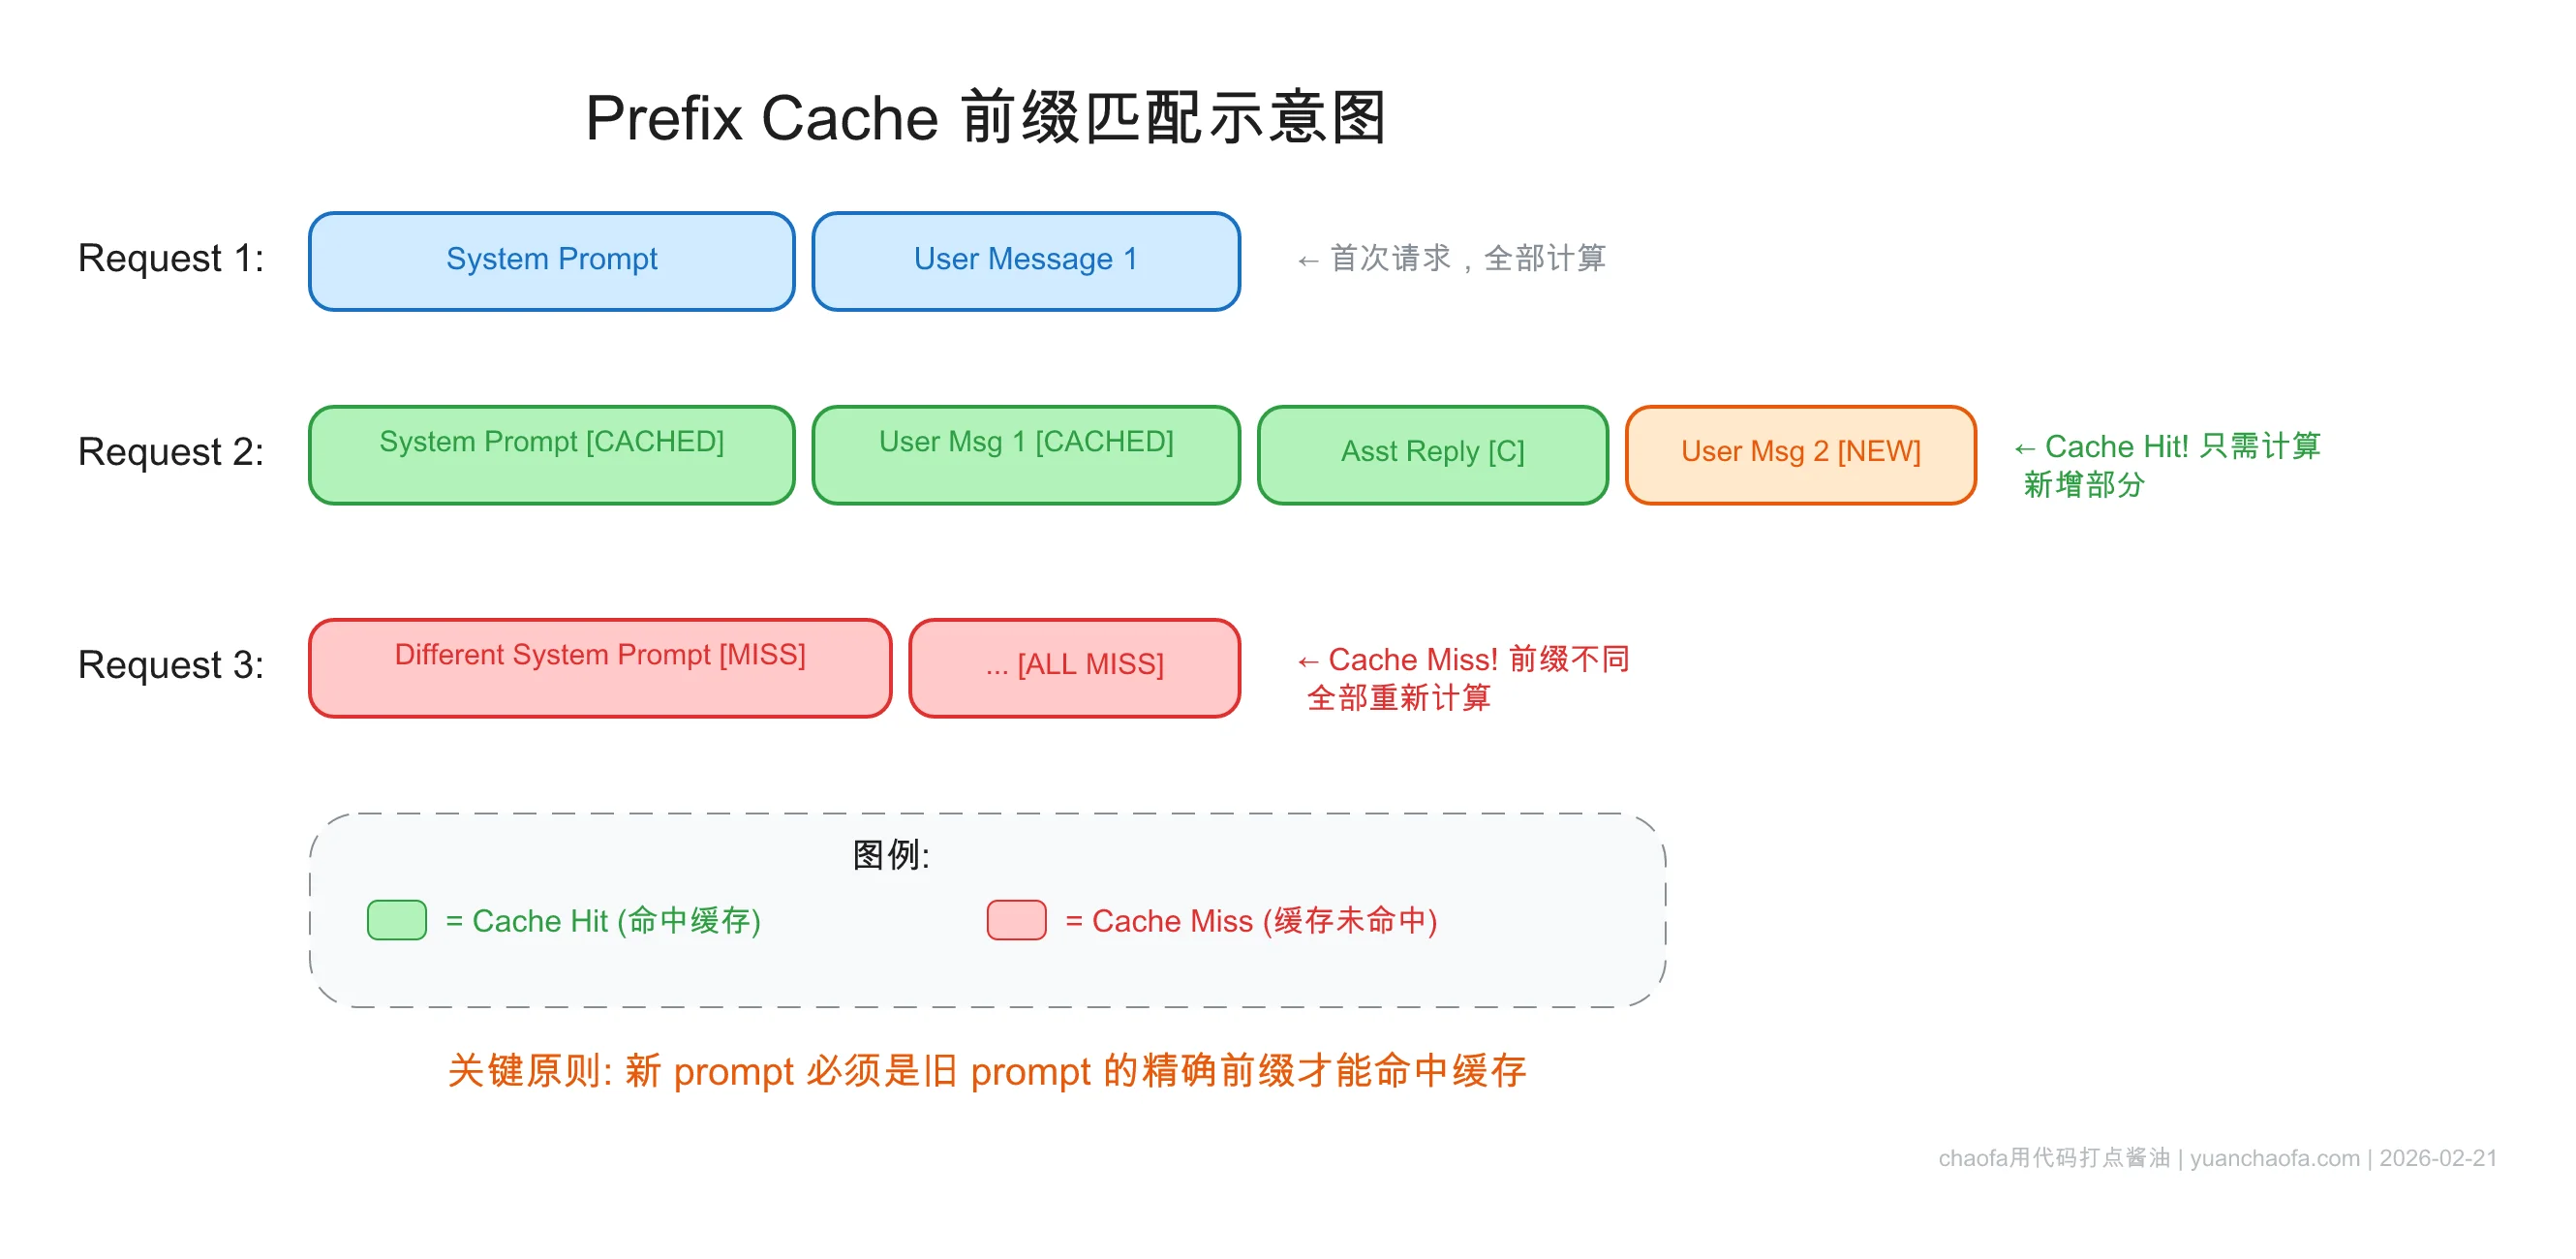
Cuando sentimos que un agente LLM es lento, solemos pensar inmediatamente en la velocidad de generación de tokens, es decir, en la velocidad de inferencia. Sin embargo, el cuello de botella observado en los entornos del proyecto Strata y del agente OpenCode no estaba en la inferencia, sino en la fase de entrada del prompt 1, 2.
El agente de programación OpenCode inserta información contextual, como el directorio de trabajo, la fecha actual y el estado de Git, al principio del prompt del sistema cada vez que se abre una nueva sesión 2. Esta información cambia ligeramente cada vez, lo que provoca frecuentes fallos de caché de prefijos (Prefix Cache Miss) 1, 2. Cuando la caché falla, el modelo debe volver a leer incluso contenido que ya conocía. En las mediciones reales, el prompt del sistema en el entorno OpenCode alcanzaba aproximadamente 37.000 tokens, y en cada sesión se repetía un retraso por reprocesamiento de estos 37.000 tokens, debido a la necesidad de volver a procesar la totalidad 1, 2.
Como resultado, el tiempo hasta que aparecía el primer token se disparó a unos 100 segundos 1, 2. En un PC doméstico compuesto por una tarjeta gráfica RX 9070 XT, una CPU Ryzen 5800X3D, 64 GB de memoria DDR4 y una SSD NVMe PCIe 3.0, el tiempo de procesamiento del prompt del modelo DeepSeek V4.1 Flash registró unos 100 segundos 1. Esta fase no es la parte donde se «genera» realmente el modelo de gran escala, sino la parte donde se actualiza el contexto ya leído, lo que clarifica la naturaleza del problema.
KV Splice: Leer solo las líneas modificadas en lugar de recalcular todo
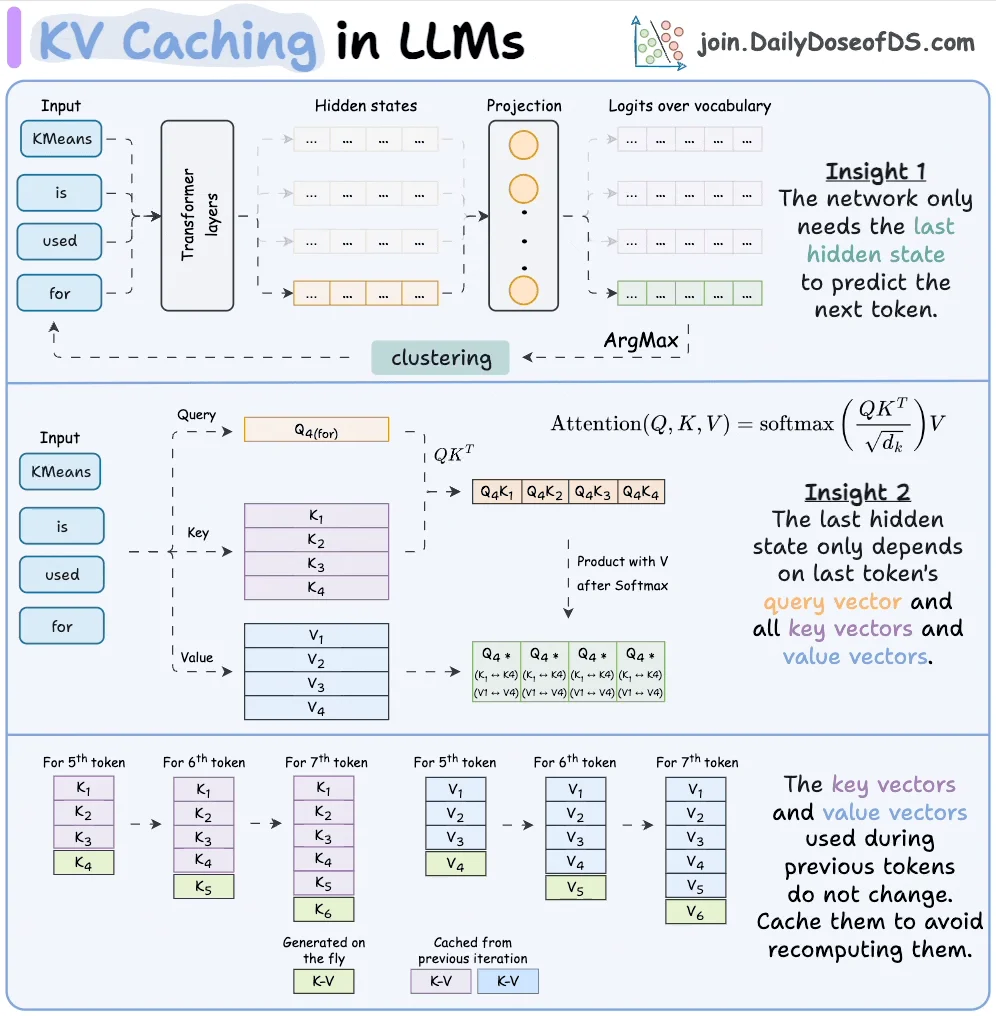
La primera técnica que resolvió este cuello de botella es KV Splice. Este método analiza el estado de la caché KV calculado previamente en la sesión anterior y solo lee las líneas del prompt que han cambiado 1, 2. Es decir, en lugar de volver a leer desde el principio los 37.000 tokens completos, mantiene viva la caché reutilizable y procesa de manera incremental únicamente las partes que han cambiado.
Según el modo de operación propuesto, el motor alinea el estado interno del modelo y la conversación mantenida en ejecuciones de tokens de 32 unidades para seleccionar la ruta de máxima reutilización 2. Cuando la conversación no es continua, las líneas eliminadas del estado mantenido se recortan, y las filas de origen y la ventana deslizante posterior se ajustan 2. En este momento, se registra el intervalo de RoPE (rope_off) para manejar los saltos en los valores de posición, y esta tabla de eliminación se guarda en el espacio reservado (slot) con un trailer DS4CUTS1 2. Mediante estos intervalos de RoPE, se desplazan las filas en caché para lograr una reutilización aproximada 1.
Como resultado de aplicar esta técnica, el tiempo de procesamiento del prompt se redujo de aproximadamente 100 segundos a 26 segundos 1. Esto representa una aceleración de unas 4 veces, lograda mediante la reutilización de 36.097 tokens 1, 2. En pruebas de sesiones sintéticas simples, la tasa de reutilización de tokens en la segunda sesión superó el 99%, la respuesta se obtuvo en unos 10 segundos, y se demostró la eficiencia al reutilizar 53.080 tokens en el procesamiento continuo de una conversación de 54.000 tokens 2. Que el procesamiento del prompt sea 4 veces más rápido se tradujo en una mejora de 20 veces en la velocidad percibida de la sesión del agente porque la mayor parte del tiempo de espera estaba concentrada precisamente en esta etapa de entrada 1.
Resident-only Routing: Eliminar el cuello de botella de streaming SSD durante la lectura del prompt
La segunda técnica es «Resident-only Routing». Esta técnica dirige el enrutamiento (routing) para que, durante la lectura del prompt, se utilicen prioritariamente solo los expertos (Experts) que ya están cargados en la VRAM y la RAM, aplicándose en paralelo con KV Splice 1, 2.
Strata utiliza un método que transmite directamente desde el SSD aquellos modelos que no caben en la memoria 3, 4. Los modelos de gran escala como DeepSeek V4.1 requieren más de 250 GB de espacio en disco, y los datos que no caben en la memoria se leen desde el SSD 3, 4. El problema era que este streaming se producía innecesariamente durante la fase de lectura del prompt. En el método tradicional, surgía un cuello de botella por streaming masivo desde el SSD incluso mientras se leía el prompt; de hecho, se reportó una situación en la que se transmitieron 58 GB desde el SSD para procesar un prompt pequeño 1.
Resident-only Routing suprime el streaming desde el SSD durante la fase de lectura del prompt y obliga a utilizar únicamente los módulos expertos ya cargados en VRAM y RAM 1, 2. De esta forma, se elimina el cuello de botella de E/S en la etapa de entrada. Para referencia, en un entorno con RTX 4070 SUPER 12 GB y 32 GB de RAM, se observó una carga de streaming que leyó un total de 2,2 TB desde el SSD en 19 minutos, un fenómeno derivado de la estructura que transmite directamente los pesos del modelo en lugar de usar memoria de intercambio (swap) 5. Resident-only Routing funciona evitando esta característica estructural durante la sección de entrada del prompt.
Aritmética percibida: Cómo esta combinación condujo al factor «20 veces»
Resumiendo los números, solo con KV Splice, el procesamiento del prompt se redujo de 100 a 26 segundos, generando una aceleración de unas 4 veces 1. Al aplicarse además Resident-only Routing en paralelo, se eliminó adicionalmente el cuello de botella de streaming SSD en la etapa de entrada, y se reportó una mejora de 20 veces en la velocidad de respuesta de toda la sesión del agente 1. La razón por la que la cifra es 4 veces y no 20 veces, y luego 20 veces, es que una gran parte de la latencia de inicio de sesión la ocupaba la entrada del prompt, y dentro de esa sección de entrada había dos capas de cuellos de botella superpuestas: los fallos de caché y el streaming desde SSD 1, 2. Era necesario abordar ambas capas simultáneamente para que la latencia percibida cayera drásticamente.
En la etapa de implementación, se propuso bajo el esquema de activación opt-in con la opción STRATA_DS4_REORDER=1, aunque en la rama de pruebas pública está activada por defecto y puede desactivarse mediante STRATA_DS4_REORDER=0 2. Esto demuestra que la técnica experimental ya se ha desplegado en una forma aplicable a entornos de usuario reales, es decir, como un interruptor basado en variables de entorno 2.
Por qué los agentes son utilizables en la práctica incluso en un PC doméstico
El motivo por el que este caso ha llamado la atención es que se ha consolidado un entorno donde se pueden utilizar agentes locales sin depender de la nube. El motor Strata permite ejecutar DeepSeek V4.1 Flash a velocidades de salida de 4-6 tok/s en hardware de consumo, presentando como punto de referencia entornos con RTX 5070 3. Dado que admite API compatible con OpenAI y Anthropic a nivel local, herramientas de programación como OpenCode o Codex CLI se conectan directamente a modelos alojados en PCs domésticos 3.
Es decir, el framework del agente no cambia, y optimizar únicamente la etapa de entrada del motor de inferencia local mejora la velocidad percibida de la sesión. Strata es compatible con diversos modelos ligeros como Qwen3.8-Flash-Next, ofreciendo un entorno donde se pueden construir agentes en PC domésticos 3. El hecho de que ya exista una estructura donde las respuestas provienen del host local en lugar de esperar llamadas a una API en la nube coincide perfectamente con el punto de aplicación de esta optimización.
Naturaleza aproximada de la técnica y alcance de su validación
Esta optimización no replica exactamente los cálculos, sino que utiliza un enfoque aproximado que desplaza la caché para reutilizarla. Los tokens reutilizados se calculan incluyendo el contexto del texto eliminado, y presentan la característica aproximada de que las líneas desplazadas se sitúan después del final del prompt del sistema 2. También se especificó que los intervalos de RoPE provocan saltos en los valores de posición y que la carga del host podría aumentar durante el proceso de alineación 2. Asimismo, se señaló como límite que los cambios en el enrutamiento podrían alterar sutilmente las respuestas 1.
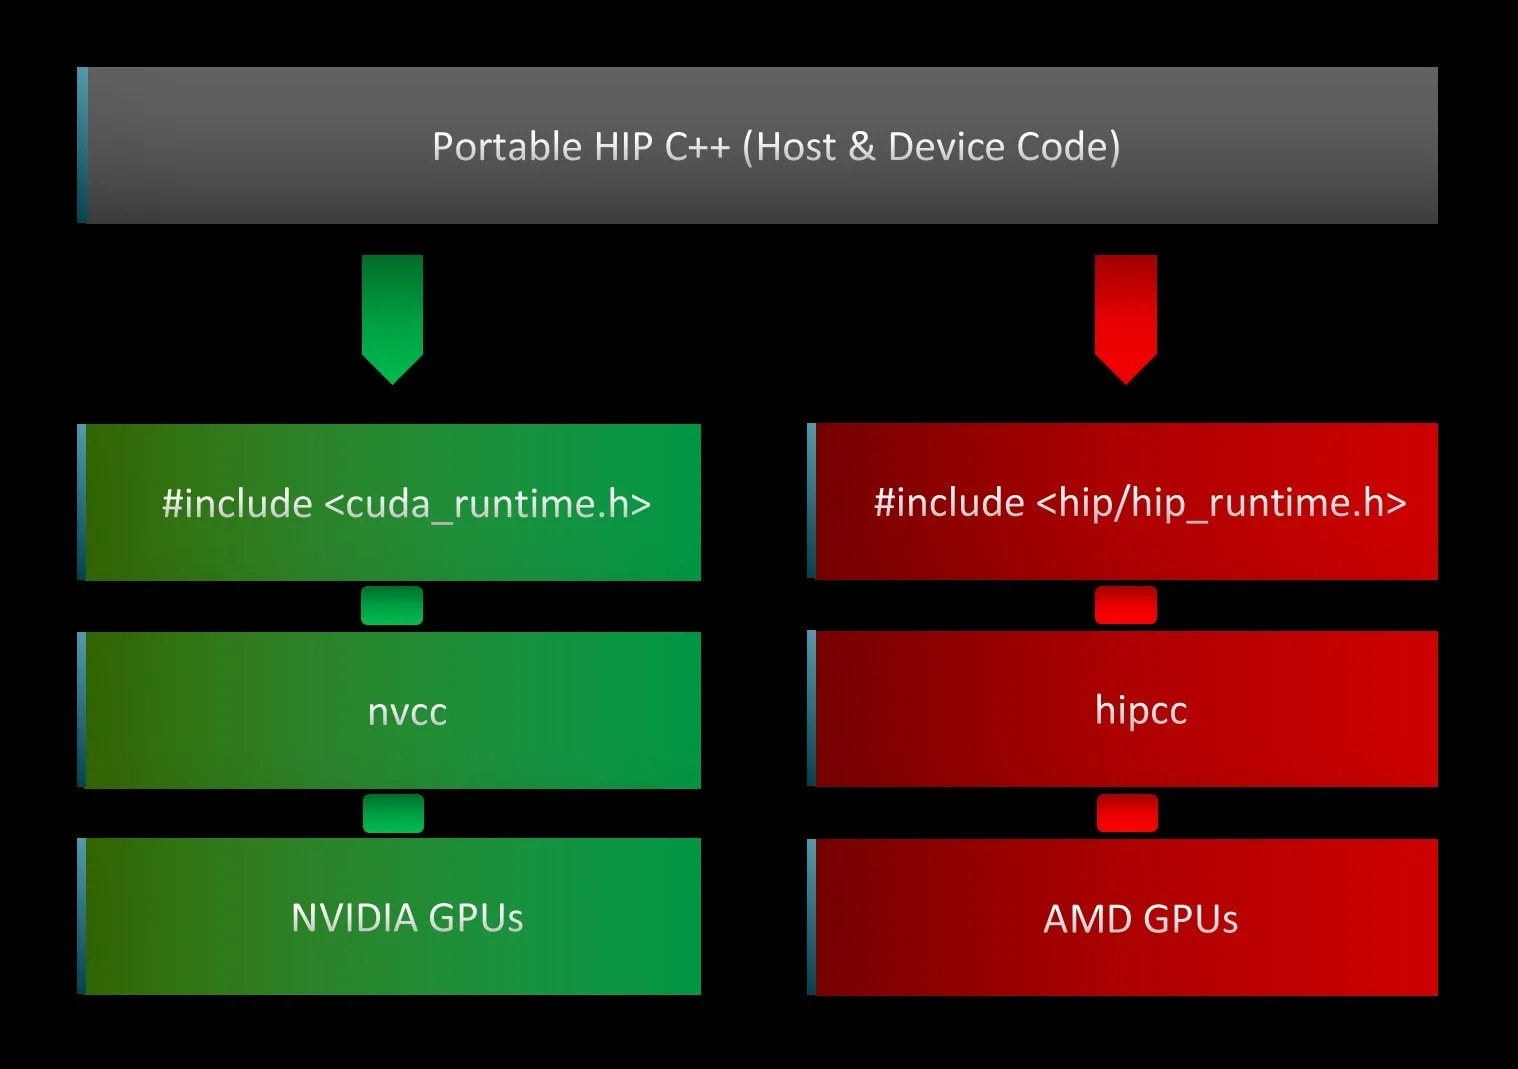
El alcance de la validación también se limita al estado actual. Este parche está diseñado exclusivamente para la plataforma HIP (gfx1201) y se validó mediante una compilación HIP en entornos RX 9070 XT y ROCm; la validación en compilaciones CUDA, SYCL, Metal y en la suite de pruebas C++ aún no se ha completado 1, 2. Por lo tanto, la cifra de «20 veces» es un resultado reportado bajo las condiciones específicas de hardware y plataforma validadas, y no debe interpretarse como una garantía aplicable uniformemente a todos los entornos locales 1, 2.
Implicaciones que cambian la perspectiva sobre la mejora de la velocidad de los agentes
La perspectiva para hacer que un agente LLM sea rápido en un PC doméstico no se limita únicamente a comprar una GPU más potente. Se ha identificado que la variable dominante para la latencia de inicio de sesión es cuánto se reutiliza la caché KV ya calculada y cuánta capacidad hay para evitar el streaming innecesario desde el SSD en la etapa de entrada 1, 2. KV Splice convirtió el reprocesamiento de 37.000 tokens en la reutilización de 36.097 tokens, reduciendo la sección de procesamiento de prompts en un factor de 4 1, 2, y Resident-only Routing dirigió el enrutamiento para usar solo los expertos cargados en VRAM y RAM durante la entrada, eliminando el cuello de botella del SSD 1, 2. Al aplicar juntas estas dos técnicas en una combinación de GPU de juegos doméstica, se hizo viable el caso de una aceleración percibida de 20 veces en la sesión, pasando de 100 a 26 segundos 1.
En última instancia, la condición «sin centros de datos» no es una premisa que acepte las limitaciones del hardware, sino más bien una premisa de que los cuellos de botella en la etapa de entrada se pueden evitar mediante el diseño, como en el reuso de caché y el control del enrutamiento. Si se utilizan localmente agentes cuyo inicio del prompt cambia frecuentemente, como OpenCode, las secciones que abordan estas dos técnicas —los fallos de caché y los cuellos de botella de streaming— se convierten en el verdadero punto de partida para la mejora de velocidad. Aunque este caso, validado en entornos HIP y ROCm, deja pendiente una verificación posterior sobre si los mismos beneficios se mantendrán al extenderse a otras compilaciones como CUDA 2, resulta suficiente como punto de partida para desplazar la perspectiva sobre la velocidad de los agentes locales desde la «velocidad de inferencia» hacia los «cuellos de botella de entrada».



