家庭用PCで動作するLLMエージェントが最初の単語を出力するまでに100秒も待たなければならないなら、その会話は実用性を確保しにくい。ところが、データセンターやクラウドなしで、一般的なゲーム用GPUと標準的なメモリだけで待ち時間を26秒まで短縮し、エージェントセッションの体感速度を20倍向上させた事例が2026年11月2日に報告された1。
その鍵は、演算をより高速にすることではなく、すでに演算した結果を廃棄せず再利用することにあった。Strataエンジンに適用された「KV Splice」と「Resident-only Routing」という2つの手法は、特にシステムプロンプトが頻繁に変更されるコーディングエージェント環境において、ボトルネックを解消する手段として検証された1, 2。本稿では、この事例がどのハードウェアで、どのような原理により遅延を除去したのか具体的に確認する。
ボトルネックは「推論」ではなく「プロンプト再処理」にあった
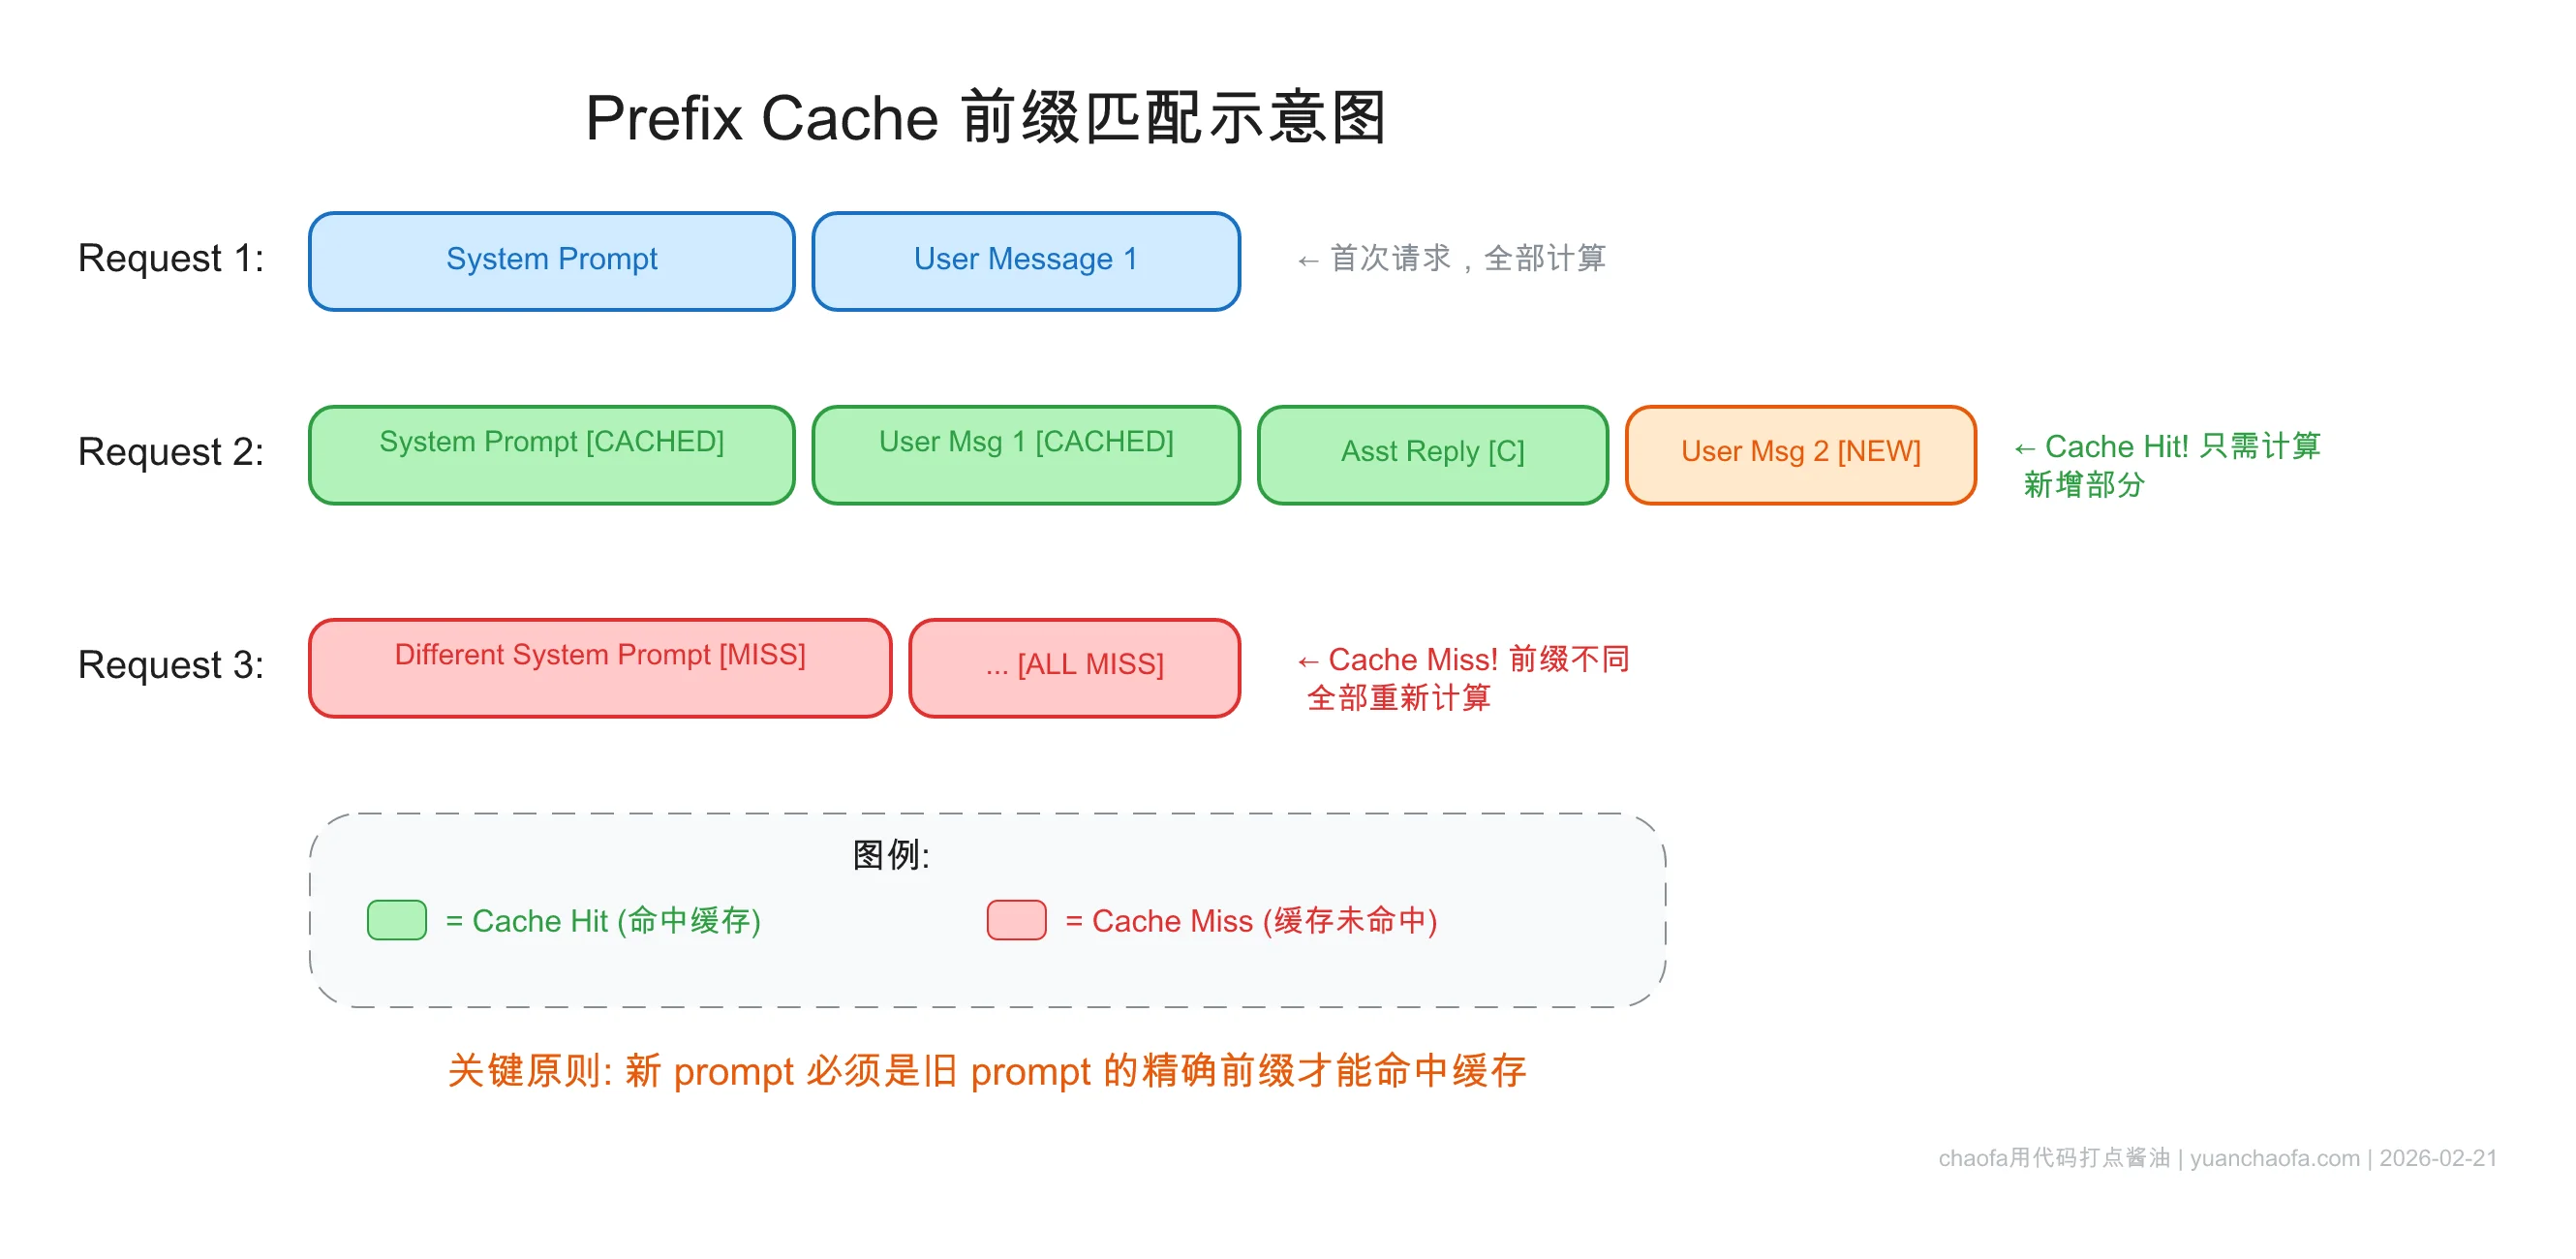
LLMエージェントが遅く感じられるとき、通常はトークンが生成される速度、すなわち推論速度を思い浮かべる。しかし、StrataプロジェクトとOpenCodeエージェント環境で観測されたボトルネックは推論ではなく、プロンプト入力段階にあった1, 2。
コーディングエージェントのOpenCodeは、セッションが開始されるたびにシステムプロンプトの先頭に、作業ディレクトリ、現在の日付、Gitの状態といったコンテキスト情報を挿入する2。この情報は毎回少しずつ異なるため、プレフィックスキャッシュミス(Prefix Cache Miss)が頻繁に発生する1, 2。キャッシュが無効化されると、モデルはすでに知っている内容まで新たに読み込む必要がある。実際の測定では、OpenCode環境のシステムプロンプトは約37Kトークンに達しており、毎セッションごとにこの全量を再処理するために約37Kトークンの再処理遅延が繰り返されていた1, 2。
その結果、最初のトークンが出力されるまでの時間は約100秒水準まで跳ね上がった1, 2。RX 9070 XTグラフィックカード、Ryzen 5800X3D CPU、DDR4 64GBメモリ、PCIe 3.0 NVMe SSDで構成された家庭用PCにおいて、DeepSeek V4.1 Flashモデルのプロンプト処理時間は約100秒を記録した1。この段階は大規模モデルを実際に「生成」する区間ではなく、すでに読み込んだコンテキストを新たに更新する区間であるという点で、問題の性質が明確に現れている。
KV Splice: 全体の再計算の代わりに、変更された行のみを読み込み
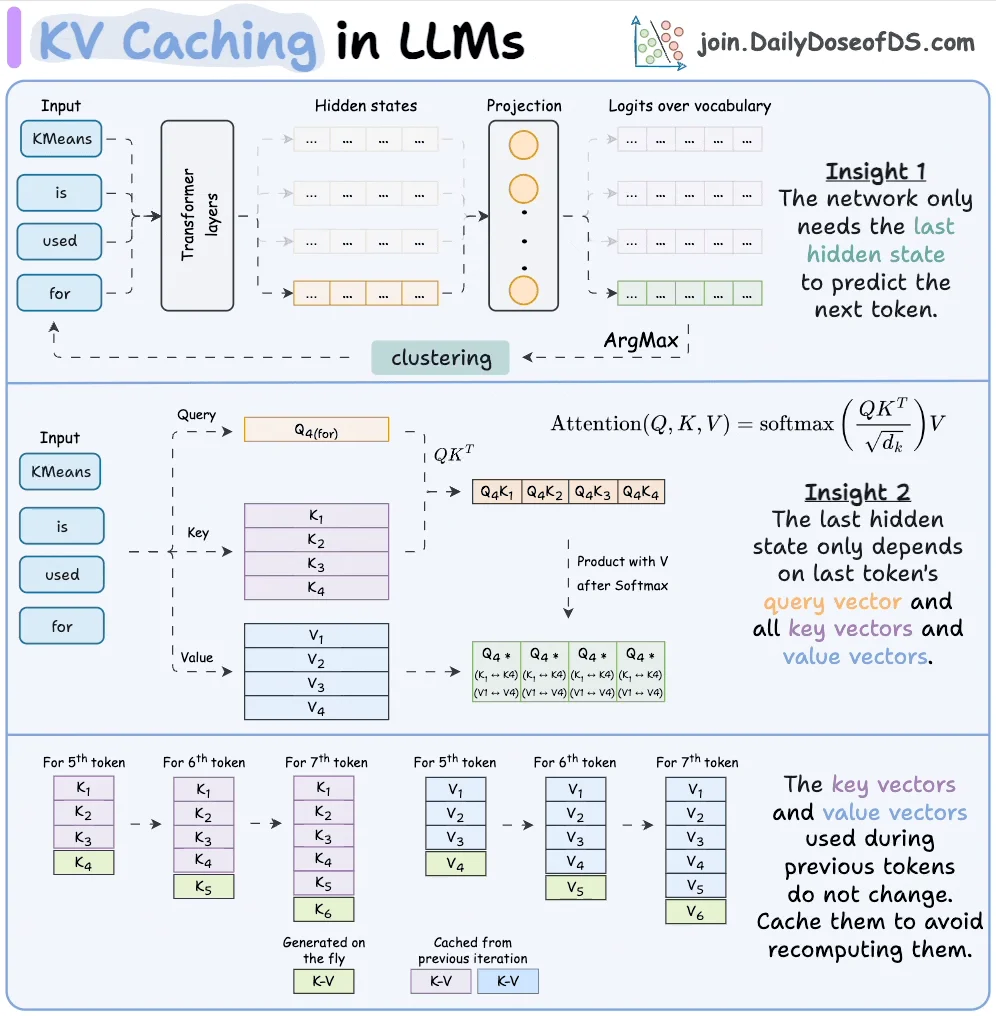
このボトルネックを解消した最初の手法がKV Spliceである。既存セッションで既に計算されたKVキャッシュ状態を解析し、プロンプトの変更された行のみを読み込む方式だ1, 2。つまり、37Kトークン全体を最初から読み直す代わりに、再利用可能なキャッシュを保持したまま、変化した部分のみを差分処理するのだ。
提案された動作方式によれば、エンジンはモデル内の状態と維持されている会話を32トークン単位のトークンランに整列させ、最大再利用パスを選択する2。会話が連続していない場合、維持された状態の削除された行は切り離され、以降のソース行とウィンドウリングが調整される2。この際、位置値のジャンプを処理するためにRoPE間隔(rope_off)が記録され、この削除テーブルはスロットにDS4CUTS1トレーラーとして保存される2。RoPE間隔を通じてキャッシュされた行を移動させることで、近似的な再利用を実現しているわけだ1。
この方式を適用した結果、プロンプト処理時間は約100秒から26秒へ短縮された1。これは約4倍の高速化であり、36,097トークンを再利用する形で達成された数値である1, 2。単純な合成セッションテストでは、2番目のセッションのトークン再利用率が99%以上を記録し、約10秒で応答した。また、5万4千トークンの会話の後続処理において53,080トークンを再利用する効率を実証した2。プロンプト処理が4倍高速になったことがエージェントセッションの体感速度20倍向上につながったのは、待ち時間の大部分がこの入力段階に集中していたためである1。
Resident-only Routing: プロンプト読み込み時のSSDストリーミングボトルネックを除去
2番目の手法は「Resident-only Routing」である。この手法は、プロンプト読み込み時にVRAMとRAMに既にロードされている専門家(Expert)のみを優先的に使用するようにルーティングする方式で、KV Spliceと並行して適用された1, 2。
Strataはメモリに載せきれないモデルをSSDから直接ストリーミングする方式を採用している3, 4。DeepSeek V4.1のような大規模モデルは250GB以上のディスク容量を要求し、メモリに収まらないデータはSSDから読み込まれる3, 4。問題は、このストリーミングがプロンプト読み込み区間で不必要に発生していた点にある。従来方式では、プロンプトを読み込んでいる間にもSSDから大容量をストリーミングするボトルネックが生じ、実際には小さいプロンプト処理に対してSSDから58GBをストリーミングしていた状況まで報告されている1。
Resident-only Routingは、プロンプト読み込み段階ではSSDストリーミングを抑制し、既にVRAMとRAMにロードされた専門家モジュールのみを使用することを強制する1, 2。これにより、入力段階のI/Oボトルネックが解消される。なお、RTX 4070 SUPER 12GBと32GB RAMの環境では、19分間にわたり合計2.2TBをSSDから読み込むストリーミング負荷が観測されたが、これはスワップではなく、モデルの重みを直接ストリーミングする構造に由来する現象である5。Resident-only Routingは、この構造的な特性をプロンプト入力区間で回避する形で動作する。
この組み合わせが「20倍」へつながった体感の算数
数値を整理すると、KV Spliceのみでプロンプト処理が100秒から26秒へ短縮され、約4倍の高速化が発生した1。これにResident-only Routingが並行適用されて入力段階のSSDストリーミングボトルネックが追加で除去されたことで、エージェントセッション全体の応答速度が20倍向上したと報告されている1。4倍と20倍が異なる理由は、セッション開始遅延の相当部分をプロンプト入力が占めており、その入力区間内部にもキャッシュミスとSSDストリーミングという2層のボトルネックが重複して存在していたためである1, 2。2つの層を同時に扱う必要がある構造であり、そうして初めて体感遅延が急激に低下した。
実装段階では、STRATA_DS4_REORDER=1オプションによるオプトイン方式で提案されており、公開されたテストブランチではデフォルトで有効になっており、STRATA_DS4_REORDER=0で無効化できる2。これは、実験的な手法が実際にユーザー環境へ適用可能な形、すなわち環境変数ベースのスイッチとして既に展開されていることを示している2。
家庭用PCでもエージェントを実用可能な理由
この事例が注目される背景には、クラウド依存なしでもローカルエージェントを利用できる環境が整っている点がある。Strataエンジンは、消費者向けハードウェアでDeepSeek V4.1 Flashの出力速度を4〜6 tok/s水準で実行可能にし、RTX 5070などの環境が基準点として提示されている3。ローカルでOpenAIおよびAnthropic互換APIをサポートしているため、OpenCodeやCodex CLIといったコーディングツールが家庭用PCのモデルへそのまま接続される3。
つまり、エージェントフレームワークは変更せず、ローカル推論エンジンの入力段階のみを最適化してもセッションの体感速度は改善される。StrataはQwen3.8-Flash-Nextなど多種多様な軽量化されたモデルと互換性があり、家庭用PCでエージェントを構築できる環境を提供する3。クラウドAPI呼び出しを待つのではなく、ローカルホストから応答が返ってくる構造は既に成立しており、これが今回の最適化の適用地点と合致する。
手法が残した近似性質と検証範囲
この最適化は、演算そのものを正確に複製する方式ではなく、キャッシュを移動させて再利用する近似アプローチである。再利用されたトークンは、削除されたテキストのコンテキストを含めて計算され、移動された行がシステムプロンプト末尾の後に配置されるという近似特性を持つ2。RoPE間隔により位置値にジャンプが発生し、整列処理中にホスト負荷が増加する可能性があることも明示されている2。ルーティング変更に伴い、回答がわずかに異なる可能性がある点も限界として指摘されている1。
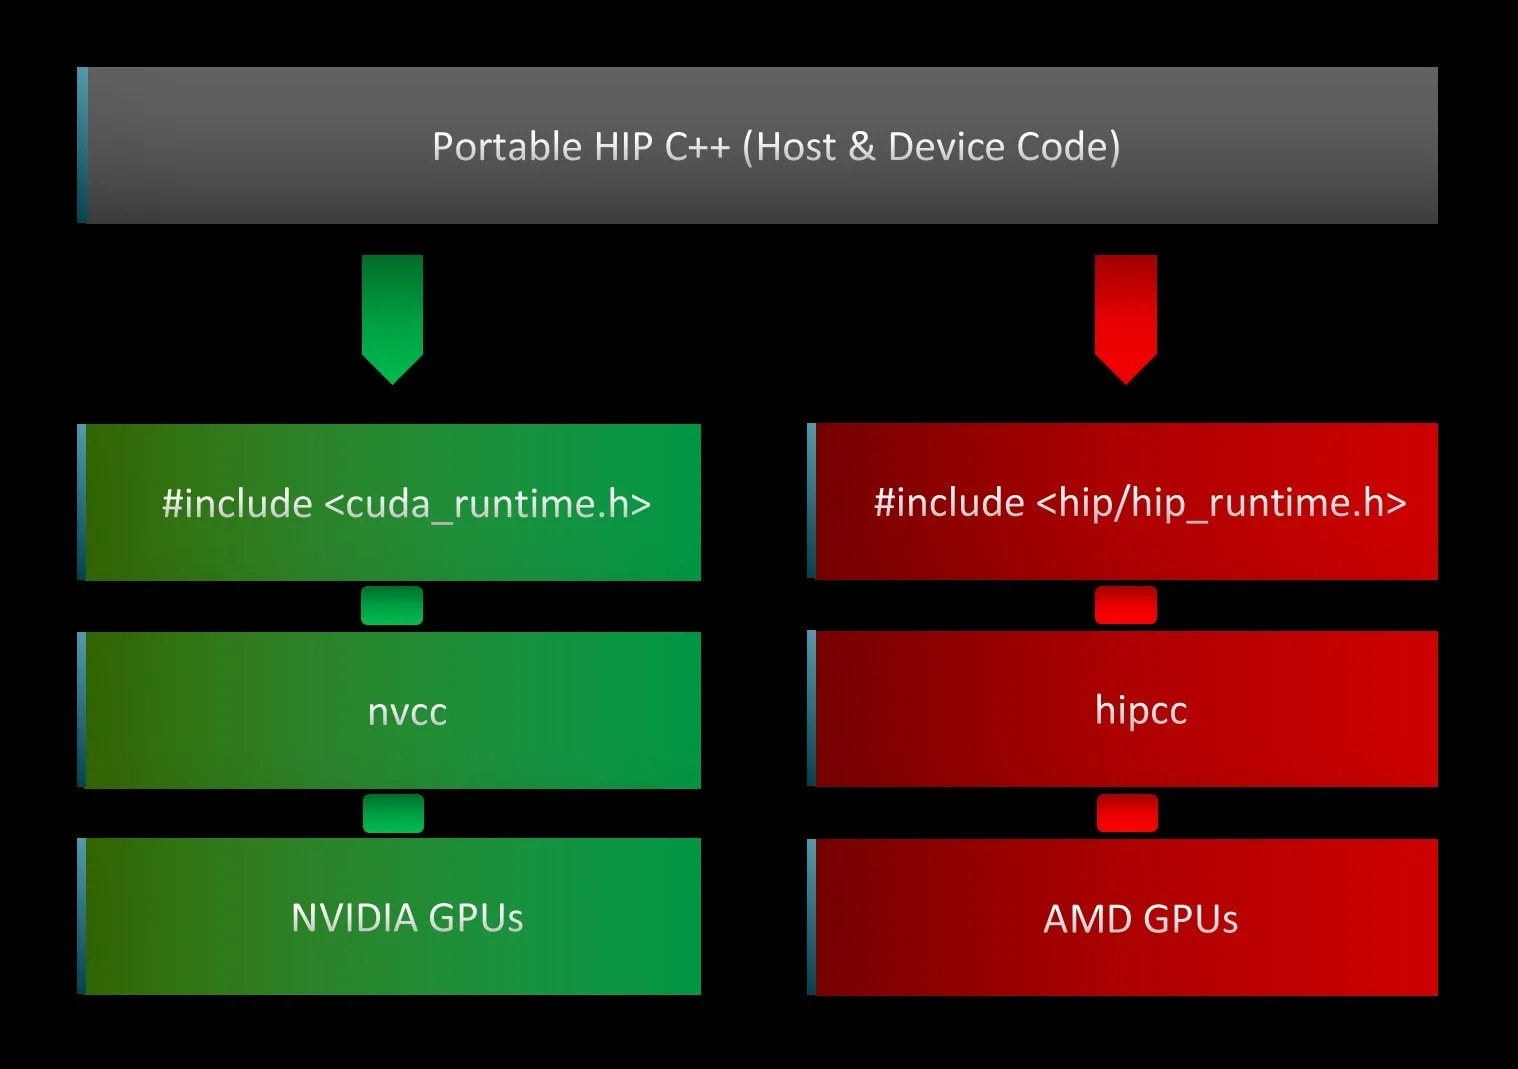
検証範囲も現段階では限定的である。このパッチはHIP(gfx1201)プラットフォーム専用で、RX 9070 XTとROCm環境においてHIPビルドで検証されたが、CUDA、SYCL、MetalビルドおよびC++テストスイートの検証はまだ完了していない1, 2。したがって、「20倍」という数値は、当該検証済みのハードウェアとプラットフォーム条件で報告された結果であり、すべてのローカル環境へ一律に適用される保証として受け取ってはいけない1, 2。
エージェントの速度改善における視点を変える示唆
家庭用PCでLLMエージェントを高速化する視点は、より高速なGPUを購入することだけに留まらない。既に計算されたKVキャッシュをどれだけ再利用するか、そして入力段階で不要なSSDストリーミングをどれだけ抑え込めるかが、セッション開始遅延を支配する変数として指摘された1, 2。KV Spliceは、37Kトークンの再処理を36,097トークンの再利用へと変換し、プロンプト区間を4倍短縮した1, 2。Resident-only Routingは、入力中にVRAMとRAMへロードされた専門家のみを使用するようにルーティングすることで、SSDボトルネックを解消した1, 2。これら2つの手法を家庭用ゲーミングGPU構成で併用したとき、100秒から26秒へ、すなわちセッション体感速度20倍向上という事例が成立したのだ1。
結局のところ、「データセンターなし」という条件は、ハードウェアの限界を認める前提ではなく、キャッシュ再利用やルーティング制御のように、入力段階のボトルネックを設計で回避できるという前提に近い。OpenCodeのようにプロンプト上部が頻繁に変わるエージェントをローカルで利用するなら、この2つの手法が対象とする区間、すなわちキャッシュミスとストリーミングボトルネックこそが、速度改善の実際の出発点となる。HIPとROCm環境で検証されたこの事例は、CUDAなど他のビルドへ拡張された際に同じ効果が維持されるかどうか、今後の追加検証を残しているが2、ローカルエージェントの速度を捉える視点を「推論速度」から「入力ボトルネック」へ転換する出発点としては十分である。



