가정용 PC에서 동작하는 LLM 에이전트가 첫 단어를 뱉어내기까지 100초를 기다려야 한다면, 그 대화는 실사용을 담보하기 어렵습니다. 그런데 데이터를센터나 클라우드 없이 일반 게임용 GPU와 표준 메모리만으로도 이 대기 시간을 26초까지 줄여, 에이전트 세션 체감 속도를 20배 높인 사례가 2026년 11월 2일 보고되었습니다 1.
핵심은 연산을 더 빠르게 하는 것이 아니라, 이미 연산한 결과를 버리지 않고 재사용하는 데 있었습니다. Strata 엔진에 적용된 'KV Splice'와 'Resident-only Routing' 두 가지 기법은, 특히 시스템 프롬프트가 잦은 변경을 수반하는 코딩 에이전트 환경에서 병목을 걷어내는 방식으로 검증되었습니다 1, 2. 이 글에서는 해당 사례가 어떤 하드웨어에서, 어떤 원리로 지연을 제거했는지 구체적으로 확인합니다.
병목은 '추론'이 아니라 '프롬프트 재처리'에 있었다
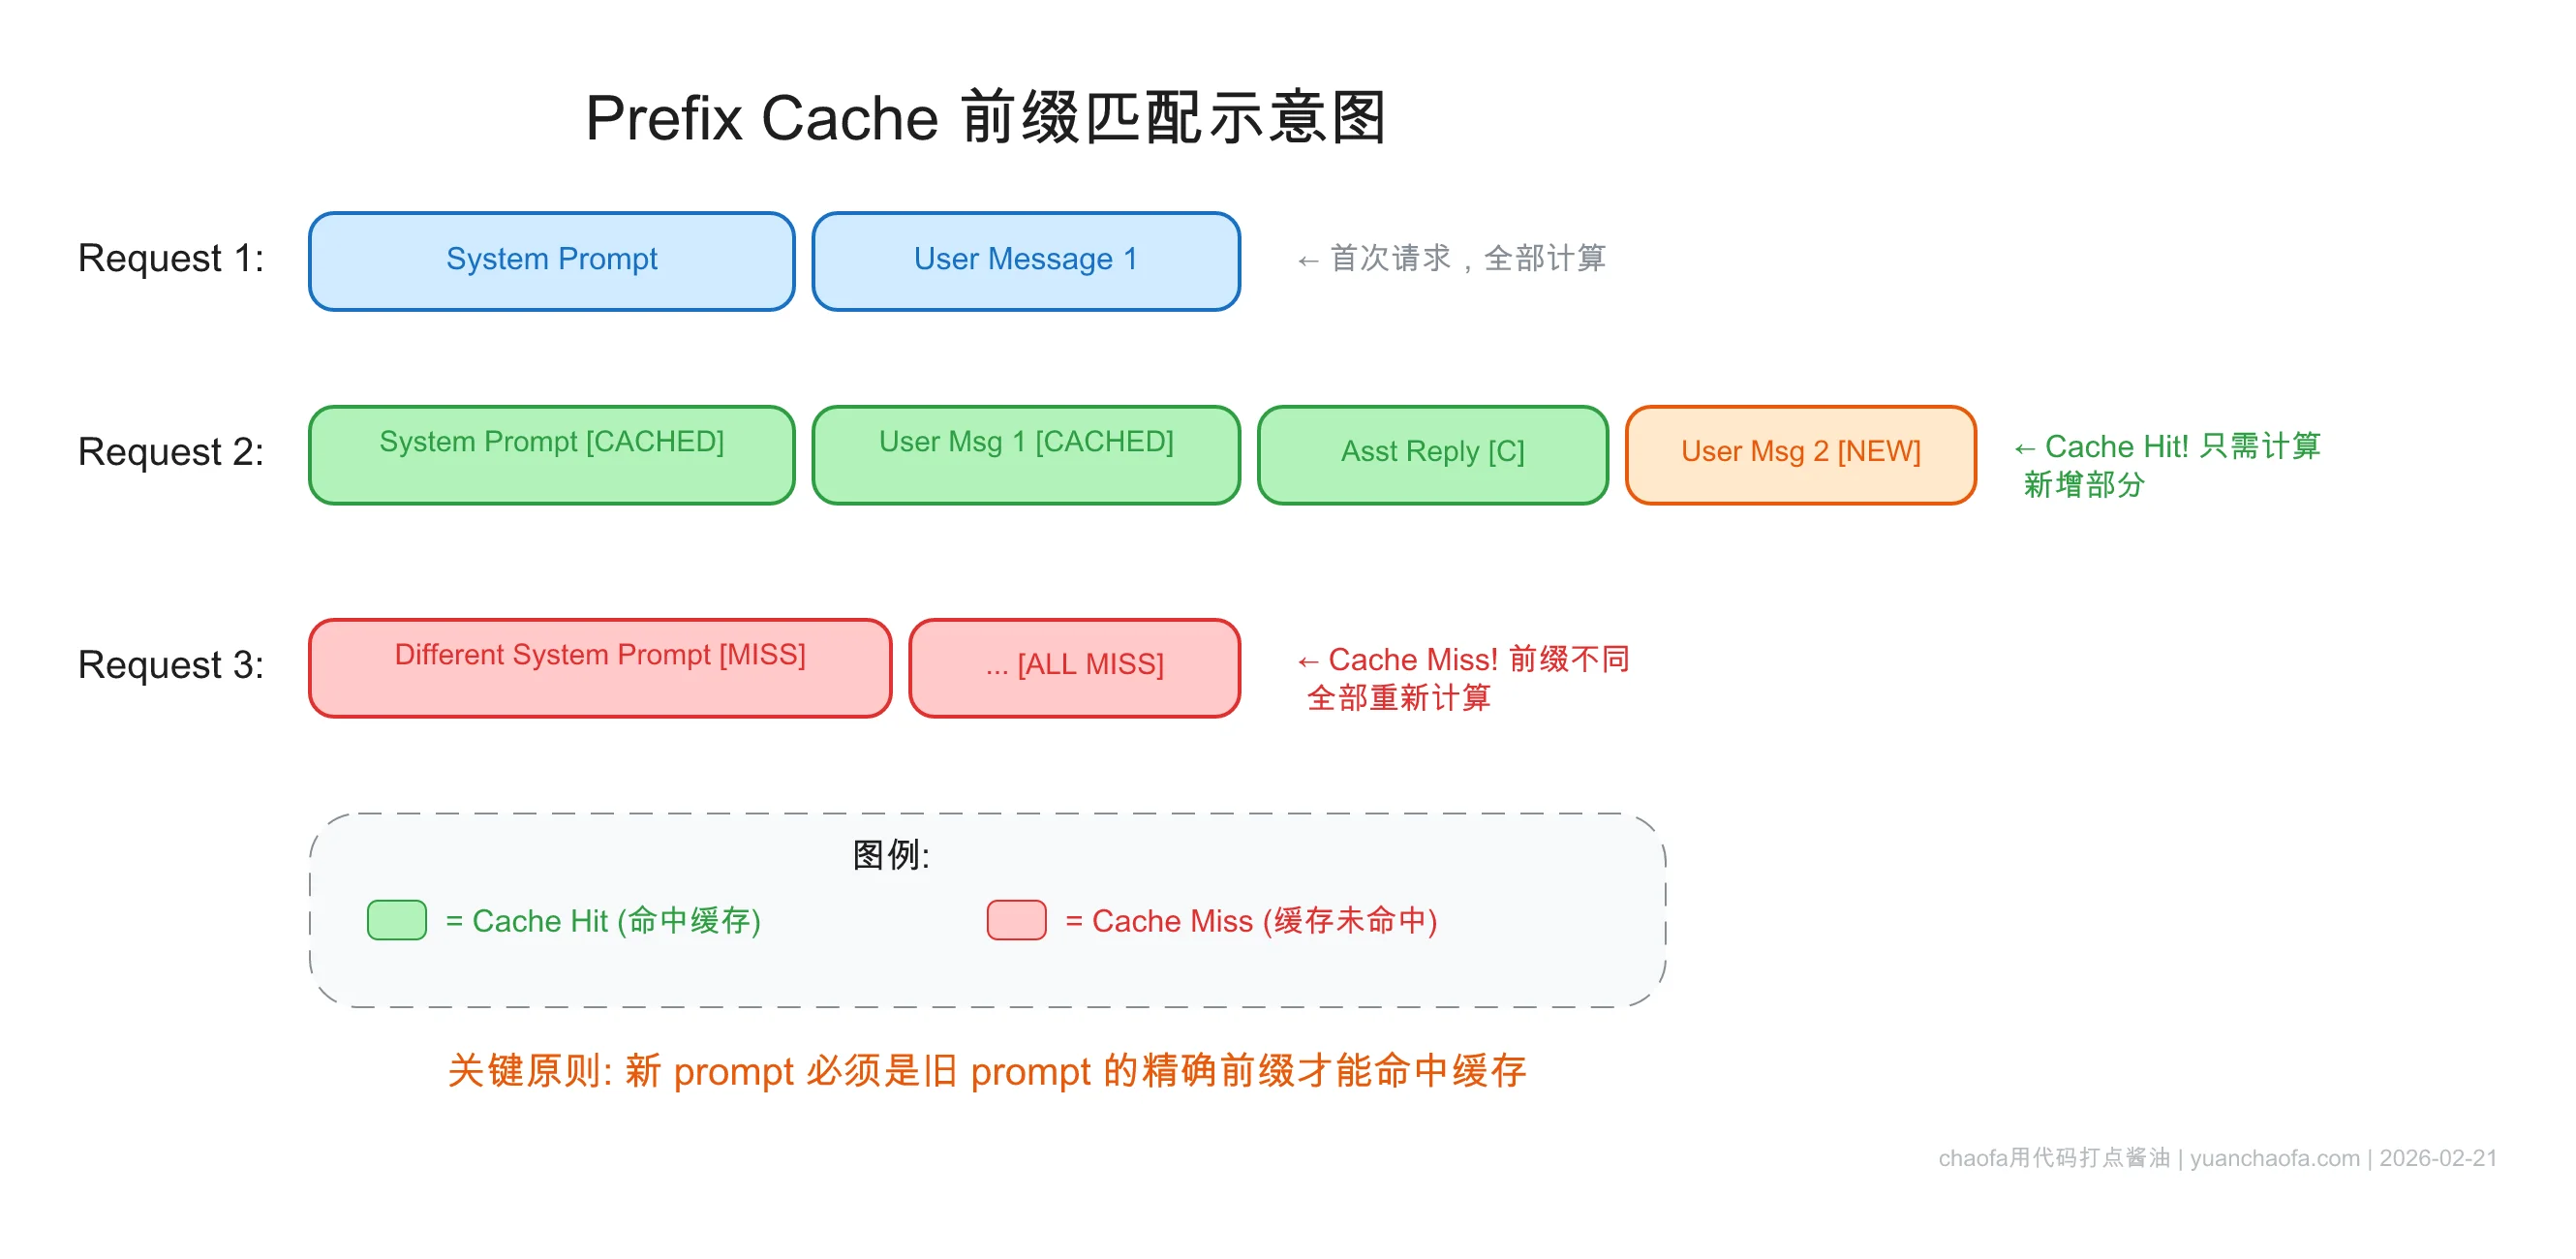
LLM 에이전트가 느리다고 느낄 때, 우리는 보통 토큰이 생성되는 속도 즉 추론 속도를 떠올립니다. 그러나 Strata 프로젝트와 OpenCode 에이전트 환경에서 관측된 병목은 추론이 아니라 프롬프트 입력 단계에 있었습니다 1, 2.
코딩 에이전트 OpenCode는 세션이 열릴 때마다 시스템 프롬프트 상단에 작업 디렉토리, 현재 날짜, Git 상태 같은 맥락 정보를 집어넣습니다 2. 이 정보는 매번 조금씩 달라지는데, 이로 인해 프롬프트 캐시 미스(Prefix Cache Miss)가 빈번하게 발생합니다 1, 2. 캐시가 무너지면 모델은 이미 알고 있을 내용까지 새로 읽어야 합니다. 실제 측정에서 OpenCode 환경의 시스템 프롬프트는 약 37K 토큰에 달했고, 매 세션마다 이 전량을 재처리하느라 약 37K 토큰 재처리 지연이 반복되었습니다 1, 2.
그 결과 첫 번째 토큰이 나오기까지 걸리는 시간은 약 100초 수준으로 치솟았습니다 1, 2. RX 9070 XT 그래픽카드와 Ryzen 5800X3D CPU, DDR4 64GB 메모리, PCIe 3.0 NVMe SSD로 구성된 가정용 PC에서, DeepSeek V4.1 Flash 모델의 프롬프트 처리 시간이 약 100초를 기록한 것입니다 1. 이 단계는 대용량 모델을 실제로 '생성'하는 구간이 아니라, 이미 읽은 문맥을 새로 고치는 구간이라는 점에서 문제의 성격이 명확히 드러납니다.
KV Splice: 전체 재계산 대신 변경된 라인만 읽기
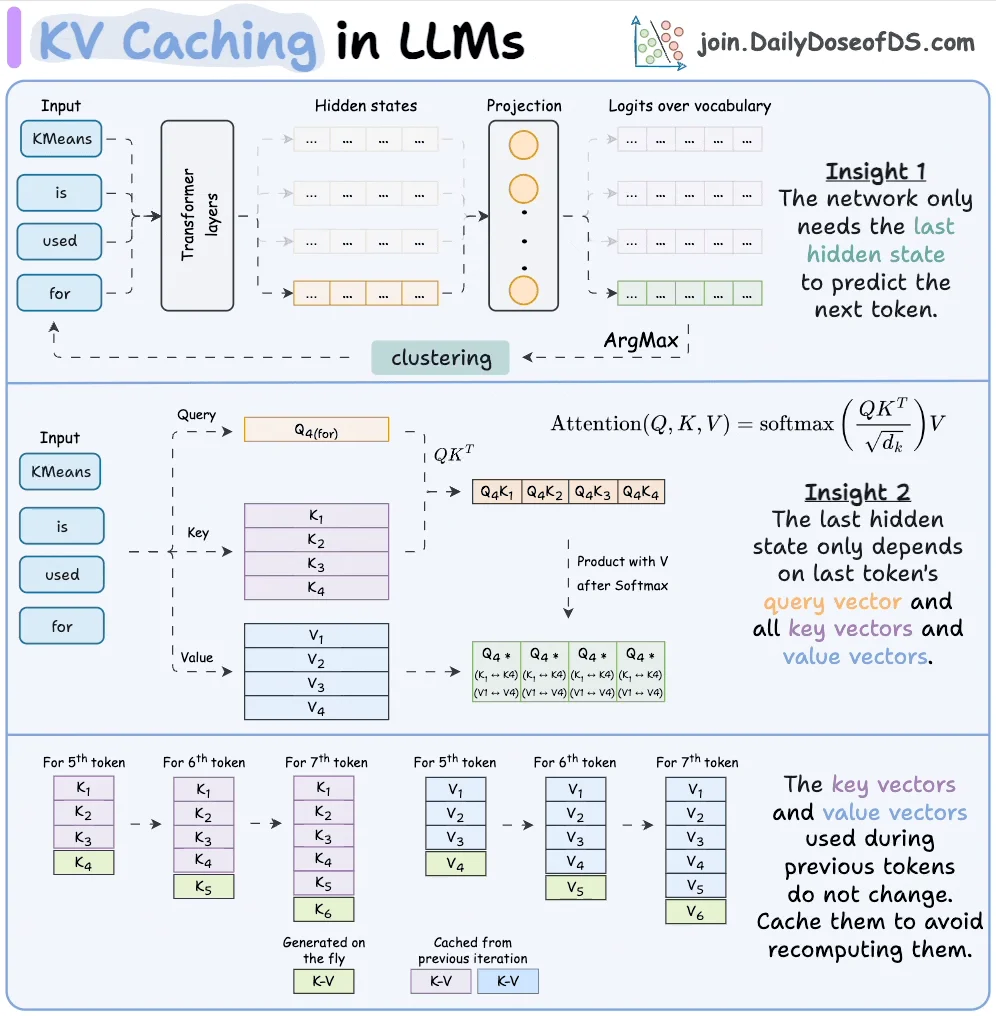
이 병목을 해소한 첫 번째 기법이 KV Splice입니다. 기존 세션에서 이미 계산된 KV Cache 상태를 분석해서, 프롬프트가 변경된 라인만 읽어들이는 방식입니다 1, 2. 즉 37K 토큰 전체를 처음부터 다시 읽는 대신, 재사용할 수 있는 캐시를 살려두고 변화한 부분만 증분 처리하는 것입니다.
제안된 동작 방식에 따르면 엔진은 모델 내 상태와 유지된 대화를 32토큰 단위 토큰 런으로 정렬하여 최대 재사용 경로를 선택합니다 2. 대화가 연속되지 않는 경우, 유지된 상태의 삭제 라인은 잘려 나가고 이후 소스 행과 윈도우 링이 조정됩니다 2. 이때 위치 값의 점프를 다루기 위해 RoPE 간격(rope_off)이 기록되며, 이 삭제 테이블은 슬롯에 DS4CUTS1 트레일러로 저장됩니다 2. RoPE 간격을 통해 캐시된 행을 이동시키는 방식으로 근사적인 재사용을 수행하는 셈입니다 1.
이 방식을 적용한 결과, 프롬프트 처리 시간은 약 100초에서 26초로 단축되었습니다 1. 이는 약 4배의 가속이며, 36,097 토큰을 재사용하는 방식으로 달성된 수치입니다 1, 2. 단순 합성 세션 테스트에서는 두 번째 세션의 토큰 재사용률이 99% 이상을 기록했고, 약 10초 만에 응답했으며, 5만 4천 토큰 대화 후속 처리 시 53,080토큰을 재사용하는 효율을 입증했습니다 2. 프롬프트 처리가 4배 빨라진 것이 에이전트 세션 체감 속도 20배 향상으로 이어진 것은, 대기 시간 대부분이 이 입력 단계에 집중되어 있었기 때문입니다 1.
Resident-only Routing: 프롬프트 읽기 중 SSD 스트리밍 병목 제거
두 번째 기법은 'Resident-only Routing'입니다. 이 기법은 프롬프트 읽기 시 VRAM과 RAM에 이미 로드된 전문가(Expert)만 우선 사용하도록 라우팅하는 방식으로, KV Splice와 병행 적용되었습니다 1, 2.
Strata는 메모리에 올리지 못하는 모델을 SSD에서 직접 스트리밍하는 방식을 사용합니다 3, 4. DeepSeek V4.1과 같은 대규모 모델은 250GB 이상의 디스크 공간을 요구하며, 메모리에 맞지 않는 데이터는 SSD에서 읽어옵니다 3, 4. 문제는 이 스트리밍이 프롬프트 읽기 구간에서 불필요하게 발생했다는 점입니다. 기존 방식에서는 프롬프트를 읽는 동안에도 SSD로부터 대용량을 스트리밍하는 병목이 나타났고, 실제로 작은 프롬프트 처리에 대해 SSD에서 58GB를 스트리밍하던 상황까지 보고되었습니다 1.
Resident-only Routing은 프롬프트 읽기 단계에서는 SSD 스트리밍을 억제하고, 이미 VRAM과 RAM에 적재된 전문가 모듈만 사용하도록 강제합니다 1, 2. 이렇게 하면 입력 단계의 I/O 병목이 제거됩니다. 참고로 RTX 4070 SUPER 12GB와 32GB RAM 환경에서는 19분간 총 2.2TB를 SSD에서 읽어들이는 스트리밍 부하가 관측된 바 있는데, 이는 스왑이 아니라 모델 가중치를 직접 스트리밍하는 구조에서 비롯된 현상입니다 5. Resident-only Routing은 이 구조적 특성을 프롬프트 입력 구간에서 우회하는 방식으로 동작합니다.
이 조합이 '20배'로 이어진 체감 산수
숫자를 정리하면, KV Splice만으로 프롬프트 처리가 100초에서 26초로 줄어 약 4배 가속이 발생했습니다 1. 여기에 Resident-only Routing이 병행되어 입력 단계의 SSD 스트리밍 병목이 추가 제거되면서, 전체 에이전트 세션의 응답 속도가 20배 향상된 것으로 보고되었습니다 1. 4배와 20배가 다른 이유는, 세션 시작 지연의 상당 부분을 프롬프트 입력이 차지하고 있었고, 그 입력 구간 내부에도 캐시 미스와 SSD 스트리밍이라는 두 층의 병목이 중첩되어 있었기 때문입니다 1, 2. 두 층을 동시에 건드려야 체감 지연이 급격히 내려가는 구조였습니다.
구현 단계에서는 STRATA_DS4_REORDER=1 옵션으로 옵트인 방식으로 제안되었으며, 공개된 테스트 브랜치에서는 기본 활성화되어 있고 STRATA_DS4_REORDER=0으로 비활성화할 수 있습니다 2. 이는 실험 기법이 실제로 사용자 환경에 적용 가능한 형태, 즉 환경 변수 기반 스위치로 이미 배포되고 있음을 보여줍니다 2.
가정용 PC에서도 에이전트를 실사용 가능한 이유
이 사례가 주목받는 배경에는, 클라우드 의존 없이도 로컬 에이전트를 쓸 수 있는 환경이 갖춰졌다는 점이 있습니다. Strata 엔진은 소비자용 하드웨어에서 DeepSeek V4.1 Flash의 출력 속도를 4~6 tok/s 수준으로 실행 가능하게 하며, RTX 5070 등의 환경이 기준점으로 제시됩니다 3. 로컬에서 OpenAI와 Anthropic 호환 API를 지원하기 때문에, OpenCode나 Codex CLI 같은 코딩 도구가 가정용 PC의 모델로 그대로 연결됩니다 3.
즉 에이전트 프레임워크는 변하지 않고, 로컬 추론 엔진의 입력 단계만 최적화해도 세션 체감 속도가 개선됩니다. Strata는 Qwen3.8-Flash-Next 등 다양한 경량화된 모델과 호환되며, 가정용 PC에서 에이전트를 구축할 수 있는 환경을 제공합니다 3. 클라우드 API 호출을 기다리는 대신 로컬 호스트에서 응답이 돌아오는 구조가 이미 성립해 있다는 점이, 이번 최적화의 적용 지점과 맞물립니다.
기법이 남긴 근사치적 성격과 검증 범위
이 최적화는 연산 자체를 정확히 복제하는 방식이 아니라, 캐시를 이동시켜 재사용하는 근사적인 접근입니다. 재사용된 토큰은 삭제된 텍스트의 컨텍스트를 포함해 계산되며, 이동된 라인이 시스템 프롬프트 꼬리 이후에 배치된다는 근사치 특성을 지닙니다 2. RoPE 간격으로 인해 위치 값에 점프가 발생하고, 정렬 과정에서 호스트 부하가 증가할 수 있다는 점도 명시되었습니다 2. 라우팅 변경으로 인해 답변이 미세하게 달라질 수 있다는 점도 한계로 지적되었습니다 1.
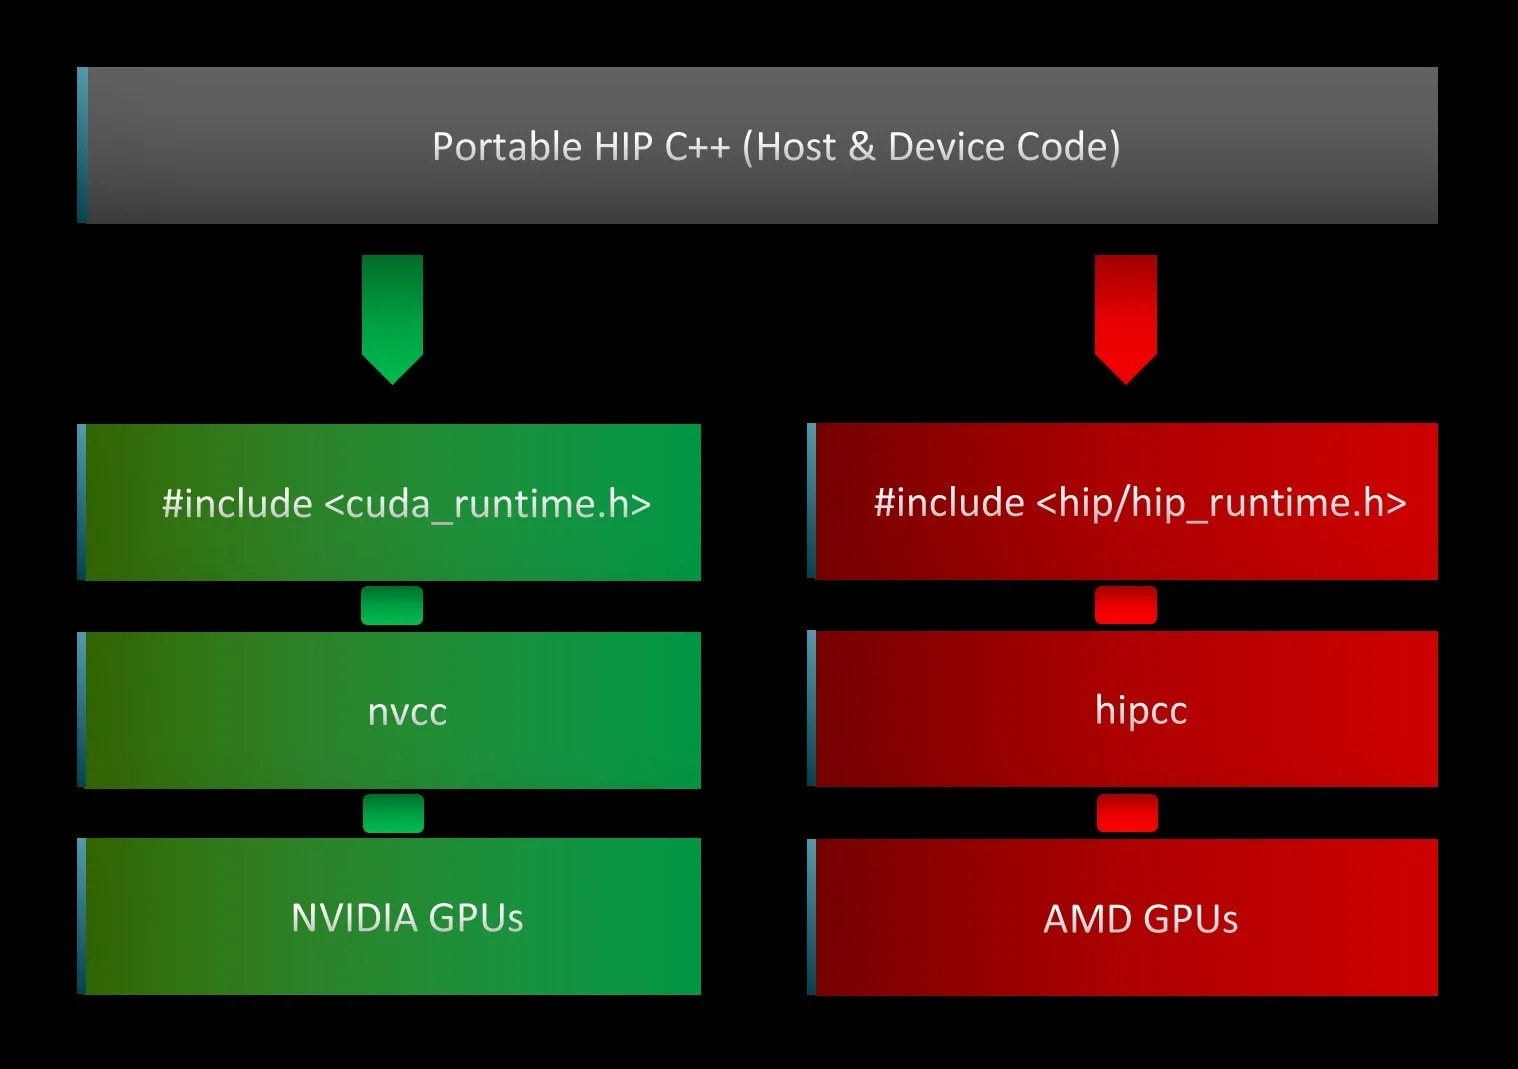
검증 범위 또한 현재 상태로 한정됩니다. 이 패치는 HIP(gfx1201) 플랫폼 전용으로 RX 9070 XT와 ROCm 환경에서 HIP 빌드로 검증되었으며, CUDA, SYCL, Metal 빌드 및 C++ 테스트 스위트 검증은 아직 완료되지 않았습니다 1, 2. 따라서 '20배'라는 수치는 해당 검증된 하드웨어와 플랫폼 조건에서 보고된 결과이며, 모든 로컬 환경에 동일하게 적용되는 보증으로 읽어서는 안 됩니다 1, 2.
에이전트 속도 개선의 관점을 바꾸는 시사점
가정용 PC에서 LLM 에이전트를 빠르게 만드는 관점은 더 빠른 GPU를 사는 데만 있지 않습니다. 이미 계산한 KV Cache를 얼마나 재사용하느냐, 그리고 입력 단계에서 불필요한 SSD 스트리밍을 얼마나 막아내느냐가 세션 시작 지연의 지배 변수로 지목되었습니다 1, 2. KV Splice는 37K 토큰 재처리를 36,097 토큰 재사용으로 바꿔 프롬프트 구간을 4배 단축했고 1, 2, Resident-only Routing은 입력 중 VRAM과 RAM의 적재 전문가만 쓰도록 라우팅해 SSD 병목을 걷어냈습니다 1, 2. 이 두 기법을 가정용 gaming GPU 조합에서 함께 적용했을 때, 100초에서 26초, 즉 세션 체감 20배 가속이라는 사례가 성립한 것입니다 1.
결국 '데이터센터 없이'라는 조건은 하드웨어의 한계를 인정하는 전제가 아니라, 캐시 재사용과 라우팅 제어처럼 입력 단계의 병목을 설계로 우회할 수 있다는 전제에 가깝습니다. OpenCode처럼 프롬프트 상단이 자주 바뀌는 에이전트를 로컬로 쓴다면, 이 두 기법이 다루는 구간—캐시 미스와 스트리밍 병목—이 속도 개선의 실제 출발점이 됩니다. HIP와 ROCm 환경에서 검증된 이 사례는, CUDA 등 다른 빌드로 확장될 때 동일한 이득이 유지될지 후속 검증을 남겨두지만 2, 로컬 에이전트 속도를 바라보는 관점을 '추론 속도'에서 '입력 병목'으로 이동시키는 출발점으로는 충분합니다.