在重启服务器时,您一定体验过用户会话断开或请求返回 500 错误的时候。在云原生环境中,服务可用性不仅仅是一个功能特性,更是与企业生存直接相关的关键指标。然而,许多开发者和运维人员往往因为 Deployment 配置中的细微差异,而意外遭遇服务中断或负载过重的问题。
本文将深入剖析 Kubernetes Deployment 的滚动更新机制,并以实战为中心,讲解如何正确配置 maxSurge、maxUnavailable 以及 readinessProbe 来实现零停机部署。我们将超越理论定义的罗列,通过具体场景来理解为什么需要这样的设置,以及设置错误时会引发哪些问题。
滚动更新的本质与基本结构
Kubernetes Deployment 是管理无状态(Stateless)应用的核心资源。它不仅仅简单地增加或减少 Pod 数量,而是为了将用户声明的“期望状态(Desired State)”真正落地,精细地调节 ReplicaSet 和 Pod。
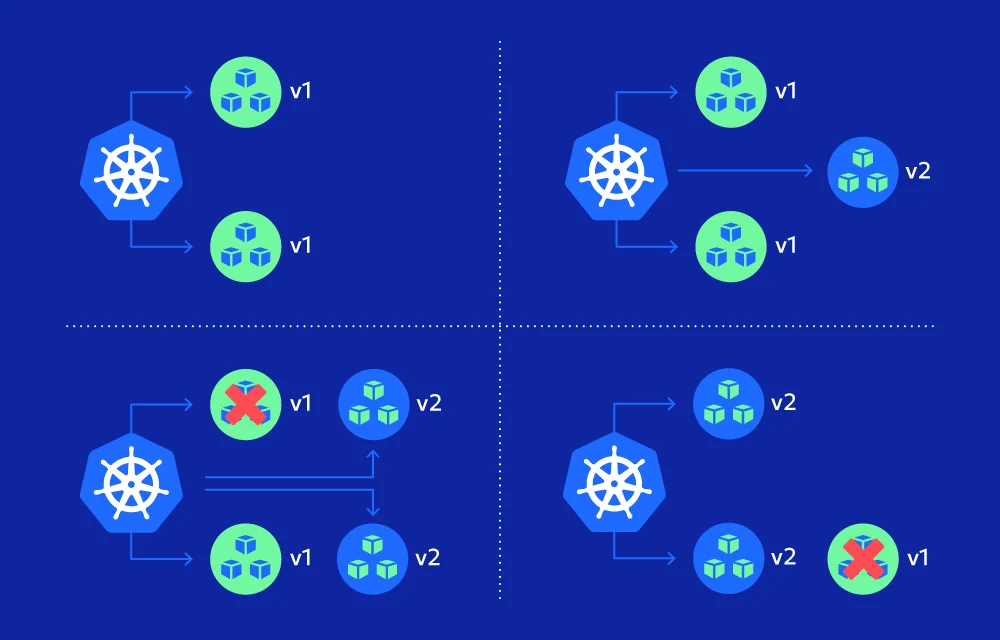
很多初学者存在一个误解:认为滚动更新仅仅是“先启动新的 Pod”。实际上,这是一个通过 maxSurge 和 maxUnavailable 这两个杠杆,来决定“替换多少”以及“多快替换”的精细过程。如果平衡被打破,就会导致资源耗尽或服务暂时不稳定。
Deployment Controller 通过 pod-template-hash 标签来区分各个 ReplicaSet。由于该哈希值与 Pod 模板内容一致,因此只有当 PodTemplateSpec 发生实质性变更(如更改镜像版本或修改环境变量)时,才会触发新的滚动更新。这也是防止因不必要的标签变更等导致非预期重建的一种安全机制。
平衡 maxSurge 和 maxUnavailable
最容易引起困惑的设置正是 maxSurge 和 maxUnavailable。这两个值可以设置为数字或百分比,它们决定了更新速度与资源使用量之间的权衡。
maxSurge 表示在更新期间,可以超过原有副本数(replicas)额外创建的 Pod 数量。您可以将其视为“额外 Pod 预算”。例如,如果 replicas 为 5,maxSurge 为 1,则在更新期间最多可以有 6 个 Pod。这里需要注意的是,由于正在创建的新 Pod 或已经标记为终止但尚未完全消失的 Pod 的资源(Resource)存在,实际总 Pod 数可能会暂时超过此值。这是因为资源回收和创建时机之间存在细微的时间差。
相反,maxUnavailable 表示在更新期间允许的“不可用(unavailable)”Pod 的最大数量。很多人误解 maxUnavailable=0 为“不终止任何 Pod”。严格来说,maxUnavailable=0 的含义是控制在更新过程中可用 Pod 的数量不会低于指定的 replicas 数量。其工作方式是:当新 Pod 就绪并处于可用状态(Ready)时,此时才终止(Terminating)一个旧 Pod。也就是说,只有当新 Pod 变为可用时,旧 Pod 才会被终止。
下面的 YAML 示例清晰地展示了这一逻辑。您应该根据服务的重要程度和资源情况来调整这些值。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: my-app-deployment
  annotations:
    kubernetes.io/change-cause: "Initial deployment v1.0"
spec:
  replicas: 5
  revisionHistoryLimit: 10
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 1
      maxUnavailable: 0
  selector:
    matchLabels:
      app: my-app
  template:
    metadata:
      labels:
        app: my-app
    spec:
      containers:
      - name: my-app-container
        image: my-app:v1.0
        ports:
        - containerPort: 8080
        readinessProbe:
          httpGet:
            path: /healthz
            port: 8080
          initialDelaySeconds: 5
          periodSeconds: 10
        resources:
          requests:
            cpu: "100m"
            memory: "128Mi"
          limits:
            cpu: "200m"
memory: "256Mi"在上述示例中,maxUnavailable: 0 意味着“更新期间允许的不可用数量为 0”。这种设置适用于对高可用性有要求的服务,但前提是集群必须有足够的剩余资源才能立即启动新的 Pod。如果资源不足,新的 Pod 将处于 Pending 状态,从而导致滚动更新延迟。
通过 readinessProbe 实现安全的流量切换
即使新 Pod 已创建,应用程序完全准备好也需要时间。如果在此刻流量进入,可能会引发错误。防止这种情况发生的正是 readinessProbe。
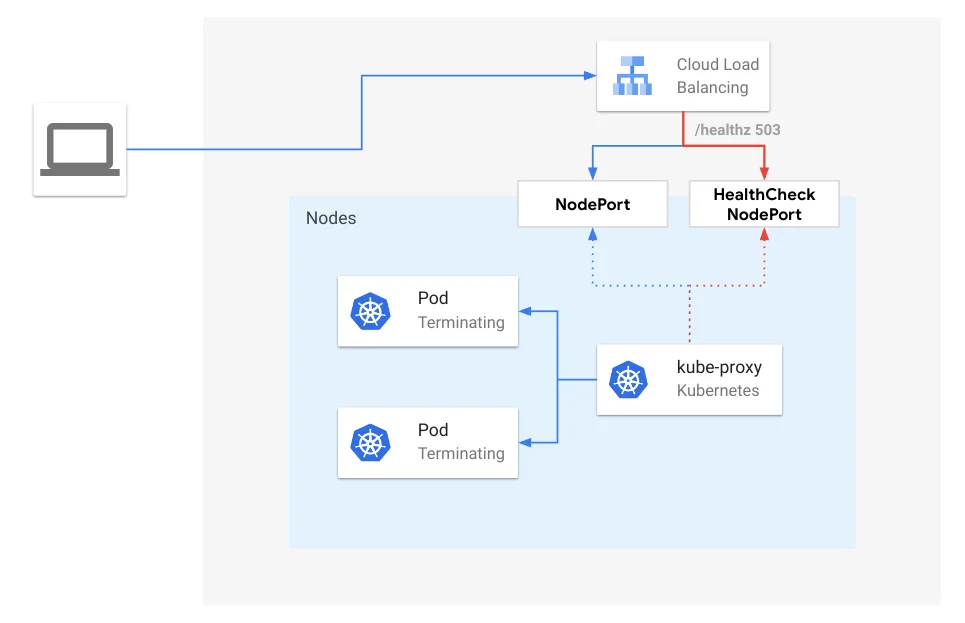
readinessProbe 用于检查 Pod 是否已准备好接收流量。在该探针成功之前,Kubernetes 不会将该 Pod 的 IP 注册到 Service 的 Endpoint 中。因此,在新 Pod 完成应用程序逻辑和数据库连接等初始化工作并开始响应之前,负载均衡器或服务网格不会向其发送流量。
在上述 YAML 中,配置了 readinessProbe,通过向 /healthz 路径发送 HTTP GET 请求,若成功则判断为可用状态。需要注意的是,livenessProbe 的作用是检查容器是否存活,若死亡则重启容器,因此与滚动更新的流量控制没有直接关系。所以,在实现零停机部署的最小示例中,重点应放在 readinessProbe 上。镜像标签、端口号、健康检查路径以及资源配额必须根据实际服务进行修改。
问题检测与回滚策略
并非所有部署都能顺利进行。如果镜像有误或配置错误,新的 Pod 可能会持续陷入 CrashLoopBackOff 状态。此时,Kubernetes 通过 progressDeadlineSeconds 来报告问题检测状态。
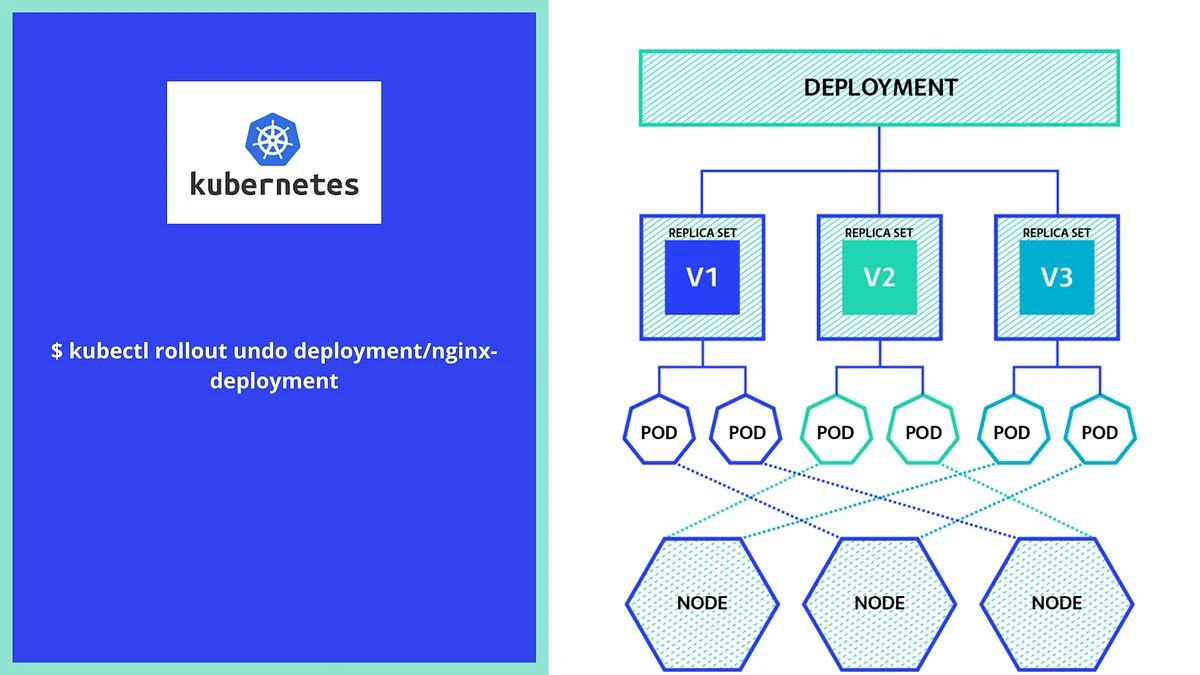
progressDeadlineSeconds 是基于滚动更新没有进展的时间来设置的。如果超过此时间仍无进展,Deployment 的状态将变为 Progressing=False,原因报告为 ProgressDeadlineExceeded。重要的是,此时 Kubernetes 控制器只是检测问题并更改状态,并不会自动回滚到以前的版本。控制器会不断尝试重试,但如果没有用户干预,可能无法恢复。
为了追踪部署历史,可以设置 revisionHistoryLimit,默认值为 10。如果此值较小,用于回滚的历史版本可能会被迅速删除,因此通常保持默认值或将其增加。此外,为了记录部署变更原因,应使用 kubernetes.io/change-cause 注解,而不是已弃用的 --record 标志。
实用的管理命令
整理了一些在实际工作中常用的命令。
- 应用部署:
bash
kubectl apply -f deployment.yaml - 监控滚动更新状态:
bash
kubectl rollout status deployment/my-app-deployment - 查看部署历史:
bash
kubectl rollout history deployment/my-app-deployment - 回滚到特定版本:
bash
kubectl rollout undo deployment/my-app-deployment --to-revision=2
您需要组合使用这些命令,实时观察部署过程,并在出现问题时能够立即做出响应。
结论
零停机部署并非魔法般自然而然发生的,它基于 maxSurge 和 maxUnavailable 的平衡配置,以及 readinessProbe 的准确动作。如果没有考虑资源预算的策略性配置,集群要么浪费资源,要么服务发生中断。请根据今天探讨的配置要点,检查您当前正在运行的服务的 Deployment 配置。微小的配置变更可能会极大地提升系统的稳定性。
您的服务是根据什么标准来设置 maxUnavailable 值的呢?
参考资料
- Kubernetes 官方文档:Probes · kubernetes.io
- 디플로이먼트 | Kubernetes · kubernetes.io