¿Alguna vez has experimentado que la sesión del usuario se corta o que las solicitudes fallan con un error 500 al reiniciar los servidores? En un entorno cloud-native, la disponibilidad del servicio no es una simple característica, sino un indicador vital directamente ligado a la supervivencia del negocio. Sin embargo, muchos desarrolladores y operadores se enfrentan a interrupciones no deseadas o sobrecargas de servicio debido a sutiles diferencias en la configuración del Deployment.
En este artículo, analizaremos en profundidad el mecanismo de actualización progresiva (rolling update) de Kubernetes Deployment y explicaremos de forma práctica cómo lograr despliegues sin interrupciones configurando correctamente maxSurge, maxUnavailable y readinessProbe. Más allá de enumerar definiciones teóricas, entenderemos por qué se necesitan estas configuraciones y qué problemas surgen cuando se establecen incorrectamente, a través de escenarios concretos.
La esencia y estructura básica de las actualizaciones progresivas
Kubernetes Deployment es el recurso clave para gestionar aplicaciones sin estado (stateless). Va más allá de simplemente escalar pods hacia arriba o hacia abajo; ajusta cuidadosamente ReplicaSets y Pods para implementar el 'estado deseado (Desired State)' declarado por el usuario.
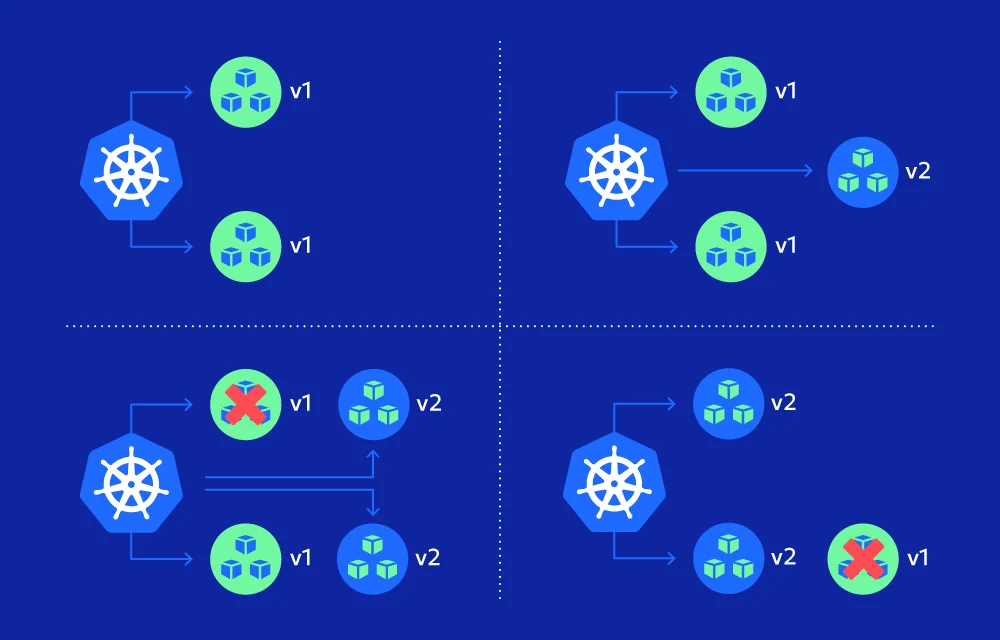
Muchos principiantes tienen malentendidos sobre esto. Una actualización progresiva no significa simplemente 'levantar primero los nuevos pods'. Es un proceso sofisticado que, a través de dos palancas llamadas maxSurge y maxUnavailable, decide 'cuántos' y 'con qué rapidez' se reemplazan los pods. Si este equilibrio se rompe, los recursos se agotan o el servicio se vuelve temporalmente inestable.
El Deployment Controller distingue cada ReplicaSet mediante la etiqueta pod-template-hash. Dado que este hash coincide con el contenido de la plantilla del Pod, se dispara un nuevo despliegue solo cuando hay cambios sustanciales en el PodTemplateSpec, como la versión de la imagen o la modificación de variables de entorno. Actúa también como una medida de seguridad para evitar reconfiguraciones no intencionadas causadas por cambios innecesarios en las etiquetas, entre otros.
Equilibrando maxSurge y maxUnavailable
La configuración que más confusión genera es, precisamente, maxSurge y maxUnavailable. Ambos valores se pueden establecer mediante números o porcentajes y determinan el equilibrio entre la velocidad de actualización y el uso de recursos.
maxSurge indica el número de pods adicionales que se pueden crear superando el número de pods existentes (replicas) durante la actualización. Se puede considerar como el 'presupuesto de pods adicionales'. Por ejemplo, si las réplicas son 5 y maxSurge es 1, puede haber hasta 6 pods durante la actualización. Es importante destacar que el número total real de pods podría superar temporalmente este valor debido a los recursos de los pods que se están creando o que ya están en proceso de terminación pero aún no han desaparecido por completo. Esto se debe a diferencias sutiles en el timing de la liberación y creación de recursos.
Por el contrario, maxUnavailable representa el número máximo de pods 'no disponibles (unavailable)' permitidos durante la actualización. Muchos malinterpretan maxUnavailable=0 como 'no terminan ningún pod'. Estrictamente hablando, maxUnavailable=0 significa que se controla que el número de pods disponibles no caiga por debajo del número especificado de réplicas durante el proceso de actualización. El flujo es el siguiente: cuando un nuevo pod está listo y alcanza el estado Ready, entonces se termina un pod existente. Es decir, cuando el nuevo pod se vuelve disponible, el pod antiguo se termina.
El siguiente ejemplo YAML muestra claramente esta lógica. Estos valores deben ajustarse según la criticidad del servicio y la situación de recursos.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: my-app-deployment
  annotations:
    kubernetes.io/change-cause: "Initial deployment v1.0"
spec:
  replicas: 5
  revisionHistoryLimit: 10
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 1
      maxUnavailable: 0
  selector:
    matchLabels:
      app: my-app
  template:
    metadata:
      labels:
        app: my-app
    spec:
      containers:
      - name: my-app-container
        image: my-app:v1.0
        ports:
        - containerPort: 8080
        readinessProbe:
          httpGet:
            path: /healthz
            port: 8080
          initialDelaySeconds: 5
          periodSeconds: 10
        resources:
          requests:
            cpu: "100m"
            memory: "128Mi"
          limits:
            cpu: "200m"
            memory: "256Mi"
En el ejemplo anterior, maxUnavailable: 0 significa "permitir cero pods no disponibles durante la actualización". Esta configuración es adecuada para servicios que requieren alta disponibilidad, pero solo se pueden lanzar nuevos pods inmediatamente si el clúster tiene recursos suficientes. Si los recursos son insuficientes, el nuevo pod permanecerá en estado Pendiente (Pending) y el despliegue podrá demorarse.
Conmutación segura del tráfico mediante readinessProbe
Incluso si se ha creado un nuevo pod, la aplicación puede tardar un tiempo en estar completamente preparada. Si el tráfico fluye hacia él en ese momento, podrían producirse errores. La solución a esto es precisamente readinessProbe.
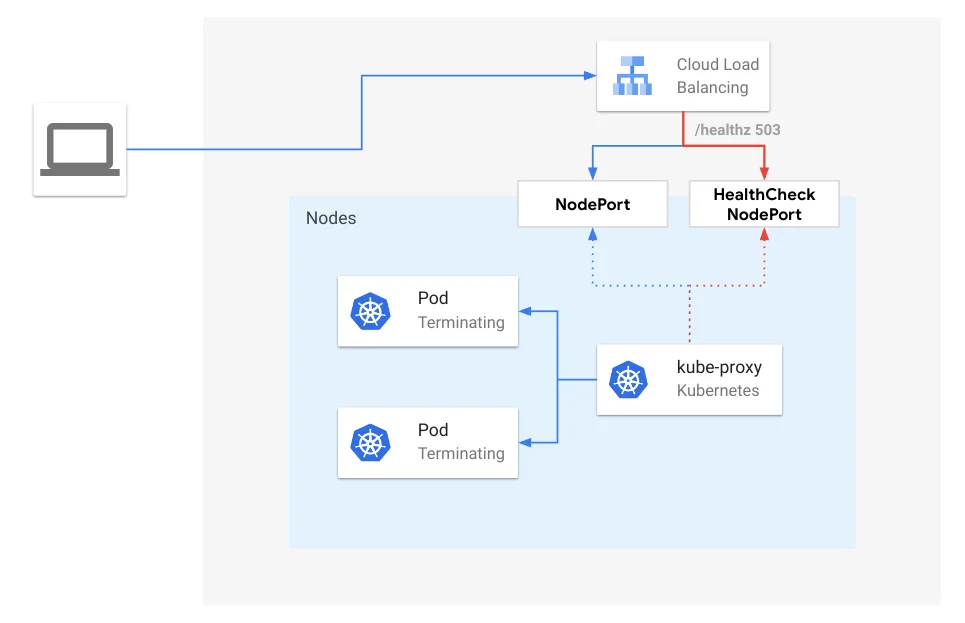
readinessProbe es una sonda que verifica si un pod está listo para recibir tráfico. Kubernetes no registra la IP del pod en los endpoints del Service hasta que esta sonda tenga éxito. Por lo tanto, ni el balanceador de carga ni la malla de servicios enviarán tráfico hasta que el nuevo pod haya completado tareas de inicialización como la lógica de la aplicación o las conexiones a bases de datos y comience a responder.
Como se observa en el YAML anterior, está configurado readinessProbe, que envía una solicitud HTTP GET a la ruta /healthz y, si tiene éxito, considera el pod como disponible. Cabe aclarar que livenessProbe tiene la función de comprobar si el contenedor está vivo y reiniciarlo si muere, por lo que tiene poca relación directa con el control del tráfico durante las actualizaciones progresivas. Por ello, en ejemplos mínimos para despliegues sin interrupciones, el enfoque debe estar en readinessProbe. Las etiquetas de imagen, números de puerto, rutas de comprobación de salud y cifras de recursos deben ajustarse siempre según el servicio real.
Detección de problemas y estrategias de rollback
No todos los despliegues irán bien. Podría ocurrir que la imagen sea incorrecta o que errores de configuración provoquen que los nuevos pods queden constantemente en estado CrashLoopBackOff. En estos casos, Kubernetes informa sobre el estado de detección de problemas mediante progressDeadlineSeconds.
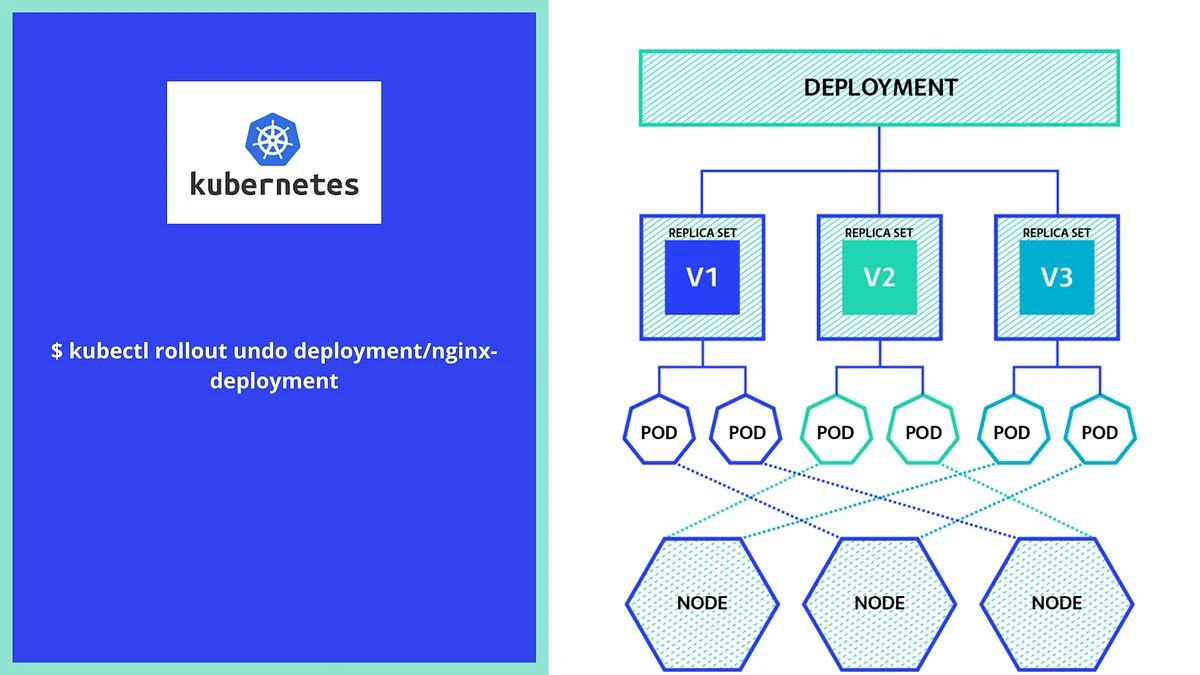
progressDeadlineSeconds se establece basándose en el tiempo sin progreso del despliegue. Si no hay progreso después de este tiempo, el estado del Deployment pasa a Progressing=False y el motivo se reporta como ProgressDeadlineExceeded. Lo importante es destacar que, en este punto, el controlador de Kubernetes detecta el problema y solo cambia el estado, pero no realiza automáticamente un rollback a la versión anterior. El controlador seguirá intentando reintentar, pero es posible que no se recupere sin la intervención del usuario.
Se puede configurar revisionHistoryLimit para rastrear el historial de despliegues, siendo el valor predeterminado 10. Si este valor es bajo, el historial para posibles rollbacks puede eliminarse rápidamente, por lo que es común mantenerlo o aumentarlo. Además, para registrar la razón del cambio durante el despliegue, se debe utilizar la anotación kubernetes.io/change-cause en lugar de la flag --record, que ha sido deprecada.
Comandos de gestión útiles
A continuación, resumimos los comandos utilizados frecuentemente en la práctica.
- Aplicar despliegue:
bash
kubectl apply -f deployment.yaml - Monitorear el estado del rollout:
bash
kubectl rollout status deployment/my-app-deployment - Verificar el historial de despliegues:
bash
kubectl rollout history deployment/my-app-deployment - Rollback a una versión específica:
bash
kubectl rollout undo deployment/my-app-deployment --to-revision=2
Es fundamental combinar estos comandos para observar el proceso de despliegue en tiempo real y responder de inmediato cuando surgen problemas.
Conclusión
Los despliegues sin interrupciones no ocurren como por arte de magia, sino que se basan en un equilibrio adecuado entre maxSurge y maxUnavailable, así como en el funcionamiento preciso de readinessProbe. Sin una configuración estratégica que considere el presupuesto de recursos, el clúster desperdiciará recursos o el servicio sufrirá cortes. Tomando como base los puntos de configuración revisados hoy, revisen la configuración del Deployment de los servicios actualmente en producción. Pequeños cambios en la configuración pueden mejorar significativamente la estabilidad del sistema.
¿Con qué criterios están estableciendo el valor de maxUnavailable en sus servicios?
Referencias
- Documentación oficial de Kubernetes: Probes · kubernetes.io
- 디플로이먼트 | Kubernetes · kubernetes.io