서버를 재기동할 때 사용자의 세션이 끊기거나 요청이 500 에러로 터지는 경험을 해보셨을 겁니다. 클라우드 네이티브 환경에서 서비스 가용성은 단순한 기능이 아니라 비즈니스의 생존과 직결된 지표입니다. 하지만 많은 개발자와 운영자가 Deployment 설정의 미세한 차이로 인해 의도치 않은 서비스 중단이나 과부하를 경험하곤 합니다.
이 글에서는 Kubernetes Deployment의 롤링 업데이트 메커니즘을 깊이 있게 파헤치고, maxSurge, maxUnavailable, 그리고 readinessProbe를 올바르게 설정하여 무중단 배포를 실현하는 방법을 실무 중심으로 설명합니다. 이론적인 정의 나열을 넘어, 왜 그런 설정이 필요한지, 그리고 설정을 잘못했을 때 어떤 문제가 발생하는지 구체적인 시나리오를 통해 이해해 보겠습니다.
롤링 업데이트의 본질과 기본 구조
Kubernetes Deployment는 Stateless 애플리케이션을 관리하는 핵심 리소스입니다. 단순히 파드(Pod)를 늘리고 줄이는 것을 넘어, 사용자가 선언한 '원하는 상태(Desired State)'를 실제로 구현하기 위해 ReplicaSet과 Pod를 세심하게 조절합니다.
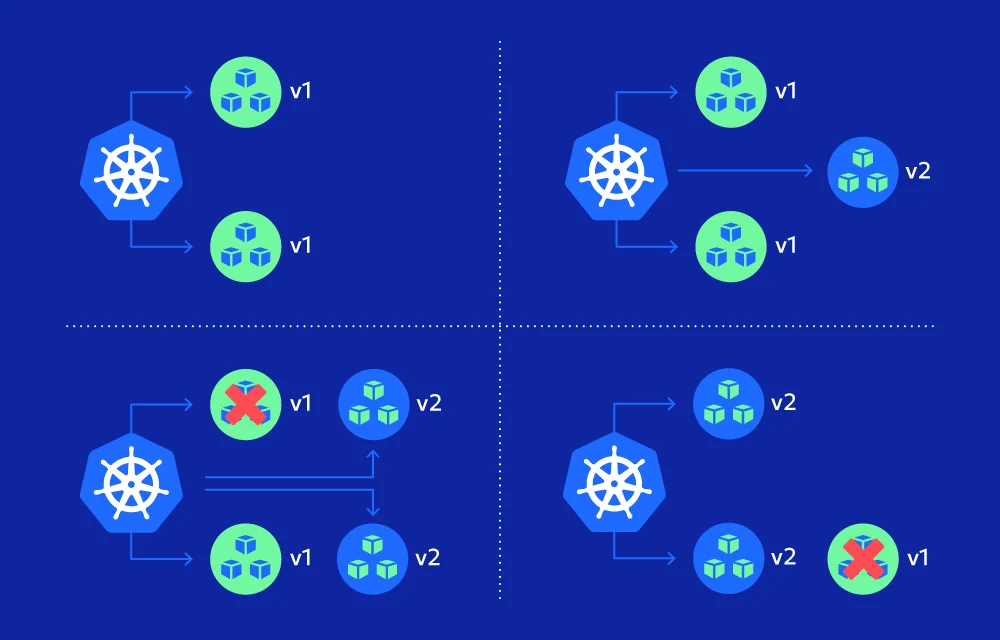
많은 초보자가 오해하는 부분이 있습니다. 롤링 업데이트는 단순히 '새로운 파드를 먼저 띄운다'는 것이 아닙니다. 이는 maxSurge와 maxUnavailable라는 두 가지 레버를 통해 '얼마나 많이' 그리고 '얼마나 빨리' 교체할지 결정하는 정교한 프로세스입니다. 이 균형이 깨지면 자원이 고갈되거나 서비스가 일시적으로 불안정해집니다.
Deployment Controller는 pod-template-hash 레이블을 통해 각 ReplicaSet을 구분합니다. 이 해시는 Pod 템플릿의 내용과 일치하므로, 이미지 버전 변경이나 환경 변수 수정 등 PodTemplateSpec의 실질적인 변경이 있을 때만 새로운 롤아웃이 트리거됩니다. 불필요한 레이블 변경 등으로 인한 의도치 않은 재구성을 방지하는 안전장치이기도 합니다.
maxSurge와 maxUnavailable의 균형 맞추기
가장 많은 혼란을 야기하는 설정이 바로 maxSurge와 maxUnavailable입니다. 이 두 값은 숫자나 백분율로 설정할 수 있으며, 업데이트 진행 속도와 리소스 사용량 사이의 트레이드오프를 결정합니다.
maxSurge는 업데이트 중 기존 파드 수(relicas)를 초과하여 추가로 생성할 수 있는 파드의 수를 의미합니다. 이는 '추가 파드 예산'이라고 볼 수 있습니다. 예를 들어 replicas가 5이고 maxSurge가 1이라면, 업데이트 중에는 최대 6개의 파드가 존재할 수 있습니다. 여기서 중요한 점은, 새로 생성 중인 파드나 이미 종료 처리 중이지만 아직 완전히 사라지지 않은 파드의 자원(리소스) 때문에 실제 총 파드 수가 일시적으로 이 값을 초과할 수도 있다는 사실입니다. 자원의 회수와 생성 타이밍의 미세한 차이 때문입니다.
반대로 maxUnavailable은 업데이트 중 허용되는 '가용하지 않은(unavailable)' 파드의 최대 수를 뜻합니다. 많은 분들이 maxUnavailable=0을 '파드를 하나도 종료하지 않는다'고 오해하십니다. 엄밀히 말하면 maxUnavailable=0은 업데이트 과정에서 가용한 파드의 수가 지정된 replicas 미만으로 떨어지지 않도록 제어한다는 의미입니다. 새로운 파드가 준비되어 가용 상태(Ready)가 되면, 그때 비로소 기존 파드 하나가 종료(Terminating)되는 방식으로 진행됩니다. 즉, 신규 파드가 가용해지면 기존 파드는 종료됩니다.
아래의 YAML 예시는 이러한 논리를 명확히 보여줍니다. 서비스의 중요도와 리소스 상황에 따라 이 값을 조절해야 합니다.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: my-app-deployment
  annotations:
    kubernetes.io/change-cause: "Initial deployment v1.0"
spec:
  replicas: 5
  revisionHistoryLimit: 10
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 1
      maxUnavailable: 0
  selector:
    matchLabels:
      app: my-app
  template:
    metadata:
      labels:
        app: my-app
    spec:
      containers:
      - name: my-app-container
        image: my-app:v1.0
        ports:
        - containerPort: 8080
        readinessProbe:
          httpGet:
            path: /healthz
            port: 8080
          initialDelaySeconds: 5
          periodSeconds: 10
        resources:
          requests:
            cpu: "100m"
            memory: "128Mi"
          limits:
            cpu: "200m"
            memory: "256Mi"
위의 예시에서 maxUnavailable: 0은 "업데이트 중 허용 불가용 수 0"을 의미합니다. 이 설정은 높은 가용성을 요구하는 서비스에 적합하지만, 클러스터의 여유 자원이 충분해야만 새로운 파드를 즉시 띄울 수 있습니다. 만약 리소스가 부족하다면 새로운 파드는 Pending 상태에 머무르며 롤아웃이 지연될 수 있습니다.
readinessProbe를 통한 안전한 트래픽 전환
새로운 파드가 생성되었더라도 애플리케이션이 완전히 준비되기까지 시간이 걸릴 수 있습니다. 이 시점에 트래픽이 유입되면 오류가 발생할 수 있습니다. 이를 방지하는 것이 바로 readinessProbe입니다.
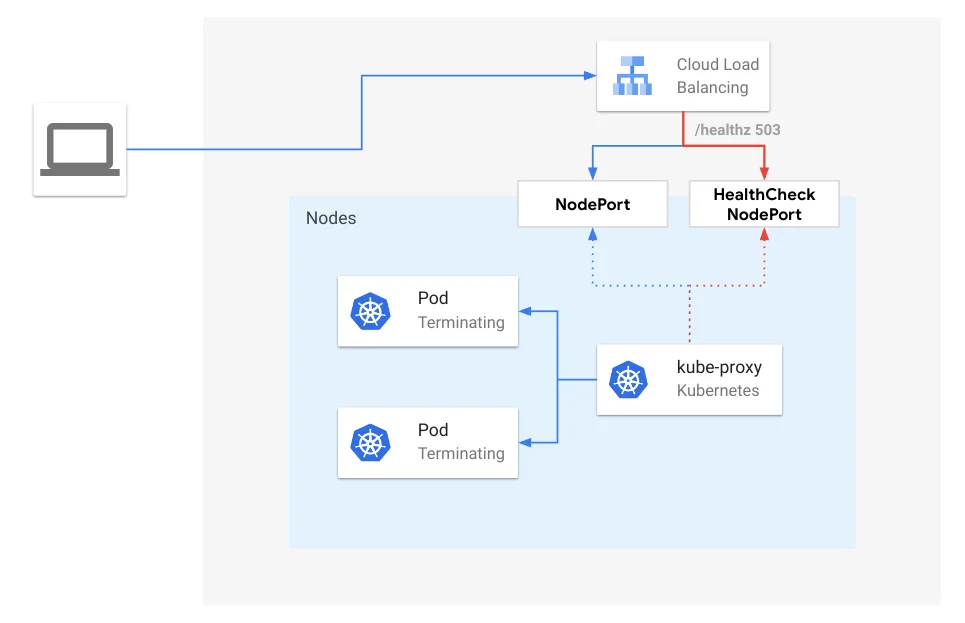
readinessProbe는 파드가 트래픽을 수신할 준비가 되었는지를 확인하는 프로브입니다. Kubernetes는 이 프로브가 성공할 때까지 해당 파드의 Service 엔드포인트에 IP를 등록하지 않습니다. 따라서 새로운 파드가 애플리케이션 로직과 데이터베이스 연결 등 초기화 작업을 마치고 응답을 반환하기 전까지는 로드 밸런서나 서비스 메시가 트래픽을 보내지 않습니다.
위 YAML에서 보면 readinessProbe가 설정되어 있으며, /healthz 경로로 HTTP GET 요청을 보내 성공하면 가용 상태로 판단합니다. 참고로 livenessProbe는 컨테이너가 살아있는지 확인하여 죽으면 재시작시키는 역할이므로, 롤링 업데이트의 트래픽 제어와는 직접적인 관련이 적습니다. 따라서 무중단 배포를 위한 최소 예제에서는 readinessProbe에 집중하는 것이 핵심입니다. 이미지 태그, 포트 번호, 헬스 체크 경로, 그리고 리소스 수치는 실제 서비스에 맞춰 반드시 수정해야 합니다.
문제 상황 감지 및 롤백 전략
모든 배포가 순조로울 수는 없습니다. 이미지가 잘못되었거나 설정 오류로 인해 새로운 파드가 계속 CrashLoopBackOff 상태에 빠질 수 있습니다. 이때 Kubernetes는 progressDeadlineSeconds를 통해 문제 감지 상태를 보고합니다.
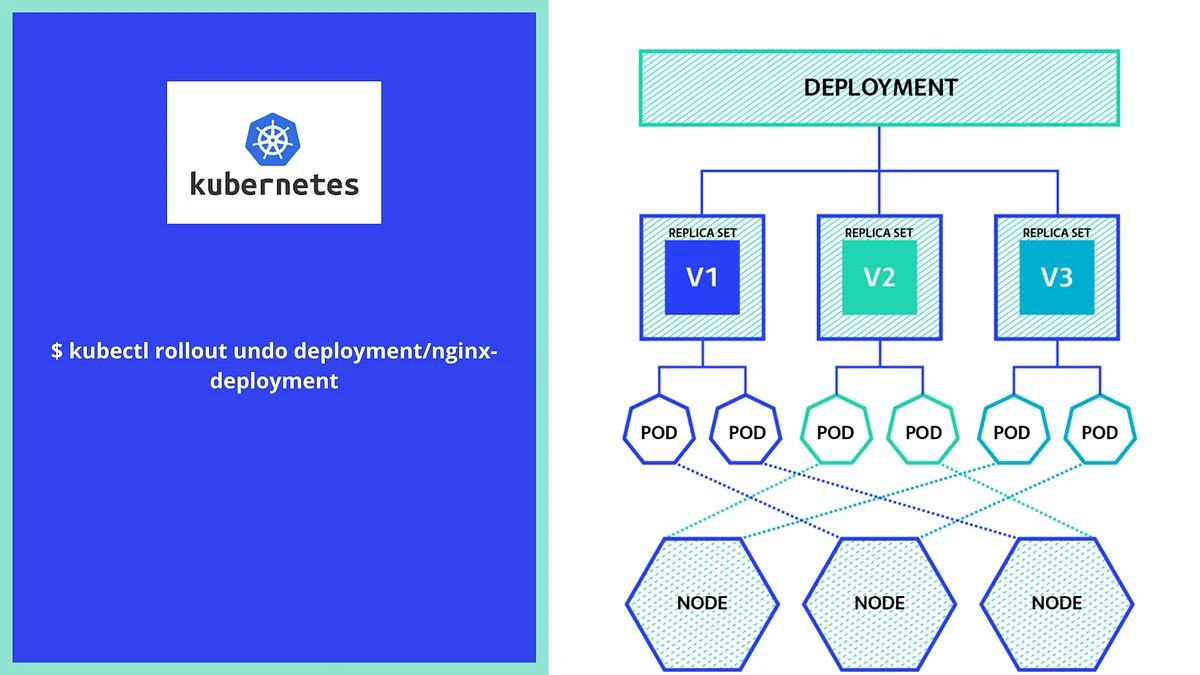
progressDeadlineSeconds는 롤아웃이 진행되지 않는 시간을 기준으로 설정합니다. 이 시간이 지나도 진전이 없으면 Deployment 상태는 Progressing=False가 되며, reason은 ProgressDeadlineExceeded로 보고됩니다. 중요한 것은, 이때 Kubernetes 컨트롤러는 문제를 감지하고 상태만 변경할 뿐, 자동으로 이전 버전으로 롤백하지 않는다는 점입니다. 컨트롤러는 계속 재시도를 시도하지만, 사용자의 개입 없이는 복구되지 않을 수 있습니다.
배포 이력을 추적하기 위해 revisionHistoryLimit을 설정할 수 있는데, 기본값은 10입니다. 이 값이 작으면 롤백 대상 이력이 빠르게 삭제될 수 있으므로, 보통 유지하거나 증가시키는 것이 일반적입니다. 또한, 배포 시 변경 이유를 남기기 위해 deprecated된 --record 플래그 대신 kubernetes.io/change-cause 어노테이션을 사용해야 합니다.
유용한 관리 명령어
실무에서 자주 사용하는 명령어들을 정리해 드립니다.
- 배포 적용:
bash
kubectl apply -f deployment.yaml - 롤아웃 상태 모니터링:
bash
kubectl rollout status deployment/my-app-deployment - 배포 이력 확인:
bash
kubectl rollout history deployment/my-app-deployment - 특정 버전으로 롤백:
bash
kubectl rollout undo deployment/my-app-deployment --to-revision=2
이러한 명령어들을 조합하여 배포 과정을 실시간으로 관찰하고, 문제가 발생했을 때 즉각적으로 대응할 수 있어야 합니다.
결론
무중단 배포는 마법처럼 이루어지는 것이 아니라, maxSurge와 maxUnavailable의 균형 잡힌 설정, 그리고 readinessProbe의 정확한 동작에 기반합니다. 리소스 예산을 고려한 전략적 설정이 없다면 클러스터는 자원을 낭비하거나 서비스는 단절됩니다. 오늘 살펴본 설정 포인트를 바탕으로 현재 운영 중인 서비스의 Deployment 설정을 점검해 보세요. 작은 설정 변화가 시스템의 안정성을 크게 높일 수 있습니다.
여러분의 서비스는 어떤 기준으로 maxUnavailable 값을 설정하고 있나요?
참고자료
- Kubernetes 공식 문서: Probes · kubernetes.io
- 디플로이먼트 | Kubernetes · kubernetes.io