サーバーの再起動時に、ユーザーのセッションが切断されたり、リクエストが500エラーで失敗したりする体験をされたことがあるでしょう。クラウドネイティブ環境において、サービスの可用性は単なる機能ではなく、ビジネスの存続に直結する指標です。しかし、多くの開発者やオペレーターは、Deployment設定の些細な違いによって意図しないサービス停止や過負荷を経験することがあります。
本記事では、Kubernetes Deploymentのローリングアップデートメカニズムを深く掘り下げ、maxSurge、maxUnavailable、そしてreadinessProbeを正しく設定して無停止デプロイを実現する方法を実務中心に解説します。理論的な定義の羅列に留まらず、なぜそのような設定が必要なのか、また設定を誤った場合にどのような問題が発生するのかを、具体的なシナリオを通じて理解していきます。
ローリングアップデートの本質と基本構造
Kubernetes Deploymentは、ステートレスアプリケーションを管理するための核心的なリソースです。単にPodを増減させるだけでなく、ユーザーが宣言した「望ましい状態(Desired State)」を確実に実現するために、ReplicaSetとPodを細かく制御します。
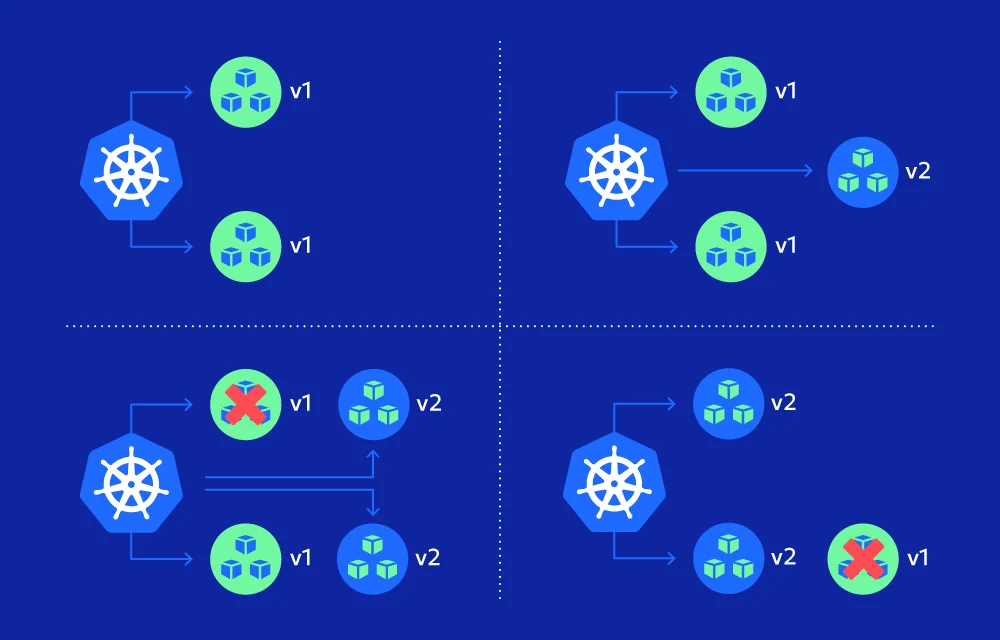
初心者がよく誤解する点があります。ローリングアップデートは単に「新しいPodを先に起動する」ことではありません。これはmaxSurgeとmaxUnavailableという2つのレバーを通じて、「どれだけの数」そして「どのくらいの速さ」で置き換えるかを決定する洗練されたプロセセスです。このバランスが崩れると、リソースの枯渇や、サービスの一時的不安定が発生します。
Deployment Controllerはpod-template-hashラベルを介して各ReplicaSetを区別します。このハッシュはPodテンプレートの内容と一致するため、イメージバージョンの変更や環境変数の修正など、PodTemplateSpecに実質的な変更があった場合のみ、新しいロールアウトがトリガーされます。不要なラベル変更などによる意図しない再構築を防ぐ安全装置としての役割も果たしています。
maxSurgeとmaxUnavailableのバランス調整
最も混乱を招く設定が、まさにmaxSurgeとmaxUnavailableです。これらの値は数値またはパーセンテージで設定でき、アップデートの進捗速度とリソース使用量間のトレードオフを決定します。
maxSurgeは、アップデート中に既存のPod数(relicas)を超えて追加作成できるPodの数を意味します。これは「追加Pod予算」と見なすことができます。例えば、relicasが5でmaxSurgeが1の場合、アップデート中は最大6個のPodが存在することになります。ここで重要なのは、新規作成中のPodや、すでに終了処理中だがまだ完全に削除されていないPodのリソース(リソース)の影響で、実際の総Pod数が一時的にこの値を超える可能性があるという点です。リソースのリカバリと生成タイミングのわずかな差によるものです。
逆にmaxUnavailableは、アップデート中に許容される「利用不可(unavailable)」Podの最大数を意味します。多くの方がmaxUnavailable=0を「Podを一つも終了させない」と誤解されています。厳密には、maxUnavailable=0はアップデートプロセス中に利用可能なPodの数が指定されたrelicas未満に低下しないように制御することを意味します。新しいPodが準備完了し、利用可能(Ready)状態になった時点で、初めて既存のPodが1つ終了(Terminating)されるという方式で進行します。つまり、新しいPodが利用可能になれば、既存のPodは終了されるということです。
以下のYAMLサンプルは、これらのロジックを明確に示しています。サービスの重要度やリソース状況に応じて、これらの値を調整する必要があります。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: my-app-deployment
  annotations:
    kubernetes.io/change-cause: "Initial deployment v1.0"
spec:
  replicas: 5
  revisionHistoryLimit: 10
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 1
      maxUnavailable: 0
  selector:
    matchLabels:
      app: my-app
  template:
    metadata:
      labels:
        app: my-app
    spec:
      containers:
      - name: my-app-container
        image: my-app:v1.0
        ports:
        - containerPort: 8080
        readinessProbe:
          httpGet:
            path: /healthz
            port: 8080
          initialDelaySeconds: 5
          periodSeconds: 10
        resources:
          requests:
            cpu: "100m"
            memory: "128Mi"
          limits:
            cpu: "200m"
memory: "256Mi"上記の例で、maxUnavailable: 0は「アップデート中の許容利用不可数 0」を意味します。この設定は高い可用性を要求するサービスに適していますが、クラスタに十分な余裕リソースがない限り、新しいPodを即座に起動できません。リソースが不足している場合、新しいPodはPending状態で滞留し、ロールアウトが遅延する可能性があります。
readinessProbeによる安全なトラフィック切り替え
新しいPodが作成されたとしても、アプリケーションが完全に準備完了するまでに時間がかかる場合があります。この時点でトラフィックが流入すると、エラーが発生する可能性があります。これを防止するのがまさにreadinessProbeです。
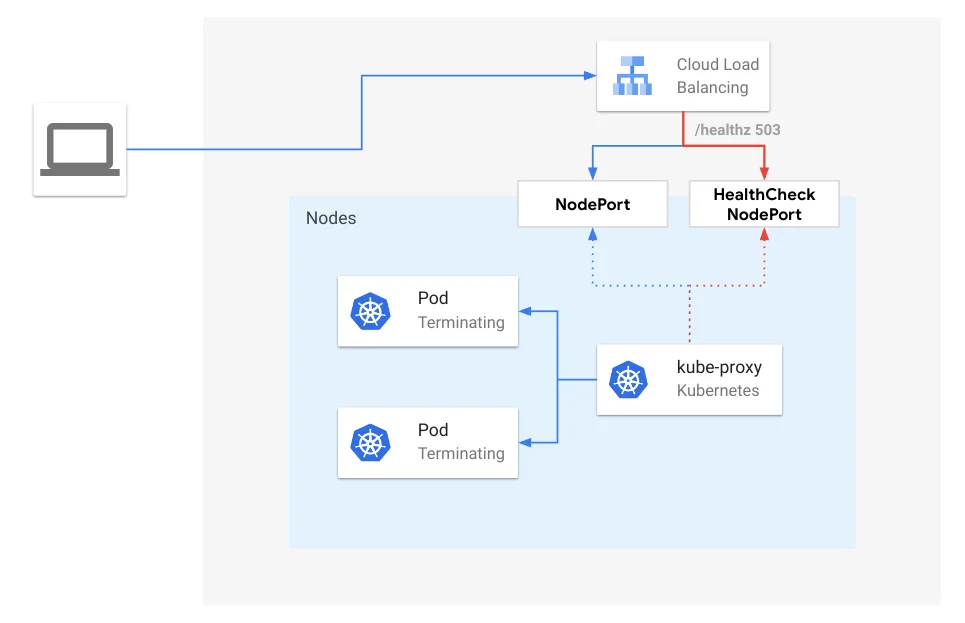
readinessProbeは、Podがトラフィックを受信する準備ができているかを確認するプローブです。Kubernetesはこのプローブが成功するまで、当該PodのServiceエンドポイントにIPを登録しません。したがって、新しいPodがアプリケーションロジックやデータベース接続などの初期化処理を完了し、レスポンスを返せるようになるまでの間、ロードバランサーやサービスメッシュはトラフィックを送信しません。
上記のYAMLを見ると、readinessProbeが設定されており、/healthzパスへHTTP GETリクエストを送信し、成功すれば利用可能状態と判断されます。なお、livenessProbeはコンテナが生きているかを確認し、死んでいれば再起動させる役割を担うため、ローリングアップデートにおけるトラフィック制御とは直接的な関連が薄いです。したがって、無停止デプロイのための最小限のサンプルでは、readinessProbeに集中することが核心です。イメージタグ、ポート番号、ヘルスチェックパス、そしてリソース数値は、実際のサービスに合わせて必ず修正してください。
問題状況の検知とロールバック戦略
すべてのデプロイが順調であるとは限りません。イメージの問題や設定ミスにより、新しいPodが継続的にCrashLoopBackOff状態に陥る可能性があります。このとき、KubernetesはprogressDeadlineSecondsを通じて問題検知状態を報告します。
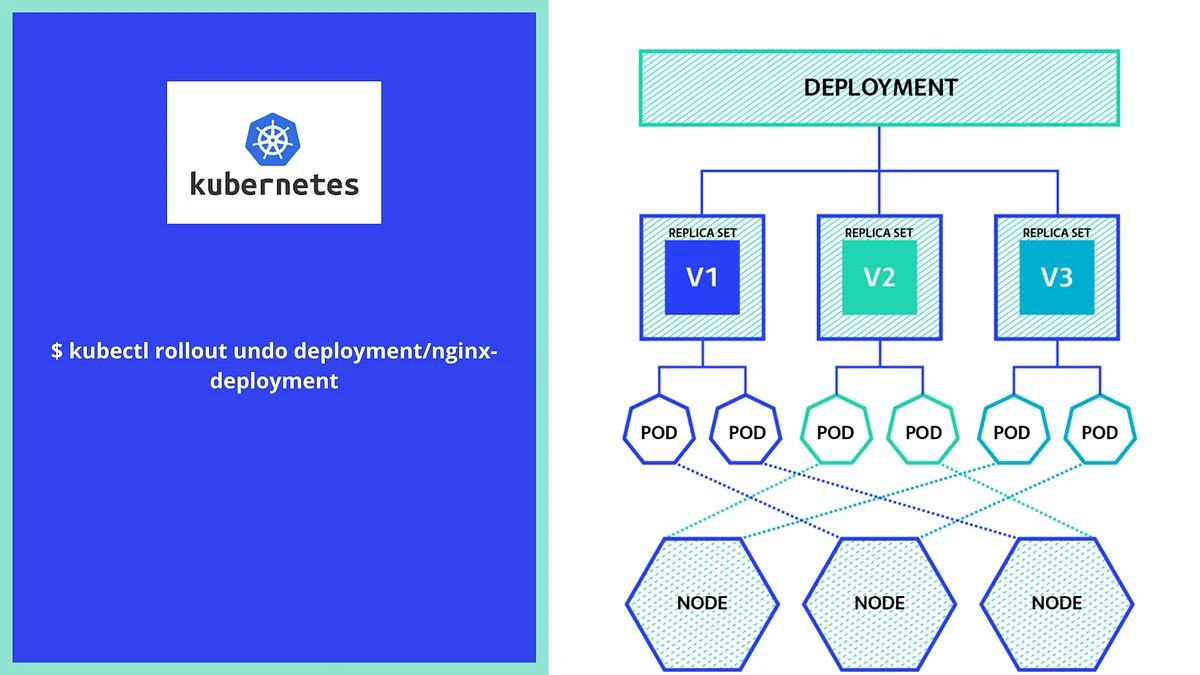
progressDeadlineSecondsは、ロールアウトが進行しない時間に基づいて設定します。この時間が経過しても進捗がない場合、Deploymentの状態はProgressing=Falseとなり、reasonはProgressDeadlineExceededとして報告されます。重要な点は、この時点でKubernetesコントローラーは問題を感知して状態を変更するだけであり、自動的にPreviousバージョンへロールバックするわけではないということです。コントローラーは継続的にリトライを試みますが、ユーザーの介入なしでは復旧しない可能性があります。
デプロイ履歴を追跡するためにrevisionHistoryLimitを設定できますが、デフォルト値は10です。この値が小さすぎると、ロールバック対象の履歴が早期に削除される可能性があるため、通常は維持するか、増加させるのが一般的です。また、デプロイ時に理由を残すため、非推奨(deprecated)となった--recordフラグの代わりにkubernetes.io/change-causeアノテーションを使用する必要があります。
有用な管理コマンド
実務で頻繁に使用するコマンドを整理してお届けします。
- デプロイ適用:
bash
kubectl apply -f deployment.yaml - ロールアウト状態の監視:
bash
kubectl rollout status deployment/my-app-deployment - デプロイ履歴の確認:
bash
kubectl rollout history deployment/my-app-deployment - 特定バージョンへのロールバック:
bash
kubectl rollout undo deployment/my-app-deployment --to-revision=2
これらのコマンドを組み合わせ、デプロイ過程をリアルタイムで観察し、問題発生時に即座に対応できるようにしてください。
結論
無停止デプロイは魔法のように実現されるのではなく、maxSurgeとmaxUnavailableのバランスの取れた設定、そしてreadinessProbeの正確な動作に基づいています。リソース予算を考慮した戦略的な設定がなければ、クラスタはリソースを浪費するか、サービスが断絶します。今回確認した設定ポイントを踏まえ、現在運用中のサービスのDeployment設定を見直してみてください。小さな設定変更が、システム全体の安定性を大きく向上させる可能性があります。
あなたのサービスでは、どの基準でmaxUnavailableの値を設定していますか?
参考文献
- Kubernetes公式ドキュメント: Probes · kubernetes.io
- 디플로이먼트 | Kubernetes · kubernetes.io