每当你阅读新的世界模型(World Model)论文时,是否曾感到一种“为了让这些代码适配我的环境,究竟要花上几天时间?”的无力感?
研究的核心在于设计创新的模型架构或新的目标函数,而不是每次都重复编写同样的数据采集脚本和环境配置代码这种“体力活”。然而,即便到了 2026 年,许多研究人员仍因碎片化的代码和无法复现的实验环境而浪费宝贵的时间。
为了解决这些问题,Stable World Model (SWM) 应运而生。从数据采集、训练到通过模型预测控制(MPC)进行评估,它将世界模型研究的全过程整合到了一个标准化的平台中。今天,我们将深入剖析这一强大的工具。
消耗研究者时间的“复现性危机”与 SWM 的出现
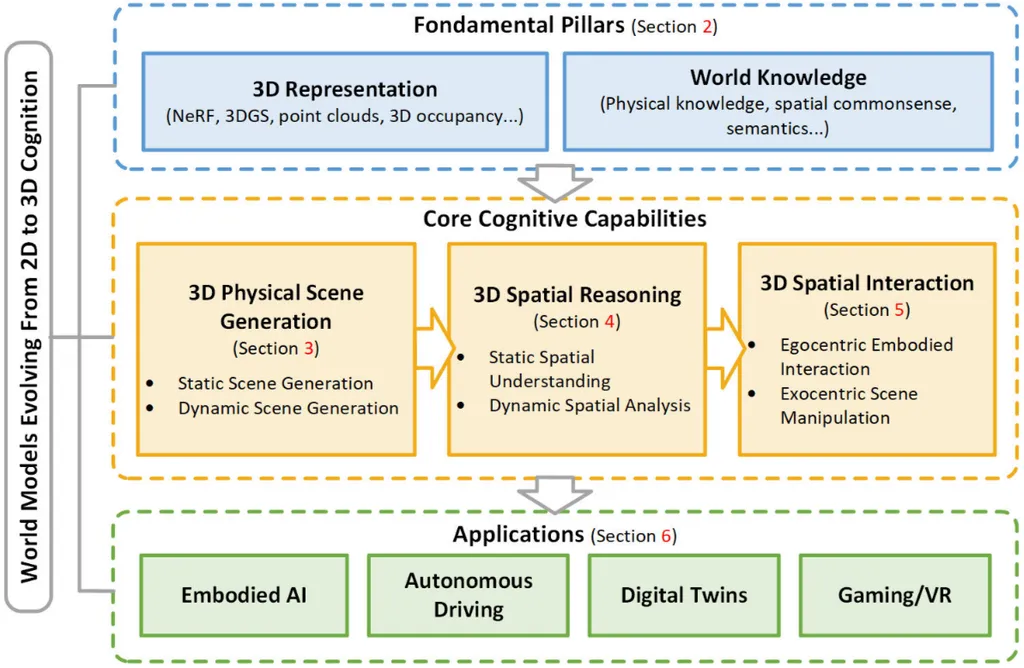
在近期的 AI 领域,世界模型已成为让智能体能够“想象”未来并进行规划的核心范式。然而,研究现状并不乐观。
每当有新论文发表时,研究人员都必须从头开始重新实现相同的基准(Baseline)、相同的评估协议(Protocol)以及相同的数据处理逻辑。这就像不是在重新发明食谱,而是在每次烹饪时都要重新制作炉灶、刀具和砧板。这种**复现性危机(reproducibility crisis)**阻碍了研究之间的公平比较,并因代码 Bug 导致大量错误。
由 GalilAI Group 公开的 stable-worldmodel 正是针对这一痛点而设计的。该库不仅仅是一个代码集合,它是一个拥有经过验证的环境套件、标准化数据层和可靠规划求解器(Planning Solver)的模块化研究生态系统。现在,研究人员可以从重复的样板代码(Boilerplate code)中解脱出来,专注于提升模型性能的核心研究。
超越简单工具的集成工作流:采集、训练与评估
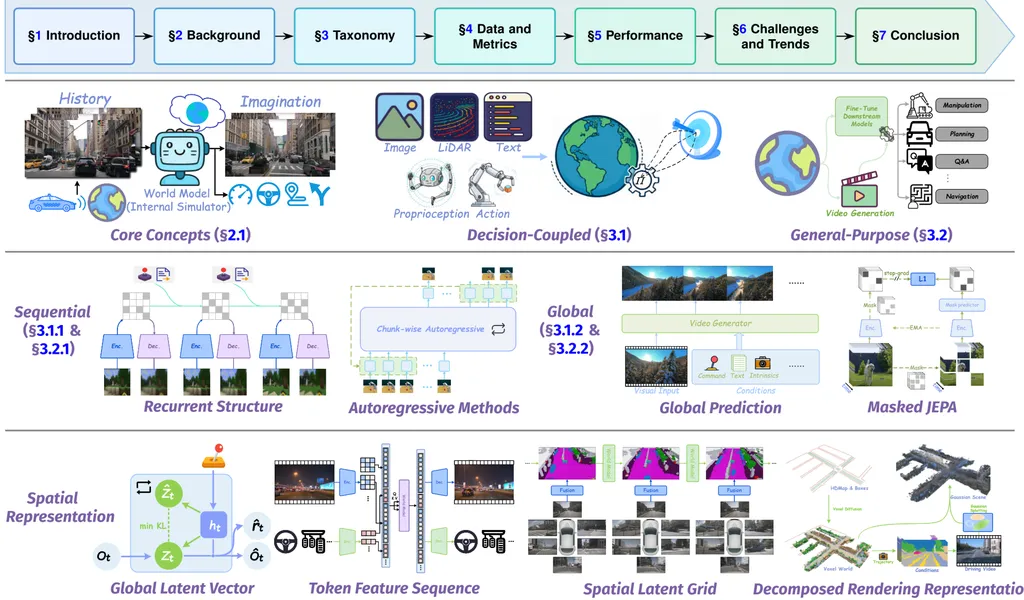
SWM 最大的魅力在于其从数据采集到模型评估的集成流水线(Integrated Pipeline)。这一过程像工厂自动化生产线一样流畅衔接。
第一阶段是数据采集。通过创建 swm.World 对象并设置专家策略(Expert Policy),可以在多并行环境中快速收集回合(Episode)数据。
第二阶段是训练。加载采集到的数据,实例化所需的世界模型架构并进行训练。由于 SWM 提供了多种最新的模型作为基准,因此与现有研究进行比较变得非常容易。
最后是评估。SWM 不仅仅是观察训练好的模型预测得是否准确。它使用如 CEMSolver(基于交叉熵方法)之类的规划求解器,根据模型预测的未来来测量实际的控制性能(成功率/Success Rate)。也就是说,它通过行为来证明模型在多大程度上“理解”了环境。
得益于这种有机流转,研究人员只需在 swm/PushT-v1 等环境中编写几行代码,即可体验从数据采集到最终成功率计算的全过程。
解决数据瓶颈的“Lance”:压倒性的性能
随着数据规模的扩大,制约研究的往往不是模型结构,而是 I/O(输入/输出)速度。以往常用的 HDF5 格式虽然便于通过单个文件进行管理,但在持续添加数据或读取大规模多模态数据时,存在速度剧降的顽疾。
为了解决这个问题,SWM 采用了名为 Lance 的下一代数据格式作为默认值。基准测试结果令人惊叹:
- 速度革命:在本地环境中,Lance 每秒可处理约 4,814 个样本。这比 HDF5 快得多。
- 高效容量:当 HDF5 占用 43.12GB 时,Lance 仅需 13.31GB。这是数据压缩和存储效率最大化的结果。
- 云端扩展性:即使在使用 Amazon S3 等远程存储时,Lance 通过缓存技术每秒也能处理超过 3,100 个样本,无论数据存储何处,都能将瓶颈降至最低。
当然,Lance 并非在所有场景下都是唯一解。如果你希望通过单个文件简便地分发数据集,HDF5 可能依然有用;在存储极长的回合数据时,视频格式可能更具优势。但在面向大规模训练的现代研究流中,Lance 是明显的赢家。
验证模型真实实力的方案:变化因子 (FoV) 控制
如果模型仅在与训练数据完全相同的环境下表现良好,我们能说它真正“理解了世界”吗?现实世界是动态的,光照会变,物体的颜色会变,摩擦力也会变。
为了测试模型的泛化能力(Generalization),SWM 提供了可以控制**变化因子(Factors of Variation, FoV)**的功能。该功能允许自由调节光照、纹理、物理属性等,是验证模型在面对陌生情况(分布外,Out-of-Distribution, OOD)时是否稳健的关键。
事实上,当研究人员利用 SWM 测试 DINO-WM 的零样本(Zero-shot)稳健性时,发现许多现有模型在面对颜色或尺寸变化等细微环境变化时,性能会急剧下降。SWM 起到了**严苛测试床(Testbed)**的作用,帮助系统性地发现这些“弱点”,并助力开发更强大的模型。
安装与入门:研究环境搭建指南
为了让研究人员能够直接投入实战,SWM 的安装过程非常直观。
1. 基础安装 如果只需要最基本的功能,可以通过 PyPI 进行简单安装。
pip install stable-worldmodel2. 全功能安装
若要包含仿真环境和各种训练依赖项,建议添加 [all] 选项。
pip install stable-worldmodel[all]3. 开发模式及特殊数据集
若要利用 LeRobot 数据集等,需要 Python 3.12 及以上环境,并可通过特定选项([lerabit])进行安装。如果你想直接为库贡献代码,建议克隆 Git 仓库并使用 uv 构建虚拟环境。
如果你想知道数据和模型检查点(Checkpoint)存储在哪里,请检查环境变量 $STABLEWM_HOME。默认情况下,它们存储在用户主目录的隐藏文件夹中,便于管理。
总结与结语
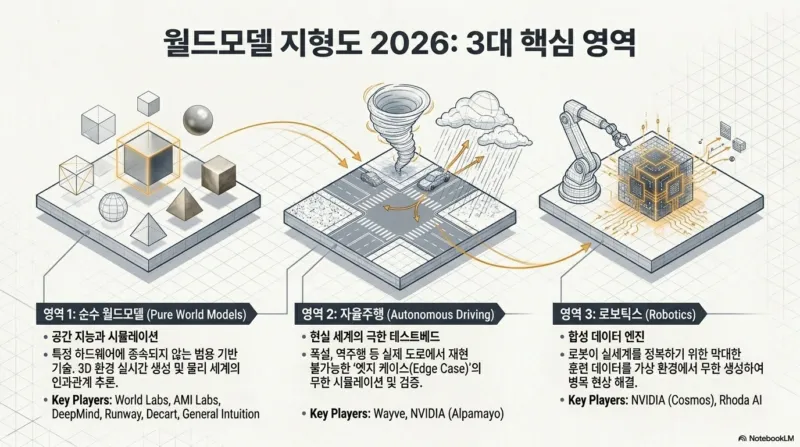
Stable World Model 是一个将碎片化的世界模型研究凝聚在一起的强大标准平台。通过基于 Lance 的高性能数据层、通过变化因子 (FoV) 进行的精细泛化评估,以及从数据采集到评估的集成工作流,它同时实现了研究的复现性和高效性。
现在,请不要再将精力耗费在重复编写代码上,转而专注于关于“模型如何更好地理解世界”的根本性问题吧。SWM 将成为你研究旅程中可靠的伙伴。
在你的研究环境中,最大的瓶颈是什么?是数据加载速度,还是复现性问题?欢迎在评论区分享你的困惑!
参考资料
- galilai-group/stable-worldmodel - GitHub · github.com
- Stable World-Model - GalilAI Group · galilai-group.github.io
- stable-worldmodel-v1: Reproducible World Modeling Research and ... · huggingface.co
- [논문 리뷰] stable-worldmodel: A Platform for Reproducible World ... · themoonlight.io



