¿Alguna vez ha sentido esa sensación de desolación al leer un nuevo artículo sobre Modelos de Mundo (World Models), pensando: "¿Cuántos días me tomará adaptar este código a mi propio entorno?"?
El núcleo de la investigación consiste en diseñar arquitecturas de modelos innovadoras o nuevas funciones de pérdida, no en realizar el "trabajo pesado" de escribir una y otra vez los mismos scripts de recolección de datos y códigos de configuración de entorno. Sin embargo, incluso en 2026, muchos investigadores siguen perdiendo tiempo valioso debido a códigos fragmentados y entornos experimentales irreproducibles.
Para resolver este problema ha surgido Stable World Model (SWM). Hoy analizaremos en detalle esta poderosa herramienta que integra todo el proceso de investigación de modelos de mundo en una única plataforma estandarizada: desde la recolección de datos hasta el entrenamiento y la evaluación mediante Control Predictivo por Modelo (MPC).
La "crisis de reproducibilidad" que roba tiempo a los investigadores y el surgimiento de SWM
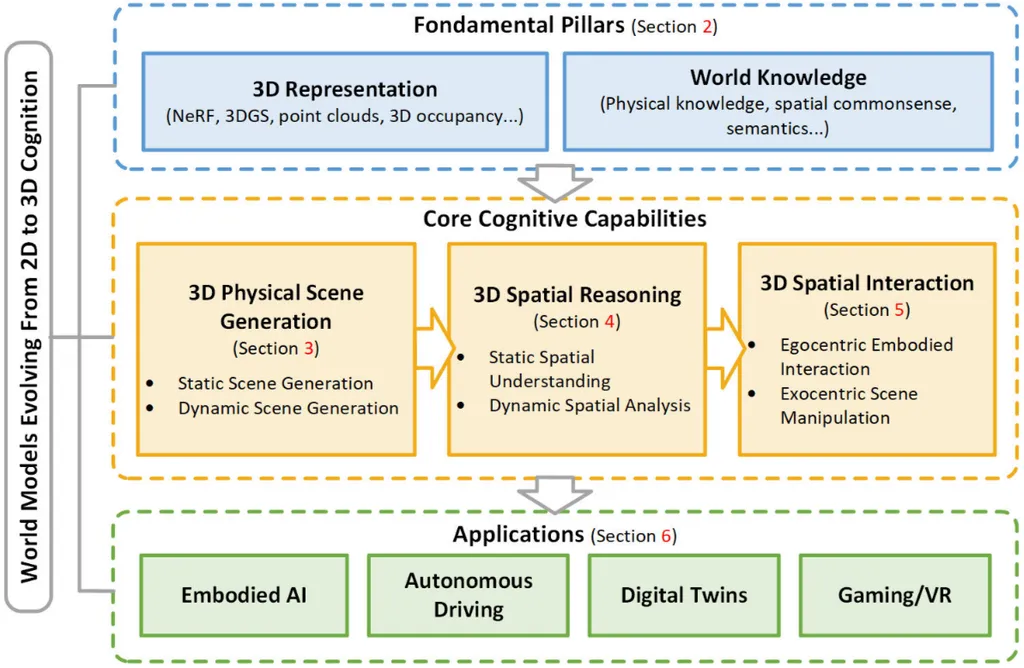
Recientemente, en el campo de la IA, los modelos de mundo han emergido como un paradigma clave que permite a los agentes "imaginar" y planificar el futuro. Sin embargo, el ambiente en el campo no es precisamente brillante.
Cada vez que se publica un nuevo artículo, los investigadores deben implementar desde cero el mismo baseline, el mismo protocolo de evaluación y la misma lógica de procesamiento de datos. Es como si, en lugar de seguir una receta, tuvieras que fabricar la estufa, el cuchillo y la tabla de cortar cada vez que quieres cocinar. Esta crisis de reproducibilidad (reproducibility crisis) obstaculiza la comparación justa de las investigaciones y genera errores causados por bugs en el código.
El proyecto stable-worldmodel, publicado por el Grupo GalilAI, ataca precisamente este punto. Esta librería no es un simple conjunto de códigos; es un ecosistema de investigación modular que cuenta con un conjunto de entornos verificados, una capa de datos estandarizada y solvers de planificación fiables. Ahora, los investigadores pueden liberarse del código repetitivo (boilerplate) y concentrarse en la investigación central que realmente mejora el rendimiento de los modelos.
Más que una simple herramienta: un flujo de trabajo integrado de recolección, entrenamiento y evaluación
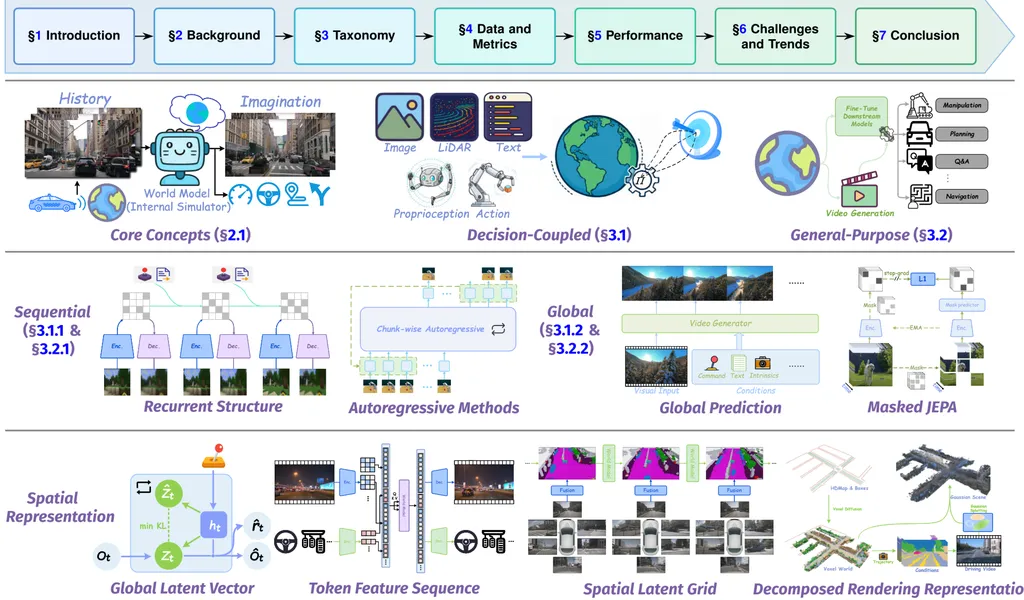
El mayor atractivo de SWM reside en su pipeline integrado que conecta la recolección de datos con la evaluación del modelo. Este proceso se conecta de manera fluida, como una línea de producción automatizada bien diseñada en una fábrica.
El primer paso es la recolección de datos. Al crear un objeto swm.World y configurar una política experta (Expert Policy), se pueden recolectar rápidamente datos de episodios en múltiples entornos paralelos.
El segundo es el entrenamiento. Se cargan los datos recolectados, se instancia la arquitectura del modelo de mundo deseada y se procede al entrenamiento. Dado que SWM proporciona diversos modelos de vanguardia como baselines, la comparación con investigaciones previas es extremadamente sencilla.
El último es la evaluación. SWM no se limita a observar si el modelo entrenado predice bien. Utilizando solvers de planificación como CEMSolver (basado en el Método de Entropía Cruzada), mide qué tan bueno es el rendimiento de control real (Success Rate) basado en el futuro predicho por el modelo. Es decir, demuestra con acciones qué tan bien "entiende" el modelo el entorno.
Gracias a este flujo orgánico, un investigador puede experimentar todo el proceso, desde la recolección de datos hasta el cálculo de la tasa de éxito final, con solo unas pocas líneas de código en entornos como swm/PushT-v1.
El rendimiento abrumador de 'Lance', que resuelve el cuello de botella de los datos
A medida que los datos crecen, lo que frena la investigación no es tanto la estructura del modelo, sino la velocidad de I/O (entrada/salida). El método HDF5, muy utilizado anteriormente, es conveniente para gestionar un solo archivo, pero presenta el problema crónico de que la velocidad disminuye drásticamente al añadir datos continuamente o al leer datos multimodales a gran escala.
Para resolver este problema, SWM ha adoptado por defecto Lance, un formato de datos de próxima generación. Los resultados de las pruebas de rendimiento son realmente sorprendentes.
- Revolución de velocidad: En entornos locales, Lance procesa aproximadamente 4,814 muestras por segundo. Esto es una velocidad abrumadoramente superior a la de HDF5.
- Capacidad eficiente: Mientras que HDF5 ocupa 43.12 GB, Lance utiliza solo 13.31 GB. Es el resultado de maximizar la compresión de datos y la eficiencia de almacenamiento.
- Escalabilidad en la nube: Incluso al usar almacenamiento remoto como Amazon S3, Lance procesa más de 3,100 muestras por segundo mediante el uso de caché, minimizando los cuellos de botella sin importar dónde se encuentren los datos.
Por supuesto, Lance no es la respuesta para todas las situaciones. Si se desea distribuir un conjunto de datos fácilmente como un único archivo, HDF5 puede seguir siendo útil, y para guardar episodios muy largos, el formato de video puede ser ventajoso. Sin embargo, en el flujo de investigación moderno orientado al entrenamiento a gran escala, Lance es el claro ganador.
Cómo verificar la verdadera capacidad del modelo: control de Factores de Variación (FoV)
Si un modelo solo funciona bien en un entorno idéntico a los datos de entrenamiento, ¿podemos decir que realmente "entiende el mundo"? El mundo real es un lugar dinámico donde la luz cambia, los colores de los objetos varían y la fricción es distinta.
Para probar la capacidad de generalización (Generalization) del modelo, SWM ofrece funciones para controlar los Factores de Variación (Factors of Variation, FoV). Esta funcionalidad, que permite ajustar libremente la iluminación, la textura y las propiedades físicas, es fundamental para verificar si el modelo funciona de manera robusta incluso en situaciones que nunca ha visto (Out-of-Distribution, OOD).
De hecho, cuando los investigadores utilizaron SWM para probar la robustez zero-shot de DINO-WM, confirmaron que muchos modelos existentes perdían rendimiento drásticamente ante cambios ambientales mínimos, como variaciones en el color o el tamaño. SWM actúa como un banco de pruebas riguroso que ayuda a identificar sistemáticamente estas "vulnerabilidades" y a desarrollar modelos más potentes capaces de superarlas.
Instalación y comienzo: Guía para construir el entorno de investigación
SWM es muy intuitivo en su proceso de instalación para que los investigadores puedan entrar en acción de inmediato.
1. Instalación básica Si solo necesita las funciones más básicas, puede instalarlo fácilmente a través de PyPI.
pip install stable-worldmodel2. Instalación con todas las funciones
Si desea incluir todos los entornos de simulación y diversas dependencias de entrenamiento, es recomendable añadir la opción [all].
pip install stable-worldmodel[all]3. Modo desarrollador y conjuntos de datos especiales
Para utilizar conjuntos de datos como LeRobot, se requiere un entorno con Python 3.12 o superior, y se puede instalar mediante una opción específica ([lerabit]). Si desea contribuir directamente a la librería, se recomienda clonar el repositorio de Git y configurar un entorno virtual utilizando uv.
Si se pregunta dónde se guardan los datos y los checkpoints del modelo, consulte la variable de entorno $STABLEWM_HOME. Por defecto, se guardan en una carpeta oculta en el directorio personal del usuario para facilitar su gestión.
Resumen y conclusión
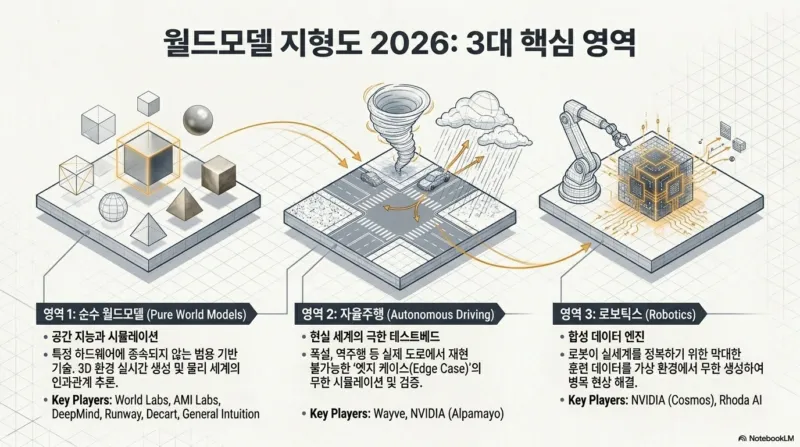
Stable World Model es una potente plataforma estándar que unifica la fragmentada investigación de modelos de mundo. A través de una capa de datos de alto rendimiento basada en Lance, una evaluación de generalización sofisticada mediante Factores de Variación (FoV) y un flujo de trabajo integrado desde la recolección hasta la evaluación, ha logrado capturar tanto la reproducibilidad como la eficiencia de la investigación.
Ahora, en lugar de gastar energía en la escritura repetitiva de código, concéntrese en las preguntas fundamentales sobre cómo los modelos pueden entender mejor el mundo. SWM será un socio sólido en su viaje de investigación.
¿Cuál es el mayor cuello de botella en su entorno de investigación? ¿La velocidad de carga de datos o los problemas de reproducibilidad? ¡Comparta sus inquietudes en los comentarios!
Referencias
- galilai-group/stable-worldmodel - GitHub · github.com
- Stable World-Model - GalilAI Group · galilai-group.github.io
- stable-worldmodel-v1: Reproducible World Modeling Research and ... · huggingface.co
- [논문 리뷰] stable-worldmodel: A Platform for Reproducible World ... · themoonlight.io



