새로운 세계 모델(World Model) 논문을 읽을 때마다 "이 코드를 내 환경에 맞춰 다시 짜려면 며칠이 걸릴까?"라는 막막함을 느껴본 적 있으신가요?
연구의 핵심은 혁신적인 모델 아키텍처나 새로운 목적 함수를 설계하는 것이지, 매번 똑같은 데이터 수집 스크립트와 환경 설정 코드를 짜는 '노가다'가 아닙니다. 하지만 2026년 현재까지도 많은 연구자가 파편화된 코드와 재현 불가능한 실험 환경 때문에 귀중한 시간을 낭비하고 있습니다.
이런 문제를 해결하기 위해 등장한 것이 바로 Stable World Model (SWM)입니다. 데이터 수집부터 학습, 그리고 모델 예측 제어(MPC)를 통한 평가까지, 월드 모델 연구의 전 과정을 하나의 표준화된 플랫폼으로 통합한 이 강력한 도구를 오늘 자세히 파헤쳐 보겠습니다.
연구자의 시간을 뺏는 '재현성 위기'와 SWM의 등장
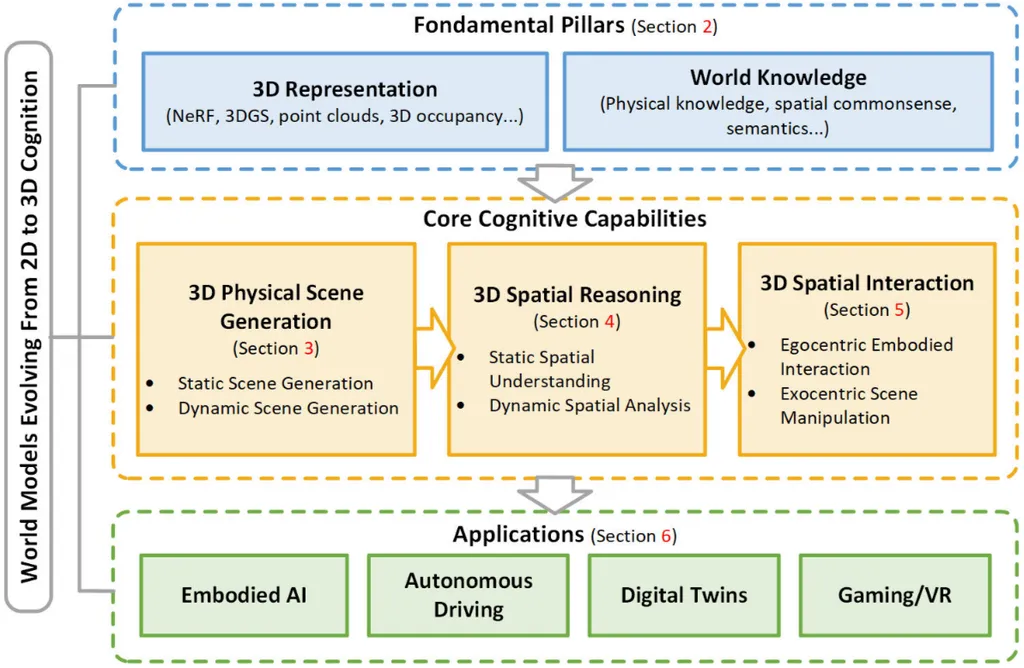
최근 AI 분야에서 세계 모델은 에이전트가 미래를 '상상'하고 계획할 수 있게 만드는 핵심 패러다임으로 급부상했습니다. 하지만 현장의 분위기는 그리 밝지만은 않습니다.
매번 새로운 논문이 나올 때마다 연구자들은 동일한 베이스라인, 동일한 평가 프로토콜, 동일한 데이터 처리 로직을 매번 처음부터 다시 구현해야 합니다. 마치 매번 요리법을 새로 만드는 게 아니라, 매번 가스레인지와 칼, 도마를 새로 제작해야 하는 상황과 같습니다. 이러한 재현성 위기(reproducibility crisis)는 연구의 공정한 비교를 방해하고 코드 버그로 인한 오류를 양산합니다.
GalilAI Group에서 공개한 stable-worldmodel은 바로 이 지점을 공략합니다. 이 라이브러리는 단순한 코드 모음이 아닙니다. 검증된 환경 스위트, 표준화된 데이터 레이어, 그리고 신뢰할 수 있는 플래닝 솔버를 갖춘 모듈형 연구 생태계입니다. 이제 연구자들은 반복적인 boilerplate 코드에서 벗어나, 모델의 성능을 높이는 진짜 핵심 연구에 집중할 수 있게 되었습니다.
단순한 도구를 넘어선 통합 워크플로우: 수집, 학습, 그리고 평가
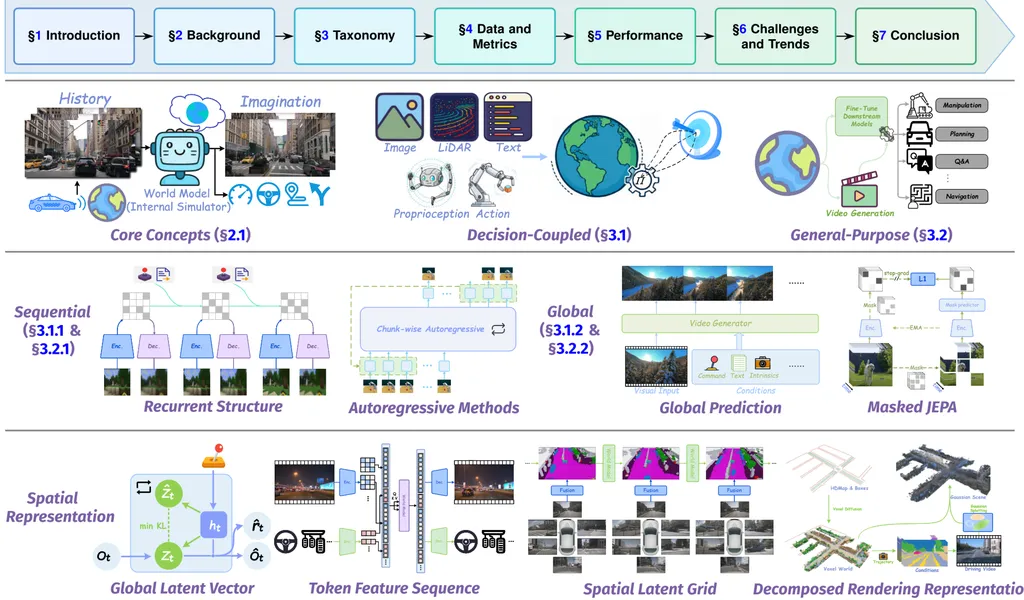
SWM의 가장 큰 매력은 데이터 수집부터 모델 평가까지 이어지는 통합 파이프라인에 있습니다. 이 과정은 마치 잘 짜인 공장의 자동화 라인처럼 매끄럽게 연결됩니다.
첫 번째 단계는 데이터 수집입니다. swm.World 객체를 생성하고 전문가 정책(Expert Policy)을 설정하면, 다중 병렬 환경에서 에피소드 데이터를 빠르게 모을 수 있습니다.
두 번째는 학습입니다. 수집된 데이터를 불러와 원하는 세계 모델 아키텍처를 인스턴스화하고 학습을 진행합니다. SWM은 다양한 최신 모델들을 베이스라인으로 제공하므로, 기존 연구와의 비교가 매우 용이합니다.
마지막은 평가입니다. SWM은 단순히 학습된 모델이 예측을 잘하는지 보는 것에 그치지 않습니다. **CEMSolver(**Cross-Entropy Method 기반)와 같은 계획 솔버를 사용하여, 모델이 예측한 미래를 바탕으로 실제 제어 성능이 얼마나 좋은지(Success Rate)를 측정합니다. 즉, 모델이 환경을 얼마나 잘 '이해'하고 있는지를 행동으로 증명하는 것입니다.
이러한 유기적인 흐름 덕분에 연구자는 swm/PushT-v1 같은 환경에서 단 몇 줄의 코드로 데이터 수집부터 최종 성공률 산출까지의 전체 과정을 경험할 수 있습니다.
데이터 병목 현상을 해결한 'Lance'의 압도적 성능
데이터가 커질수록 연구의 발목을 잡는 것은 모델의 구조보다 I/O(입출력) 속도입니다. 기존에 많이 쓰이던 HDF5 방식은 파일 하나로 관리하기엔 편하지만, 데이터를 계속 추가하거나 대규모 멀티모달 데이터를 읽어올 때 속도가 급격히 느려지는 고질적인 문제가 있었습니다.
SWM은 이 문제를 해결하기 위해 Lance라는 차세대 데이터 형식을 기본값으로 채택했습니다. 벤치마크 결과는 정말 놀랍습니다.
- 속도 혁명: 로컬 환경에서 Lance는 초당 약 4,814개의 샘플을 처리합니다. 이는 HDF5보다 압도적으로 빠른 속도입니다.
- 효율적인 용량: HDF5가 43.12GB를 차지할 때, Lance는 단 13.31GB만 사용합니다. 데이터 압축과 저장 효율성이 극대화된 결과입니다.
- 클라우드 확장성: Amazon S3 같은 원격 저장소를 사용할 때도 Lance는 캐싱을 통해 초당 3,100개 이상의 샘플을 처리하며, 데이터가 어디에 있든 병목 현상을 최소화합니다.
물론 모든 상황에 Lance가 정답은 아닙니다. 단일 파일로 데이터셋을 간편하게 배포하고 싶다면 HDF5가 여전히 유용할 수 있고, 아주 긴 에피소드를 저장할 때는 비디오 형식이 유리할 수 있습니다. 하지만 대규모 학습을 지향하는 현대적인 연구 흐름에서는 Lance가 명확한 승자입니다.
모델의 진짜 실력을 검증하는 법: 변화의 요소(FoV) 제어
모델이 학습 데이터와 똑같은 환경에서만 잘 작동한다면, 그것을 진정으로 '세계를 이해한다'고 말할 수 있을까요? 현실 세계는 빛이 변하고, 물체의 색깔이 바뀌며, 마찰력이 달라지는 역동적인 곳입니다.
SWM은 모델의 일반화 능력(Generalization)을 테스트하기 위해 변화의 요소(Factors of Variation, FoV)를 제어할 수 있는 기능을 제공합니다. 조명, 텍스처, 물리적 속성 등을 자유롭게 조절할 수 있는 이 기능은 모델이 처음 보는 상황(Out-of-Distribution, OOD)에서도 견고하게 작동하는지 검증하는 데 핵심적입니다.
실제로 연구진이 SWM을 활용해 DINO-WM의 제로 샷 견고성을 테스트했을 때, 많은 기존 모델이 색상이나 크기 변화 같은 작은 환경 변화에도 성능이 급격히 떨어지는 것을 확인했습니다. SWM은 이러한 '취약점'을 체계적으로 찾아내고, 이를 극복할 수 있는 더 강력한 모델을 개발할 수 있도록 돕는 가혹한 테스트베드 역할을 수행합니다.
설치 및 시작하기: 연구 환경 구축 가이드
SWM은 연구자들이 바로 실전에 투입될 수 있도록 설치 과정도 매우 직관적입니다.
1. 기본 설치 가장 기본적인 기능만 필요하다면 PyPI를 통해 간단히 설치할 수 있습니다.
pip install stable-worldmodel2. 모든 기능 포함 설치
시뮬레이션 환경과 다양한 훈련 의존성을 모두 포함하려면 [all] 옵션을 붙여주는 것이 좋습니다.
pip install stable-worldmodel[all]3. 개발자 모드 및 특수 데이터셋
LeRobot 데이터셋 등을 활용하려면 Python 3.12 이상의 환경이 필요하며, 별도의 옵션([lerabit])을 통해 설치할 수 있습니다. 만약 직접 라이브러리에 기여하고 싶다면 Git 저장소를 클론한 뒤 uv를 사용하여 가상 환경을 구성하는 것을 권장합니다.
데이터와 모델 체크포인트가 어디에 저장되는지 궁금하다면, 환경 변수 $STABLEWM_HOME을 확인하세요. 기본적으로는 사용자 홈 디렉토리의 숨김 폴더에 저장되어 관리가 용이합니다.
요약 및 마무리
Stable World Model은 파편화된 월드 모델 연구를 하나로 묶어주는 강력한 표준 플랫폼입니다. Lance 기반의 고성능 데이터 레이어, 변화의 요소(FoV)를 통한 정교한 일반화 평가, 그리고 데이터 수집부터 평가까지의 통합 워크플로우를 통해 연구의 재현성과 효율성을 동시에 잡았습니다.
이제 반복적인 코드 작성에 에너지를 쏟는 대신, 모델이 어떻게 세상을 더 잘 이해할 수 있을지에 대한 근본적인 질문에 집중해 보세요. SWM이 여러분의 연구 여정에 든든한 파트너가 되어줄 것입니다.
여러분의 연구 환경에서는 어떤 부분이 가장 큰 병목인가요? 데이터 로딩 속도인가요, 아니면 재현성 문제인가요? 댓글로 여러분의 고민을 나누어 주세요!
참고자료
- galilai-group/stable-worldmodel - GitHub · github.com
- Stable World-Model - GalilAI Group · galilai-group.github.io
- stable-worldmodel-v1: Reproducible World Modeling Research and ... · huggingface.co
- [논문 리뷰] stable-worldmodel: A Platform for Reproducible World ... · themoonlight.io