如果您是最近在处理 AI 模型或构建自动化工作流的人员,可能都曾遇到过这样的瓶颈:“啊,该如何把这些 PDF 数据(或 Excel、图像)干净利落地喂给 GPT 呢?”
数据明明非常庞大且有价值,但由于格式各异,在交给 AI 处理之前,往往面临着必须全部重构的窘境。我自己在最近的一个项目中,也曾为了将数百个 Word 文件和 Excel 表格逐一转换为文本而彻夜难眠。编写 Python 脚本、组合各种库、还要与排版错乱的问题作斗争,往往在真正重要的“分析”工作还没开始之前,就已经精疲力竭了。
但在 2026 年的今天,随着微软(Microsoft)推出的 MarkItDown 工具的出现,我们终于可以从这种令人厌烦的“数据预处理瓶颈”中解脱出来。今天,我想和大家聊聊为什么这个创新的工具会被开发者和数据科学家们称为“智能体(Agent)的必备工具”。
数据预处理的泥潭:为什么我们总是如此痛苦
当我们使用 AI 模型,特别是像 GPT-4o 这样的超大规模语言模型(LLM)时,最关键的是“数据质量”。然而,现实情况并不乐观。因为我们掌握的知识往往以 PDF、Word、Excel,甚至是图像或音频文件等“非结构化数据”的形式分散存在。
将这些数据转换为 AI 能够很好理解的标准形式的过程,即 数据预处理(Data Preprocessing),是占据整个工作时间 80% 以上的主要罪魁祸首。问题不仅仅在于抓取文字。如果表格(Table)的结构被破坏,或者标题(Heading)的层级错乱,AI 就会丢失上下文,从而给出错误的回答。
以往为了解决这个问题,我们需要使用 textract 之类的工具,或者组合复杂的解析库来构建自己的转换器。但随着文件格式的增加,需要管理的依赖关系呈爆炸式增长,代码的复杂度也变得难以承受。这就像是想做饭,结果光是处理食材就花掉了一整天。
MarkItDown 的登场:化繁为简的魔法
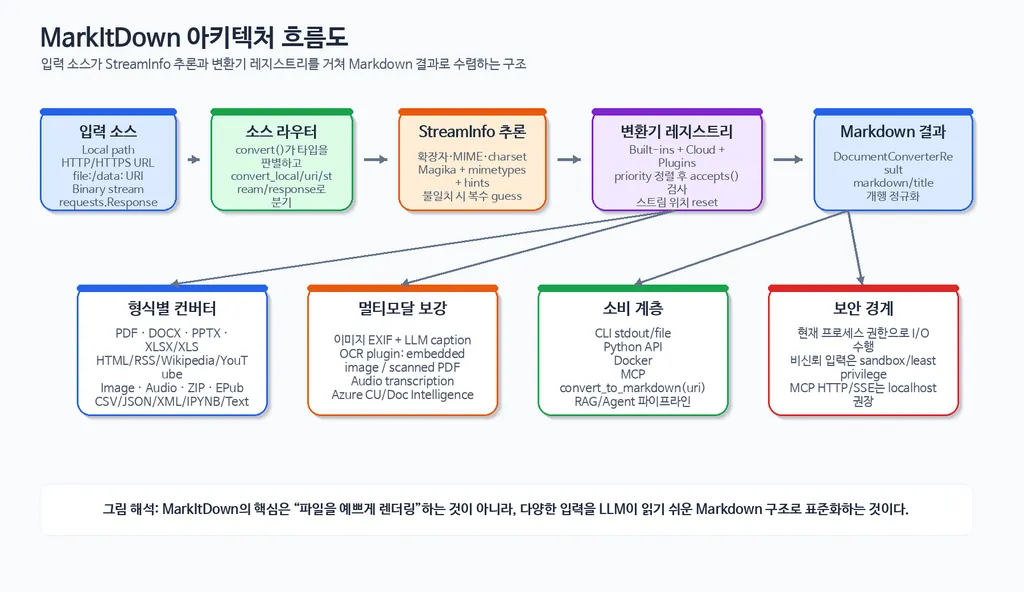
就在这时,微软的 MarkItDown 像救星一样出现了。顾名思义,这是一个基于 Python 的轻量级实用工具,能将各种文件格式转换为最具通用性且具有结构性的文本格式——Markdown。
为什么这个工具会受到如此热烈的关注?因为它不仅仅是实现了“转换”这一功能,更重要的是它能够 保留文档的语义结构。
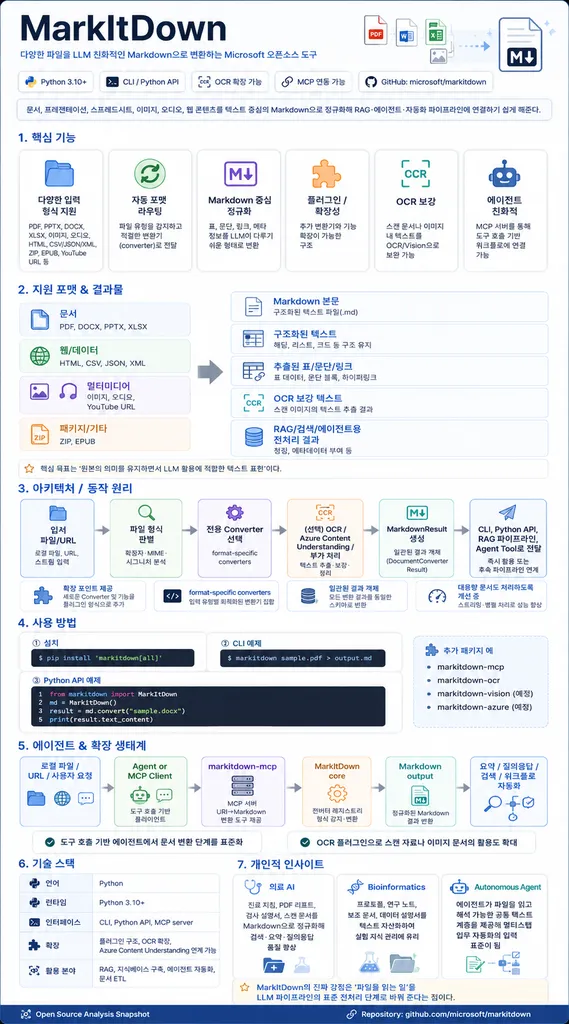
MarkItDown 展示了令人惊叹的通用性:
- Office 文档的完美转换:能够将 Word (.docx)、Excel (.xlsx)、PowerPoint (.pptx) 的表格和标题层级精确地映射到 Markdown 语法中。
- 多模态响应:放入图像时可以提取 EXIF 元数据,甚至通过连接 LLM(如 GPT-4o),还可以生成描述图像内容的文本。
- 媒体处理:具备将音频文件的语音转录(Transcription)为文本,以及从 YouTube URL 中提取字幕的功能。
- 数据标准化:从 HTML、JSON、XML、CSV 等数据格式,到 ZIP 压缩包内部的文件,都能一并精炼为 Markdown。
这就像是获得了一个“智能食物处理器”,只要把堆积如山的复杂食材丢进去,它就能立即将其处理成最适合烹饪的状态。
如何使用?仅需 4 行代码就足够了
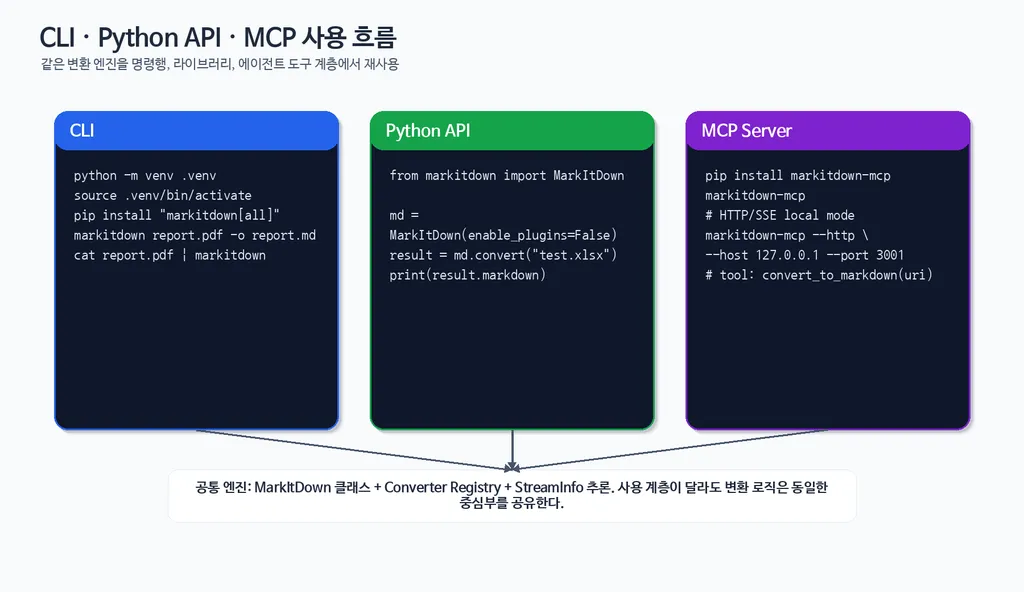
MarkItDown 最大的魅力在于其“压倒性的简洁”。无需复杂的配置,即可在 Python 环境中非常直观地使用。在 2026 年,许多开发者正通过该工具构建数据流水线。
让我们来看看最基本的使用方法:
from markitdown import MarkItDown

# 创建 MarkItDown 实例
md = MarkItDown()

# 将文件转换为 Markdown
result = md.convert("my_report.xlsx")

# 输出结果
print(result.text_content)
非常简单吧?如果你想要更强大的功能,例如让 AI 读取图像内容,只需连接 OpenAI 的客户端即可。
from openai import OpenAI
from markitdown import MarkItDown

client = OpenAI(api_key="your_api_key")
# 使用 GPT-4o 实现包含图像描述的高级转换模式
md = MarkItDown(llm_client=client, llm_model="gpt-4o")

result = md.convert("complex_chart.png")
print(result.text_content)
通过这种方式,你不仅能获得 OCR 功能,还能获得包含图表含义或图像上下文的丰富 Markdown 数据。这正是 AI 智能体理解世界的方式。
当然,没有什么是完美的。使用时也有明确的注意事项:
- 安全问题:MarkItDown 目前以当前进程的权限执行输入输出操作。因此,在转换来源不明的文件时,务必进行输入校验(Sanitize)。
- PDF 的局限性:对于未经 OCR 处理的“图像型 PDF”,文本提取可能会受限,复杂的布局也可能无法完美还原。
- 依赖管理:若要使用多样化的功能,需要安装额外的包,例如
pip install 'markitdown[all]'。为了避免库之间的冲突,使用 虚拟环境(Virtual Environment) 是必不可少的。
智能体时代,数据流水线的新标准
MarkItDown 已不仅仅是一个简单的工具,它正逐渐成为 AI 智能体活动环境中的 核心基础设施。
过去,人们需要手动打开文件并复制粘贴文本;而现在,通过 MarkItDown 构建的自动化流水线可以在瞬间将成千上万份文档转换为 Markdown,并将其作为 LLM 的训练数据或 RAG(检索增强生成)系统的索引数据进行供给。
特别是该工具非常容易结合 FastAPI 等 Web 框架以 API 的形式进行部署。这使得企业能够构建属于自己的“文档转换服务”,或将其连接到 Zapier、n8n 等工作流自动化工具,从而提升企业内部知识管理系统(Knowledge Management System)的水平。
归根结底,在数据决定 AI 智能程度的时代,如何高效地“精炼”数据至关重要。MarkItDown 极大地降低了这一精炼过程的成本,让数据科学家能够专注于更有价值的分析与建模。
结语:您的工作流准备好了吗?
到目前为止,我们深入探讨了微软的创新工具 MarkItDown。
总结来说,这是一个能够将 PDF、Office、媒体等多种格式轻松转换为 AI 最喜欢的 Markdown 格式的强大预处理工具。对于所有希望简化复杂数据流水线、最大化 AI 智能体效率的人来说,它都将是最佳选择。
如果您正挣扎在数据预处理的泥潭中,何不放下笨重的工具,将轻便而强大的 MarkItDown 装进您的工具箱呢?
您目前是如何为 AI 模型准备数据的呢?如果您有任何独特的数据预处理秘诀,欢迎在评论区分享!
参考资料
- markitdown · pypi.org
- Deep Dive into Microsoft MarkItDown · dev.to
- MarkItDown, Microsoft가 공개한 PDF, 이미지 및 오피스 문서 ... · discuss.pytorch.kr
- MarkItDown : MS 의 문서 파일 변환 도구 (to Markdown) · 42morrow.tistory.com
- MarkItDown · marketplace.visualstudio.com



