最近、AIモデルを扱ったり自動化ワークフローを構築したりしている方なら、一度はこのような壁にぶつかったことがあるはずです。「あぁ、このPDFデータ(またはExcel、画像)をどうすればGPTに綺麗に読み込ませることができるんだろう?」という悩みです。
データは膨大で価値があるはずなのに、いざAIに渡そうとすると形式がバラバラで、すべて作り直さなければならない状況。私自身も最近のプロジェクトで、数百個のWordファイルとExcelシートを一つずつテキストに変換し、徹夜したことがあります。Pythonスクリプトを書き、ライブラリを組み合わせ、レイアウトが崩れる問題と格闘しているうちに、肝心の「分析」を始める前に疲れ果ててしまうことも少なくありません。
しかし、2026年現在、マイクロソフト(Microsoft)がリリースしたMarkItDownというツールに出会うことで、この忌々しい「データ前処理のボトルネック」から解放されることができました。今日は、この革新的なツールがなぜ開発者やデータサイエンティストたちに「エージェントの必須ツール」と呼ばれているのか、その興味深いお話をお伝えします。
データ前処理の沼:なぜ私たちは常に苦労するのか
私たちがAIモデル、特にGPT-4oのような大規模言語モデル(LLM)を使用する際、最も重要なのは「データの品質」です。しかし、現実はそう甘くありません。私たちが持つ知識は、PDF、Word、Excel、さらには画像やオーディオファイルのような「非定型データ」の形で散らばっているからです。
これらのデータをAIが理解しやすい標準的な形式に変換するプロセス、すなわち**データ前処理(Data Preprocessing)**は、全作業時間の80%以上を占める主犯格です。単に文字をスクレイピングするだけでは済みません。表(Table)の構造が崩れたり、見出し(Heading)の階層が崩れたりすると、AIは文脈を見失い、的外れな回答を出してしまうことになります。
従来はこれを解決するためにtextractのようなツールを使ったり、複雑なパージングライブラリを組み合わせて自分専用の変換器を作ったりする必要がありました。しかし、ファイル形式が増えるにつれて管理すべき依存関係は爆発し、コードの複雑度は手に負えないほど高まっていきました。まるで料理をしようとしているのに、材料の下ごしらえだけで一日が終わってしまうようなものです。
MarkItDownの登場:複雑さを単純さに変える魔法
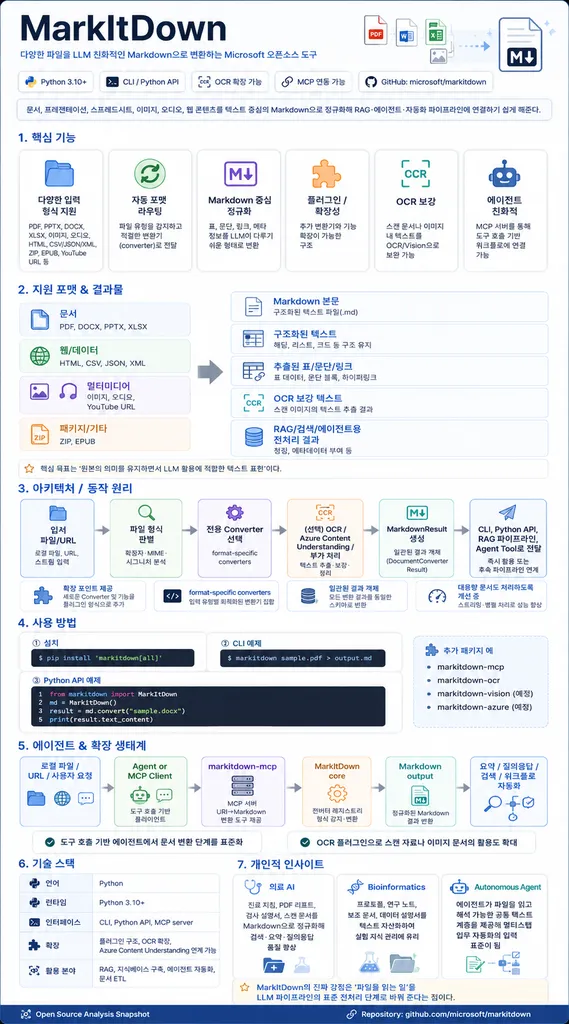
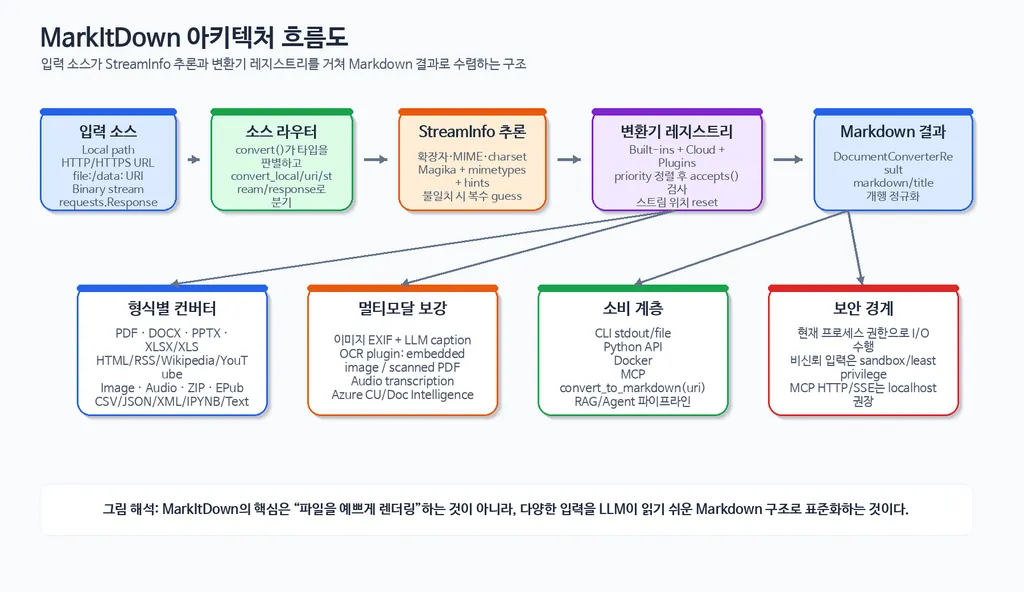
ここで救世主のように登場したのが、マイクロソフトのMarkItDownです。このツールは、その名の通り、多様なファイル形式を最も汎用的で構造的なテキスト形式である**Markdown(マークダウン)**に変換してくれるPythonベースの軽量ユーティリティです。
なぜこのツールがこれほどまでに熱い関心を集めているのでしょうか? 単に「変換ができる」というレベルを超えて、文書の意味的な構造を保持するからです。
MarkItDownは、以下のような驚くべき汎用性を示します:
- オフィス文書の完璧な変換: Word(.docx)、Excel(.xlsx)、PowerPoint(.pptx)の表や見出しの階層を、マークダウン記法に精巧にマッピングします。
- マルチモーダル対応: 画像を投入するとEXIFメタデータを抽出、さらにはLLM(例:GPT-4o)と連携すれば、画像内の内容を説明するテキストまで生成します。
- メディア処理: オーディオファイルの音声をテキストに文字起こし(Transcription)したり、YouTubeのURLから字幕を抽出したりする機能まで備えています。
- データの標準化: HTML、JSON、XML、CSVといったデータ形式から、ZIP圧縮ファイル内のファイルまで、一度にマークダウンへと精製します。
まるで山のように積み上がった複雑な食材を投入するだけで、すぐに調理可能な状態に整えてくれる「スマート・フードプロセッサー」を手に入れたようなものです。
どうやって使うのですか? たった4行あれば十分です
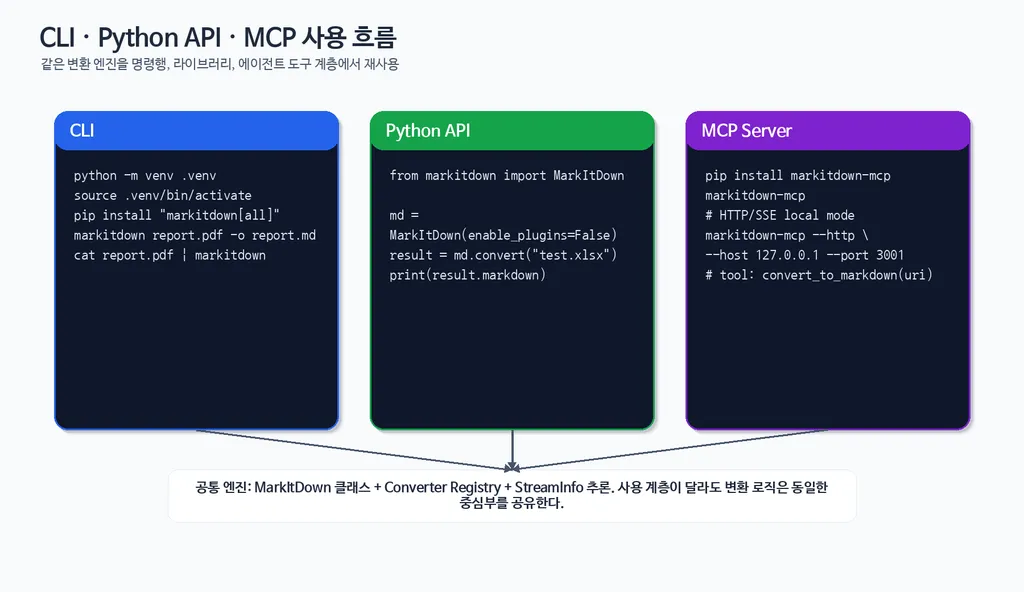
MarkItDownの最大の魅力は「圧倒的な簡潔さ」です。複雑な設定なしに、Python環境で非常に直感的に使用できます。2026年現在、多くの開発者がこのツールを通じてデータパイプラインを構築しています。
最も基本的な使い方を見てみましょう。
from markitdown import MarkItDown

# MarkItDownのインスタンス生成
md = MarkItDown()

# ファイルをマークダウンに変換
result = md.convert("my_report.xlsx")

# 結果を出力
print(result.text_content)
本当に簡単ですよね? もし、より強力な機能、例えば「画像のの内容をAIに読み取らせたい」のであれば、OpenAIのクライアントを接続するだけです。
from openai import OpenAI
from markitdown import MarkItDown

client = OpenAI(api_key="your_api_key")
# GPT-4oを使用して画像の説明まで含む高度な変換モード
md = MarkItDown(llm_client=client, llm_model="gpt-4o")

result = md.convert("complex_chart.png")
print(result.text_content)
こうすることで、単純なOCRを超えて、チャートの意味や画像の文脈まで含まれた豊かなマークダウンデータを獲得できます。これこそが、AIエージェントが世界を理解する方式です。
もちろん、すべてが完璧というわけではありません。使用上の注意点も明確です。
- セキュリティ問題: MarkItDownは現在実行中のプロセスの権限で入出力作業を行います。したがって、出所が不明なファイルを変換する際は、必ず入力を検証(Sanitize)する必要があります。
- PDFの限界: OCR処理がされていない「画像形式のPDF」の場合、テキスト抽出に限界があることがあり、複雑なレイアウトは完全に再現されない可能性があります。
- 依存関係の管理: 多様な機能を使うには
pip install 'markitdown[all]'のように追加パッケージをインストールする必要がありますが、その際、ライブラリ間の衝突を避けるために**仮想環境(Virtual Environment)**の使用は必須です。
エージェント時代、データパイプラインの新しい標準
MarkItDownは単なるユーティリティを超え、AIエージェントが活動する環境の核心的なインフラとして定着しつつあります。
かつては人間が一つひとつファイルを開いてテキストをコピー&ペーストしていましたが、今やMarkItDownを通じて構築された自動化パイプラインが、数千、数万の文書を瞬時にマークダウンに変換し、LLMの学習データやRAG(検索拡張生成)システムのインデックスデータとして供給します。
特にこのツールは、FastAPIのようなWebフレームワークと組み合わせてAPI形式でデプロイすることが非常に容易です。これは、企業が独自の「文書変換サービス」を構築したり、Zapierやn8nのようなワークフロー自動化ツールと連携して、企業内の知識管理システム(Knowledge Management System)を高度化する上で決定的な役割を果たします。
結局のところ、データをいかに上手く「精製」できるかが、AIの知能を決定する時代なのです。MarkItDownはその精製プロセスのコストを劇的に下げ、データサイエンティストがより価値のある分析やモデリングに集中できる環境を作り出しています。
おわりに:あなたのワークフローは準備できていますか?
ここまで、マイクロソフトの革新的なツール、MarkItDownについて深く掘り下げてきました。
要約すると、このツールはPDF、Office、メディアなど様々な形式を、AIが最も好むマークダウンへと手軽に変換してくれる強力な前処理ツールです。複雑なデータパイプラインを単純化し、AIエージェントの効率を最大化しようとするすべての人にとって、最高の選択肢となるでしょう。
データ前処理の沼でもがいているなら、重いツールではなく、軽快で強力なMarkItDownをあなたのツールボックスに加えてみてはいかがでしょうか?
皆さんは現在、AIモデルのためにどのようにデータを準備していますか? もし皆さん独自のデータ前処理のコツがあれば、ぜひコメントで共有してください!
参考文献
- markitdown · pypi.org
- Deep Dive into Microsoft MarkItDown · dev.to
- MarkItDown, Microsoft가 공개한 PDF, 이미지 및 오피스 문서 ... · discuss.pytorch.kr
- MarkItDown : MS 의 문서 파일 변환 도구 (to Markdown) · 42morrow.tistory.com
- MarkItDown · marketplace.visualstudio.com



