Si eres de los que trabaja con modelos de IA o construye flujos de trabajo automatizados, es probable que te hayas topado con este muro alguna vez: "¿Cómo puedo hacer que GPT lea estos datos de PDF (o Excel, o imágenes) de forma limpia?".
Los datos son abundantes y valiosos, pero al intentar pasárselos a la IA, sus formatos son tan diversos que te ves obligado a reestructurarlo todo. Yo mismo, en un proyecto reciente, pasé noches en vela convirtiendo cientos de archivos Word y hojas de Excel a texto uno por uno. Entre escribir scripts de Python, combinar librerías y luchar contra problemas de diseño de página (layout), uno termina agotado antes siquiera de empezar el verdadero trabajo: el "análisis".
Sin embargo, en este 2026, al descubrir la herramienta MarkItDown lanzada por Microsoft, he podido liberarme de este tedioso "cuello de botella del preprocesamiento de datos". Hoy, quiero contarles la fascinante historia de por qué esta herramienta innovadora se está convirtiendo en una "herramienta esencial para agentes" entre desarrolladores y científicos de datos.
El pantano del preprocesamiento de datos: ¿Por qué siempre sufrimos?
Cuando utilizamos modelos de IA, especialmente modelos de lenguaje de gran tamaño (LLM) como GPT-4o, lo más importante es la "calidad de los datos". Pero la realidad no es tan sencilla. Esto se debe a que el conocimiento que poseemos está disperso en "datos no estructurados", como archivos PDF, Word, Excel, e incluso imágenes o archivos de audio.
El proceso de convertir estos datos a un formato estándar que la IA pueda entender fácilmente, es decir, el preprocesamiento de datos (Data Preprocessing), es el principal culpable de consumir más del 80% del tiempo total de trabajo. No se trata solo de extraer texto. Si la estructura de las tablas (Tables) se rompe o la jerarquía de los títulos (Headings) se pierde, la IA perderá el contexto y dará respuestas erróneas.
Antes, para resolver esto, teníamos que usar herramientas como textract o combinar complejas librerías de parsing para crear nuestro propio convertidor. Pero a medida que aumentaban los formatos de archivo, las dependencias que debíamos gestionar explotaban y la complejidad del código se volvía inmanejable. Es como querer cocinar y pasar todo el día solo preparando los ingredientes.
El surgimiento de MarkItDown: La magia de convertir la complejidad en simplicidad
Aquí es donde entra como un salvador MarkItDown de Microsoft. Como su nombre indica, es una utilidad ligera basada en Python que convierte diversos formatos de archivo al formato de texto más versátil y estructurado: Markdown.
¿Por qué está recibiendo tanta atención? Porque va más allá de una simple "conversión"; lo que hace es preservar la estructura semántica del documento.
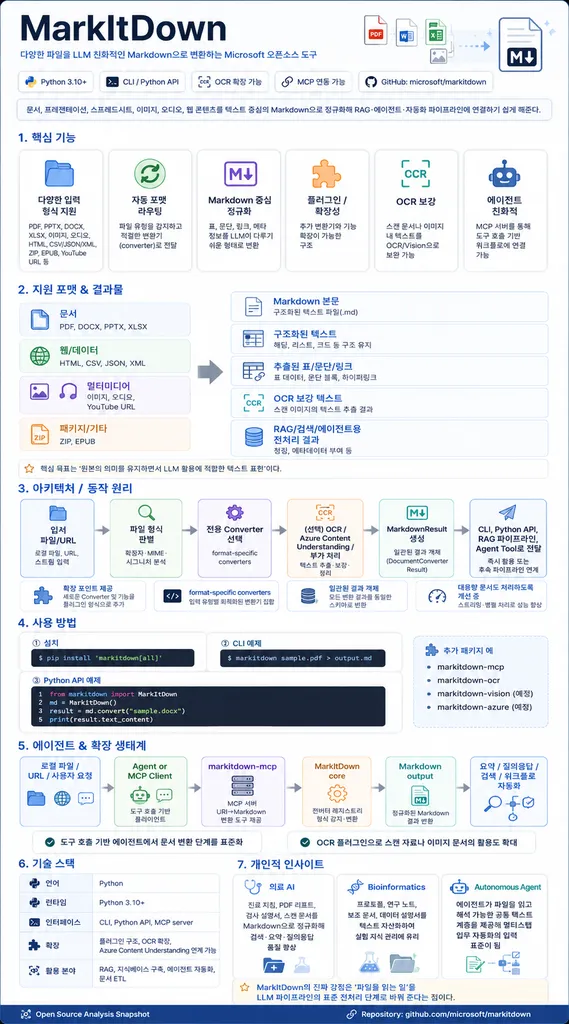
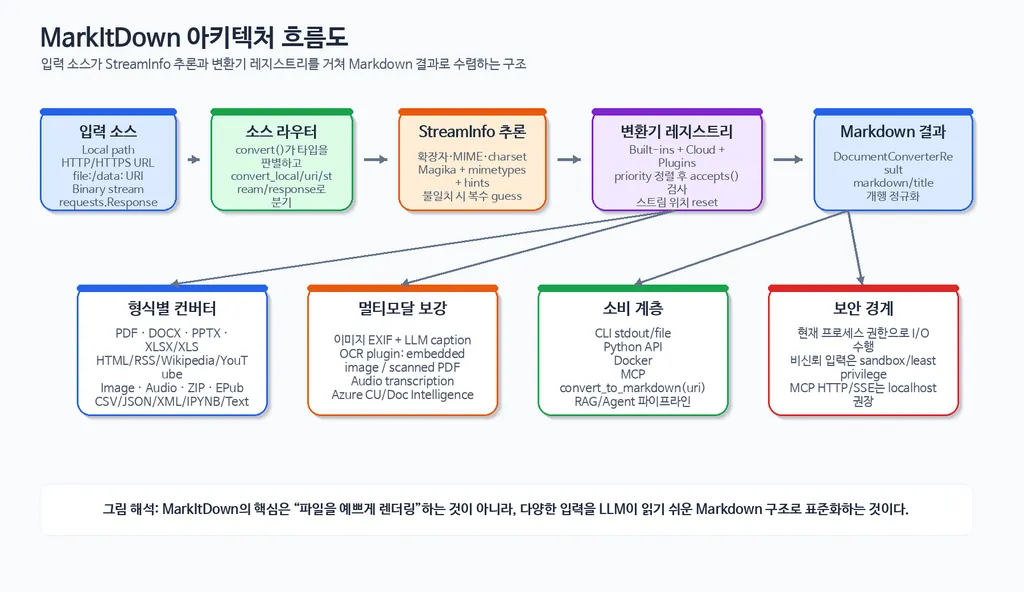
MarkItDown muestra una versatilidad asombrosa:
- Conversión perfecta de documentos de Office: Mapea con precisión las tablas y la jerarquía de títulos de Word (.docx), Excel (.xlsx) y PowerPoint (.pptx) utilizando la sintaxis de Markdown.
- Capacidad multimodal: Si introduces una imagen, extrae los metadatos EXIF e incluso, si se conecta con un LLM (como GPT-4o), puede generar texto que describa el contenido de la imagen.
- Procesamiento de medios: Tiene funciones para transcribir el audio de archivos de sonido o extraer subtítulos de URLs de YouTube.
- Estandarización de datos: Refina en Markdown desde formatos de datos como HTML, JSON, XML y CSV, hasta archivos contenidos dentro de archivos comprimidos ZIP.
Es como tener un "procesador de alimentos inteligente" al que solo le lanzas una montaña de ingredientes complejos y te devuelve todo listo para cocinar.
¿Cómo se usa? Con solo 4 líneas es suficiente
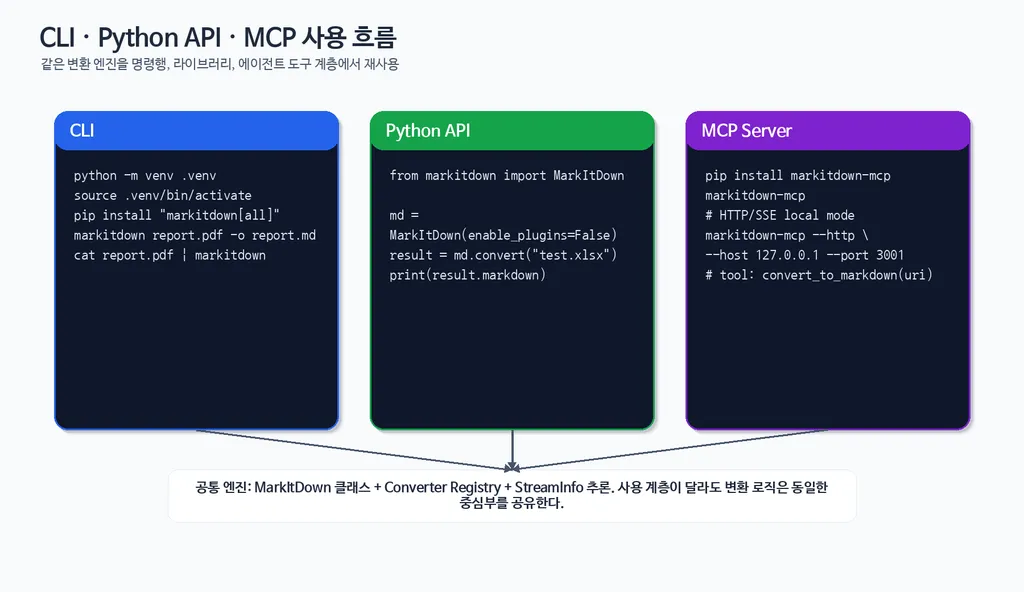
El mayor atractivo de MarkItDown es su "simplicidad abrumadora". Se puede usar de forma muy intuitiva en un entorno Python sin configuraciones complejas. En este 2026, muchos desarrolladores ya están construyendo sus pipelines de datos con esta herramienta.
Veamos el uso más básico:
from markitdown import MarkItDown

# Crear una instancia de MarkItDown
md = MarkItDown()

# Convertir un archivo a Markdown
result = md.convert("my_report.xlsx")

# Imprimir el resultado
print(result.text_content)
¿Verdad que es sencillo? Si quieres funciones más potentes, como hacer que la IA lea el contenido de una imagen, solo tienes que conectar el cliente de OpenAI.
from openai import OpenAI
from markitdown import MarkItDown

client = OpenAI(api_key="tu_api_key")
# Modo de conversión avanzado que incluye descripción de imágenes usando GPT-4o
md = MarkItDown(llm_client=client, llm_model="gpt-4o")

result = md.convert("complex_chart.png")
print(result.text_content)
De esta manera, más allá de un simple OCR, obtendrás datos en Markdown enriquecidos con el significado de los gráficos o el contexto de las imágenes. Así es como los agentes de IA comprenden el mundo.
Por supuesto, nada es perfecto. También hay puntos claros a tener en cuenta al usarlo:
- Problemas de seguridad: MarkItDown realiza operaciones de entrada y salida con los permisos del proceso actual. Por lo tanto, al convertir archivos de fuentes desconocidas, es imprescindible validar (Sanitize) la entrada.
- Limitaciones de PDF: En el caso de "PDFs de imagen" que no han pasado por un proceso de OCR, puede haber limitaciones en la extracción de texto, y los diseños complejos podrían no replicarse perfectamente.
- Gestión de dependencias: Para usar diversas funciones, es necesario instalar paquetes adicionales como
pip install 'markitdown[all]'. En este caso, el uso de un entorno virtual (Virtual Environment) es esencial para evitar conflictos entre librerías.
La era de los agentes: El nuevo estándar de los pipelines de datos
MarkItDown va más allá de ser una simple utilidad; se está posicionando como una infraestructura clave en el entorno donde operan los agentes de IA.
Antes, las personas tenían que abrir archivos uno por uno para copiar y pegar texto; ahora, un pipeline automatizado construido con MarkItDown puede convertir miles o decenas de miles de documentos a Markdown en un instante, suministrándolos como datos de entrenamiento para LLMs o como datos de indexación para sistemas RAG (Generación Aumentada por Recuperación).
Especialmente, esta herramienta es muy fácil de desplegar en forma de API al combinarse con frameworks web como FastAPI. Esto juega un papel decisivo para que las empresas construyan sus propios "servicios de conversión de documentos" o los conecten con herramientas de automatización de flujos de trabajo como Zapier o n8n para modernizar sus sistemas de gestión del conocimiento (Knowledge Management Systems).
En última instancia, estamos en una era donde la inteligencia de la IA está determinada por qué tan bien se "refinan" los datos. MarkItDown está reduciendo drásticamente el coste de ese proceso de refinamiento y creando un entorno donde los científicos de datos pueden concentrarse en análisis y modelado de mayor valor.
Conclusión: ¿Está preparado tu flujo de trabajo?
Hasta ahora, hemos explorado en profundidad la innovadora herramienta de Microsoft, MarkItDown.
En resumen, es una potente herramienta de preprocesamiento que convierte fácilmente diversos formatos (PDF, Office, medios, etc.) al formato Markdown, que es el preferido por la IA. Será la mejor opción para todos aquellos que busquen simplificar sus complejos pipelines de datos y maximizar la eficiencia de los agentes de IA.
Si te sientes hundido en el pantano del preprocesamiento de datos, ¿por qué no dejar de lado las herramientas pesadas y añadir la ligera y potente MarkItDown a tu caja de herramientas?
¿Cómo estás preparando tus datos actualmente para los modelos de IA? Si tienes algún truco especial de preprocesamiento de datos, ¡compártelo en los comentarios!
Referencias
- markitdown · pypi.org
- Deep Dive into Microsoft MarkItDown · dev.to
- MarkItDown, Microsoft가 공개한 PDF, 이미지 및 오피스 문서 ... · discuss.pytorch.kr
- MarkItDown : MS 의 문서 파일 변환 도구 (to Markdown) · 42morrow.tistory.com
- MarkItDown · marketplace.visualstudio.com



