作为一名开发者,可能都会经历这样的时刻:在面临重要的部署任务时,突然推送代码却跳出“Connection Timeout”的消息,或者 Pull Request (PR) 页面突然卡死。那一瞬间,心会猛地沉下去,脑海中不由自主地浮现出:“到底是怎么回事?”
在最近的 2026 年 5 月,全球数百万开发者所依赖的 GitHub 发生了一场大规模事故,将这种恐惧变成了现实。这次故障不仅仅是服务器暂时变慢的问题,更是一场“复合型故障”——从 Pull Requests、Issues、Git 操作到 API 请求,GitHub 的核心引擎同时发生了动摇。
今天,我们将深入剖析这次事件发生的原因,以及我们在构建开发环境时应该做好哪些准备。
意想不到的连锁反应:为什么 GitHub 会停摆?
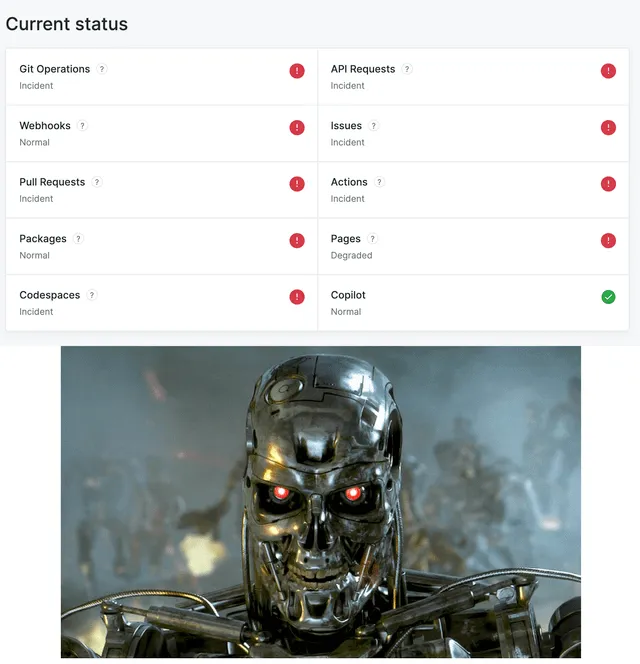
这次故障最可怕的地方在于它表现出了“连锁故障 (Cascade Failure)”的特征。这并非仅仅是一台服务器损坏,而是一个多个进程环环相扣、接连崩溃的结构。
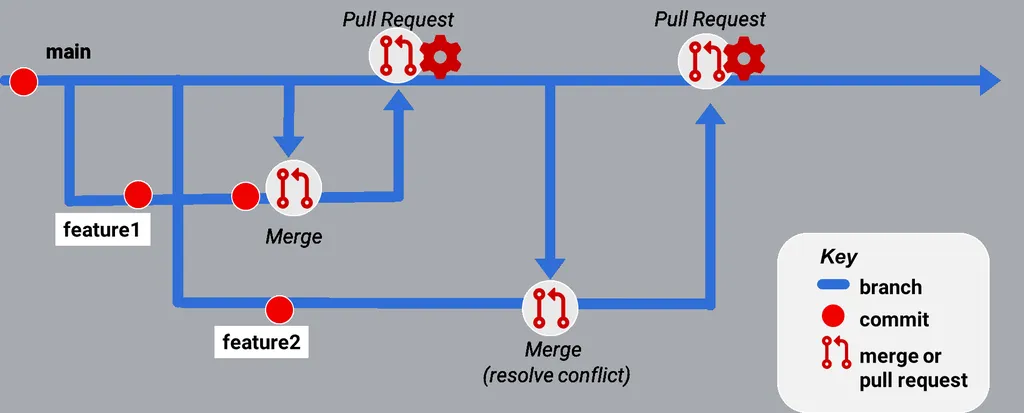
事件的起因始于大规模 Pull Request 的合并过程。为了处理海量的代码变更,克隆和合并 Git 仓库的计算量激增,瞬间耗尽了服务器资源。但问题远不止于此。
GitHub 的系统是高度有机连接的。随着 Git 操作出现延迟,本应与之实时联动的 API 端点 (Endpoints) 开始无法响应。由于 API 响应变慢,等待响应的其他服务纷纷抛出超时 (Timeout) 错误,最终导致 Issue 追踪器和 PR 管理系统像多米诺骨牌一样接连倒塌。
特别让开发者感到头疼的是数据不一致问题。在 Git 推送事件通过 API 传递到 Issue 系统过程中,由于同步失效,出现了即便 Bug 已解决但 Issue 仍处于“Open”状态,或者已完成的工作被重复报告等混乱情况。这已经超越了单纯的技术错误,而是对整个开发团队工作流造成了致命打击。
事后分析 (Post-mortem) 的困境:能否找到真正的根源?
在事故处理完毕后,社区(如 Hacker News 等)展开了激烈的讨论。争论的核心在于:“GitHub 提供的事故后分析是否足够充分?”
技术社区的部分专家对此反应冷淡。有人指出:“要对以这种速度发生的所有问题进行完美的事故后分析,在物理上是不可能的。”如果企业仅仅给出一个“部署前分析不足”这种表面化的结论,那么这并不能被视为真正意义上的根源分析 (Root Cause Analysis)。
另一方面,也有现实的反对意见认为,为了调查组织性问题,需要投入更多的时间和人力。其逻辑是,如果每次故障都要深挖每一个细节,可能会拖慢服务恢复的速度。
这里有一个有趣的切入点:为了解决技术债,人们正在讨论引入 AI 工具。与其让人类工程师翻遍所有日志,不如让 AI 分析模式,从而发现故障的前兆,或者寻找复杂日志之间的相关性。这预示着管理大型平台可靠性的方式正在发生改变,而不仅仅是解决技术问题本身。
实战应对指南:API 速率限制与确保系统稳定性
虽然我们无法控制这些巨型平台的故障,但我们可以控制自己编写的代码和系统设计。针对此次 GitHub 事故,我整理了开发者在实务中必须掌握的 API 及系统管理策略。
1. 聪明地处理 API 速率限制 (Rate Limit)
包括 GitHub 在内的多数服务为了保护服务器资源,都会限制 API 调用次数。无视这一限制可能会导致服务被封禁。
- 身份验证 (Authentication) 是必须的:未经验证的用户每小时限制为 60 次调用,但如果使用个人访问令牌 (PAT) 等进行身份验证,限制将大幅提升至每小时 5,000 次。这是最简单且确定的“升级”方法。
- 利用条件性 GET 请求:无需每次都检查数据是否发生了变化。通过使用
ETag或Last-Modified请求头,设计成如果数据未变则接收304 Not Modified响应。在这种情况下,不会消耗速率限制计数。 - GraphQL 优化:REST API 是以调用次数为标准,而 GraphQL 是以查询复杂度(分数)为标准。应准确请求所需的字段,以避免“分数”浪费。
2. 实现指数退避 (Exponential Backoff)
当 API 返回超时或 5xx 错误时,立即进行重复重试 (Retry) 无异于火上浇油。
最近,利用 GitHub Copilot Chat 等 AI 工具可以轻松解决这个问题。例如,在使用 Python 的 requests 库时,建议添加将重试间隔按指数级增加的指数退避逻辑。
- 示例:等待 1 秒 等待 2 秒 等待 4 秒 等待 8 秒... 这种方式可以在逐渐减轻服务器压力的同时,提高成功的概率,是一种非常优雅的解决方案。
3. 养成异步处理与 Webhook 的习惯
为了实现实时更新而不断调用 API (Polling) 是非常危险的。相反,应采用 Webhook 方式,即在服务器发生事件时向我们发送信号。这可以在显著减少 API 调用次数的同时,提高系统的响应能力。
结语:迈向可靠的开发生态系统
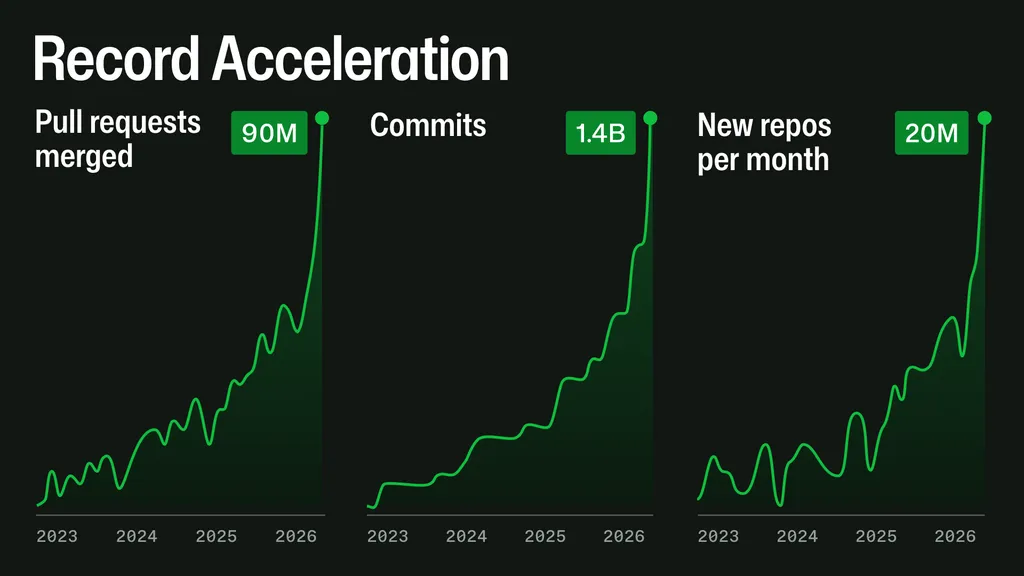
这次 GitHub 事故给我们留下了重要的教训。现代软件开发环境是由代码仓库、Issue 追踪器以及无数外部 API 交织而成的巨大网络。我们亲眼目睹了,一旦网络的一部分断裂,整个系统都可能随之动摇。
其核心在于“韧性 (Resilience)”。虽然无法阻止平台的故障,但如何设计我们的系统,使其在故障发生时能够灵活应对并快速恢复到正常轨道,这正是高级开发者的核心能力。
不仅仅是编写代码,更要培养理解整个系统流向与连接关系的眼光。熟知 API 的限制、设计重试逻辑、构建自动化监控机制,这一切都是开始。
在你的代码中,为了应对故障,已经准备好了多少“安全装置”呢?
在你的项目中,是如何管理 API 故障或速率限制问题的?欢迎在评论区分享你的心得!
参考资料
- Incident with Pull Requests, Issues, Git Operations and API Requests · news.ycombinator.com
- An update on GitHub availability · github.blog
- Incident History - GitHub Status · githubstatus.com
- API 속도 제한 처리 - GitHub 문서 · docs.github.com
- [질문] "API 속도 제한 초과" 정확히 어떻게 제한을 업그레이드하나요? · reddit.com
- GitHUB API Rate limiting - velog · velog.io