開発者なら誰もが一度はこのような経験があるはずです。重要なデプロイを控えてコードをプッシュしたのに、突然「Connection Timeout」メッセージが表示されたり、Pull Request (PR) ページが動かなくなったりする瞬間です。心臓がキュッとなるような感覚とともに、「一体なぜこんなことが?」という疑問が頭をよぎります。
最近の2026年5月、世界中の数百万人の開発者が依存しているGitHubで発生した大規模なインシデントは、まさにこの恐怖を現実のものとしました。今回の障害は、単にサーバーが一時的に遅くなったというレベルではありませんでした。Pull Requests、Issues、Git演算、そしてAPIリクエストに至るまで、GitHubのコアエンジンが同時に揺らいだ「複合障害」だったからです。
今日は、この事件がなぜ発生したのか、そして私たちが開発環境を構築する際に何を準備すべきなのかを深く掘り下げていきます。
予期せぬ連鎖反応:なぜGitHubは止まったのか?
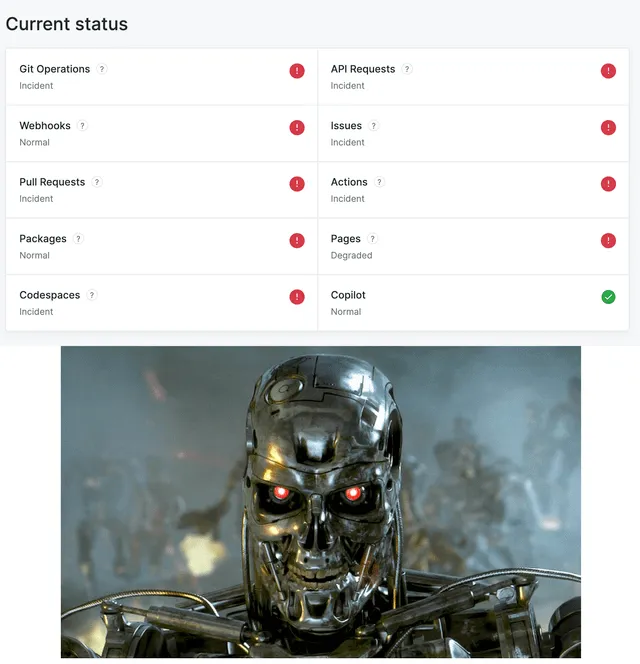
今回の障害の最も恐ろしい点は、「連鎖障害 (Cascade Failure)」の様相を呈したことです。単にサーバー一台が故障したのではなく、複数のプロセスが数珠つなぎに崩壊していく構造でした。
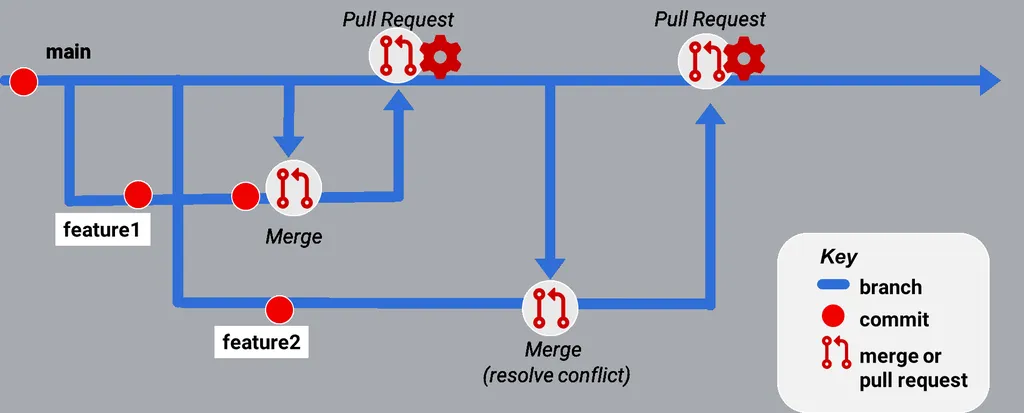
事件の発端は、大規模なPull Requestのマージプロセスから始まりました。膨大なコード変更を処理するためにGitリポジトリを複製し、マージする演算が急増し、これがサーバーのリソースを一瞬にして枯渇させました。しかし、問題はここで終わりではありません。
GitHubのシステムは有機的に連結されています。Git演算が遅延すると、これとリアルタイムで連携しているはずのAPIエンドポイントが応答不能になり始めました。APIの応答が遅れると、それを待っていた他のサービスがタイムアウト (Timeout) エラーを吐き出し、最終的にはIssueトラッカーやPR管理システムまでドミノ倒しのように崩れていきました。
特に開発者を最も苦しめたのは、データの不整合問題でした。GitプッシュイベントがAPIを通じてIssueシステムに伝達される過程で同期が崩れ、バグが解決されたにもかかわらずIssueが依然として「Open」状態のまま残っていたり、既に完了した作業が重複して報告されたりと、混乱が生じました。これは単なる技術的なエラーを超え、開発チーム全体のワークフローを麻痺させる致命的な結果を招きました。
事後分析 (Post-mortem) のジレンマ:真の原因を見つけられるか?
事態が収束した後、コミュニティ(Hacker Newsなど)では熱い論争が巻き起こりました。論争の核心は「GitHubが提供する事後分析は果たして十分なのか?」という点でした。
技術コミュニティの一部専門家は、冷ややかな反応を示しました。「これほどの速さで発生するすべての問題に対して完璧な事後分析を行うことは、物理的に不可能だ」という指摘です。もし企業が単に「デプロイ前の分析が不十分だった」といった表面的な結論を出すだけであれば、それは真の意味での根本原因 (Root Cause) 分析とは言えないからです。
一方で、組織的な問題を調査するためには、はるかに多くの時間と人員が必要であるという現実的な反論も少なくありませんでした。障害が発生するたびにすべての詳細を掘り下げていては、サービスの復旧自体が遅れてしまうという論理です。
ここで興味深い点は、技術負債を解決するための代替案として、AIツールの導入が挙げられていることです。人間のエンジニアがすべてのログを調べる代わりに、AIがパターンを分析して障害の前兆を見つけ出したり、複雑なログ間の相関関係を見つけ出したりする手法です。これは単なる技術的な問題を超え、大規模プラットフォームの信頼性を管理する手法そのものが変わりつつあることを示唆しています。
実践対応ガイド:APIレート制限とシステム安定性の確保
このような巨大なプラットフォームの障害をコントロールすることはできませんが、私たちが書くコードとシステム設計はコントロールできます。今回のGitHubインシデントに関連して、開発者が実務で必ず知っておくべきAPIおよびシステム管理戦略をまとめます。
1. APIレート制限 (Rate Limit) を賢く扱う方法
GitHubを含むほとんどのサービスは、サーバーリソースを保護するためにAPI呼び出し回数を制限しています。これを無視すると、サービスが遮断される可能性があります。
- 認証 (Authentication) は必須: 認証されていないユーザーは1時間あたり60回に制限されますが、個人アクセストークン (PAT) などを使用して認証すれば、1時間あたり5,000回まで制限が大幅に緩和されます。最も簡単かつ確実な「アップグレード」方法です。
- 条件付きGETリクエストの活用: データが変更されたかどうかを毎回確認する必要はありません。
ETagやLast-Modifiedヘッダーを使用して、データが変わっていない場合は304 Not Modifiedレスポンスを受け取るように設計してください。この場合、レート制限のカウントは消費されません。 - GraphQLの最適化: REST APIは呼び出し回数が基準ですが、GraphQLはクエリの複雑度(スコア)が基準です。必要なフィールドだけを正確にリクエストし、「スコア」の浪費を防がなければなりません。
2. 指数バックオフ (Exponential Backoff) の実装
APIがタイムアウトや5xxエラーを返したとき、即座にリトライ (Retry) を繰り返すのは、火に油を注ぐようなものです。
最近では、GitHub Copilot Chat のようなAIツールを活用してこれを簡単に解決できます。例えば、Pythonの requests ライブラリを使用する際に、リトライ間隔を指数関数的に増やす指数バックオフロジックを追加するのが良いでしょう。
- 例: 1秒待機 2秒待機 4秒待機 8秒待機... この方式は、サーバーへの圧力を段階的に減らしつつ、成功確率を高める非常にエレガントな解決策です。
3. 非同期処理とWebhookの習慣化
リアルタイムの更新が必要だからといって、常にAPIを呼び出し続ける(ポーリング)のは非常に危険です。代わりに、サーバーでイベントが発生したときにこちらに信号を送ってくれるWebhook方式を採用してください。これにより、API呼び出し回数を劇的に減らしつつ、システムの応答性を高めることができます。
おわりに:信頼できる開発エコシステムに向けて
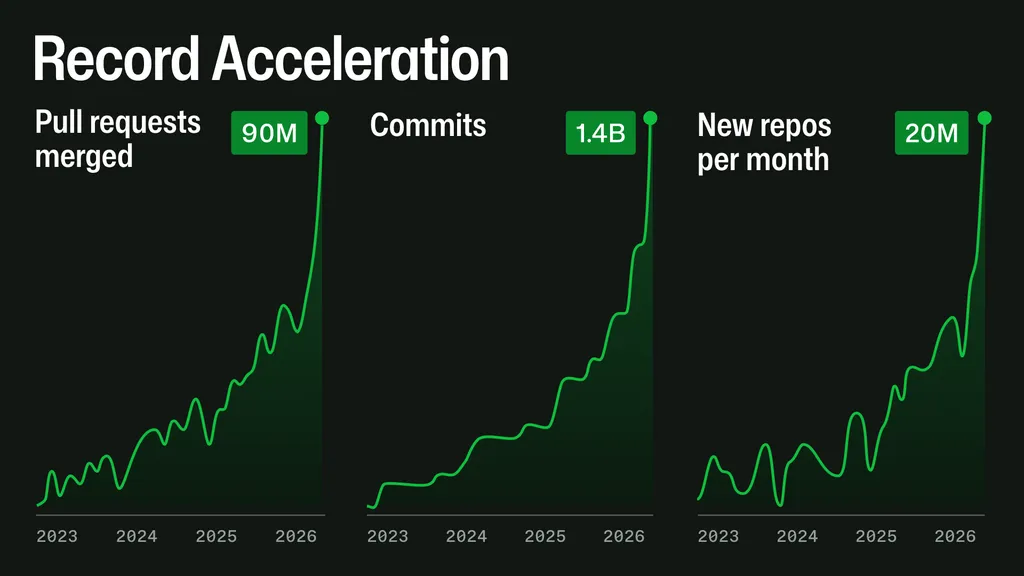
今回のGitHubインシデントは、私たちに重要な教訓を残しました。現代のソフトウェア開発環境は、コードリポジトリ、Issueトラッカー、そして数多くの外部APIが巨大な網の目のように絡み合っているという事実です。網の目の一箇所が切れると、全体が揺らぎ得ることを私たちは目の当たりにしました。
結局のところ、核心は「回復弾力性 (Resilience)」です。プラットフォームの障害を防ぐことはできなくても、障害が発生したときに私たちのシステムがいかに柔軟に対応し、いかに速く正常な軌道に戻れるかを設計することこそが、シニア開発者の能力です。
単にコードを書くことを超えて、システム全体の流れとつながりを理解する眼を養わなければなりません。APIの制限事項を熟知し、リトライロジックを設計し、自動化された監視メカニズムを構築する——そのすべてのプロセスが始まりです。
今日、皆さんのコードには障害に備えた「安全装置」がどれくらい準備されていますか?
皆さんのプロジェクトでは、API障害やレート制限の問題をどのように管理していますか?ぜひコメント欄で皆さんのノウハウを共有してください!
参考文献
- Incident with Pull Requests, Issues, Git Operations and API Requests · news.ycombinator.com
- An update on GitHub availability · github.blog
- Incident History - GitHub Status · githubstatus.com
- API 속도 제한 처리 - GitHub 문서 · docs.github.com
- [질문] "API 속도 제한 초과" 정확히 어떻게 제한을 업그레이드하나요? · reddit.com
- GitHUB API Rate limiting - velog · velog.io