Cualquier desarrollador habrá pasado por esto al menos una vez: estás a punto de realizar un despliegue importante, haces el push del código y, de repente, aparece un mensaje de 'Connection Timeout' o la página del Pull Request (PR) deja de responder. El corazón se te encoge y una pregunta cruza tu mente: "¿Pero qué está pasando?".
En mayo de 2026, un incidente a gran escala en GitHub, de la cual dependen millones de desarrolladores en todo el mundo, convirtió este temor en realidad. Esta vez, no fue simplemente un retraso temporal del servidor; fue una "falla compuesta" donde los motores principales de GitHub —desde Pull Requests e Issues hasta operaciones de Git y solicitudes de API— se vieron afectados simultáneamente.
Hoy analizaremos en profundidad por qué ocurrió este evento y qué debemos preparar al construir nuestros entornos de desarrollo.
Una reacción en cadena inesperada: ¿Por qué se detuvo GitHub?
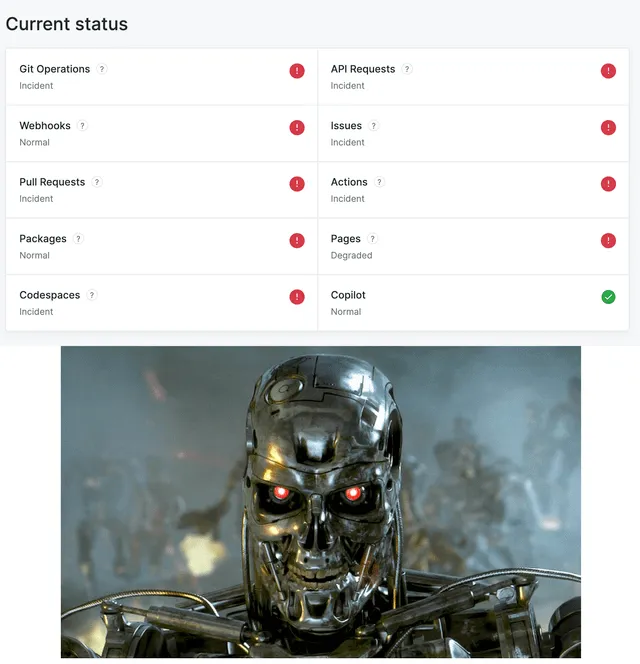
Lo más aterrador de esta interrupción fue su patrón de "falla en cascada (Cascade Failure)". No se trató simplemente de que un servidor fallara, sino de una estructura donde múltiples procesos colapsaron uno tras otro.
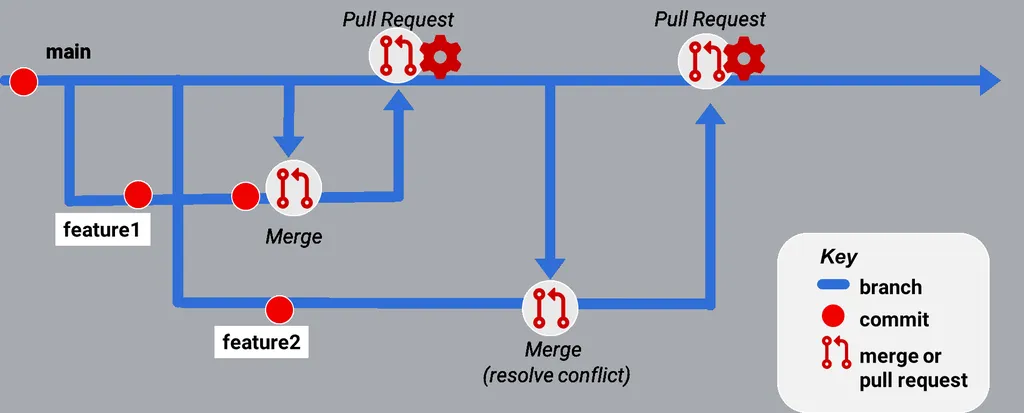
El incidente comenzó durante un proceso de fusión (merge) de Pull Requests a gran escala. Para procesar una enorme cantidad de cambios de código, las operaciones de clonación y fusión de repositorios Git aumentaron dramente, agotando los recursos del servidor en cuestión de instantes. Pero el problema no terminó ahí.
El sistema de GitHub está conectado de forma orgánica. Cuando las operaciones de Git se retrasaron, los endpoints de la API, que deben estar vinculados en tiempo real, comenzaron a dejar de responder. Al retrasarse las respuestas de la API, otros servicios que esperaban dicha respuesta arrojaron errores de tiempo de espera (Timeout), provocando que el rastreador de Issues y el sistema de gestión de PRs colapsaran como en un efecto dominó.
Especialmente problemático para los desarrolladores fue el problema de la inconsistencia de datos. Durante el proceso de transferencia de eventos de Git push al sistema de Issues a través de la API, la sincronización se rompió. Esto generó confusión, como errores que seguían apareciendo como 'Open' a pesar de haber sido resueltos, o tareas ya completadas que se reportaban duplicadas. Esto fue más allá de un simple error técnico, provocando consecuencias críticas que paralizaron el flujo de trabajo completo de los equipos de desarrollo.
El dilema del Post-mortem: ¿Es posible encontrar la causa real?
Una vez solucionado el incidente, se desató un intenso debate en comunidades como Hacker News. El núcleo de la discusión era: "¿Es suficiente el análisis post-mortem que proporciona GitHub?".
Algunos expertos de la comunidad técnica mostraron una reacción cínica. Señalaron que "es físicamente imposible realizar un análisis post-mortem perfecto para todos los problemas que ocurren a esta velocidad". Si una empresa solo ofrece conclusiones superficiales como "el análisis previo al despliegue fue insuficiente", no puede considerarse un análisis de causa raíz (Root Cause) en el sentido estricto.
Por otro lado, hubo contraargumentos realistas que sostenían que investigar problemas organizacionales requiere mucho más tiempo y personal. La lógica es que, si se intentara investigar cada detalle cada vez que ocurre una falla, la recuperación del servicio mismo podría retrasarse.
Un punto interesante es que se está mencionando la introducción de herramientas de IA como una alternativa para resolver la deuda técnica. En lugar de que un ingeniero humano busque en todos los logs, la IA podría analizar patrones para detectar síntomas prematuros de fallas o encontrar correlaciones entre logs complejos. Esto sugiere que la forma de gestionar la confiabilidad de las plataformas a gran escala está cambiando, más allá de los simples problemas técnicos.
Guía de respuesta práctica: Gestión de límites de velocidad de API y estabilidad del sistema
No podemos controlar las fallas de plataformas gigantescas, pero sí podemos controlar el código y el diseño de sistemas que escribimos. En relación con este incidente de GitHub, resumimos las estrategias de gestión de API y sistemas que todo desarrollador debe conocer en la práctica.
1. Cómo manejar inteligentemente el límite de velocidad (Rate Limit) de la API
La mayoría de los servicios, incluido GitHub, limitan el número de llamadas a la API para proteger los recursos del servidor. Ignorar esto puede resultar en el bloqueo del servicio.
- La autenticación es esencial: Los usuarios no autenticados están limitados a 60 solicitudes por hora, pero al autenticarse usando un Token de Acceso Personal (PAT), el límite aumenta drásticamente hasta 5,000 solicitudes por hora. Es la forma más fácil y segura de "subir de nivel".
- Utilizar solicitudes GET condicionales: No es necesario verificar si los datos han cambiado cada vez. Diseñe su sistema para usar los encabezados
ETagoLast-Modifiedpara recibir una respuesta304 Not Modifiedsi los datos no han cambiado. En este caso, no se consume el contador de límite de velocidad. - Optimización de GraphQL: Mientras que en REST API el criterio es el número de llamadas, en GraphQL el criterio es la complejidad (puntuación) de la consulta. Debe solicitar únicamente los campos necesarios para evitar el desperdicio de "puntos".
2. Implementar el retroceso exponencial (Exponential Backoff)
Cuando una API devuelve un Timeout o un error 5xx, intentar repetir la solicitud (Retry) de inmediato es como echar leña al fuego.
Recientemente, se puede resolver esto fácilmente utilizando herramientas de IA como GitHub Copilot Chat. Por ejemplo, al usar la librería requests de Python, es recomendable añadir una lógica de retroceso exponencial que aumente exponencialmente el intervalo entre reintentos.
- Ejemplo: Esperar 1s Esperar 2s Esperar 4s Esperar 8s... Este método es una solución elegante que reduce gradualmente la presión sobre el servidor mientras aumenta la probabilidad de éxito.
3. Convertir el procesamiento asíncrono y los Webhooks en un hábito
Es muy peligroso realizar llamadas constantes a la API (Polling) solo porque se necesitan actualizaciones en tiempo real. En su lugar, adopte el método de Webhooks, donde el servidor envía una señal hacia nosotros cuando ocurre un evento. Esto reduce drásticamente el número de llamadas a la API y aumenta la capacidad de respuesta del sistema.
Conclusión: Hacia un ecosistema de desarrollo confiable
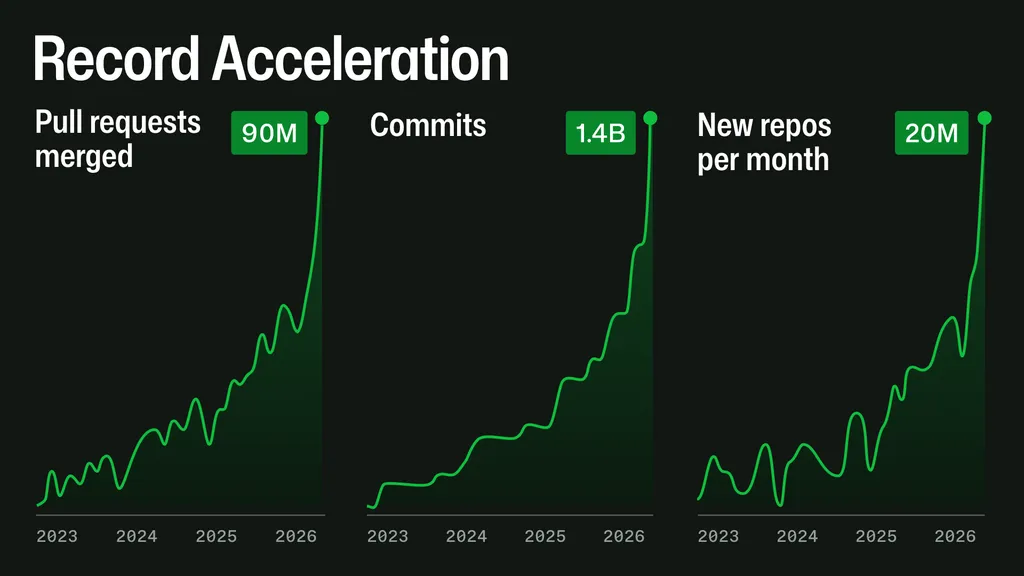
Este incidente de GitHub nos ha dejado una lección importante. El entorno de desarrollo de software moderno es una red masiva donde los repositorios de código, los rastreadores de problemas y las innumerables APIs externas están entrelazados. Hemos sido testigos de que si una parte de la red se rompe, todo puede tambalearse.
Al final, la clave es la "resiliencia (Resilience)". Aunque no podamos evitar las fallas de una plataforma, la capacidad de un desarrollador senior radica en diseñar sistemas que respondan con flexibilidad y regresen rápidamente a la normalidad cuando ocurre un fallo.
Más allá de simplemente escribir código, debemos desarrollar la capacidad de entender el flujo total del sistema y sus puntos de conexión. El proceso comienza con conocer las limitaciones de las API, diseñar lógicas de reintento y construir mecanismos de monitoreo automatizados.
En su código de hoy, ¿qué tan preparados están los "dispositivos de seguridad" para enfrentar una falla?
¿Cómo gestionan en sus proyectos los problemas de fallas de API o de límites de velocidad? ¡Compartan sus propios conocimientos en los comentarios!
Referencias
- Incident with Pull Requests, Issues, Git Operations and API Requests · news.ycombinator.com
- An update on GitHub availability · github.blog
- Incident History - GitHub Status · githubstatus.com
- API 속도 제한 처리 - GitHub 문서 · docs.github.com
- [질문] "API 속도 제한 초과" 정확히 어떻게 제한을 업그레이드하나요? · reddit.com
- GitHUB API Rate limiting - velog · velog.io