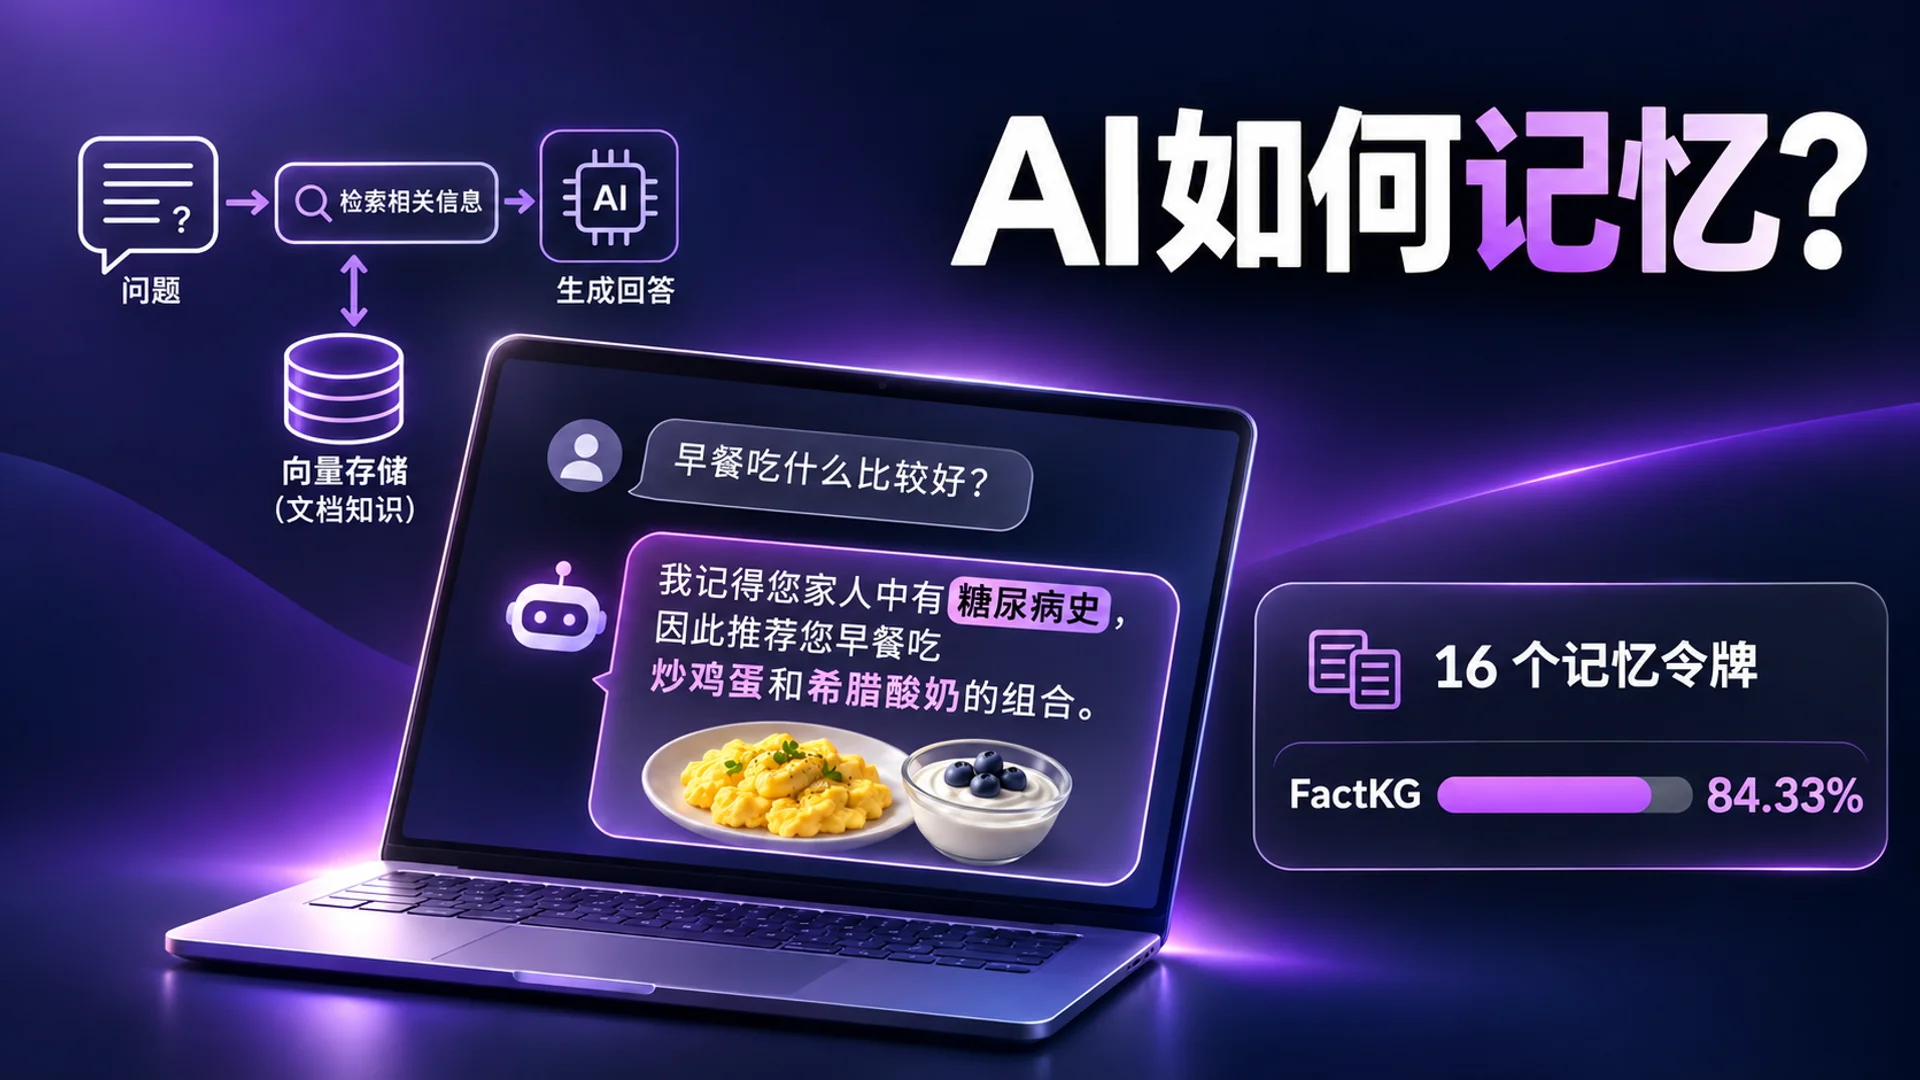
某位用户与AI助手共对话107次,累积了约32,000个token的长篇履历。在这段对话中,他只问过一次:“母亲那边的糖尿病是否比父亲那边更能增加患病风险?”他从未明确说过自己是糖尿病患者。然而,当后来他问“早餐吃什么?”时,不具备记忆功能的普通语言模型给出的却是与糖尿病语境毫无关系的普通早餐清单。相比之下,由斯坦福大学、麻省理工学院、宾夕法尼亚大学和多伦多大学研究团队联合发布的Memorilla,则能将血糖控制的早餐建议与过往对话中提到的糖尿病内容关联起来,从而给出相应回答。
Memorilla是一种面向大语言模型(LLM)的记忆系统。它不再让模型通读庞大的文档或完整的对话历史,而是将问题与所需信息关联起来,并压缩为16个“记忆token(向量)”。这16个向量并非特定句子的简化摘要,而是学习模块通过交叉注意力机制,根据问题从多篇文档中提取的分散信息的语义关系结果。
RAG与Memorilla的决定性差异
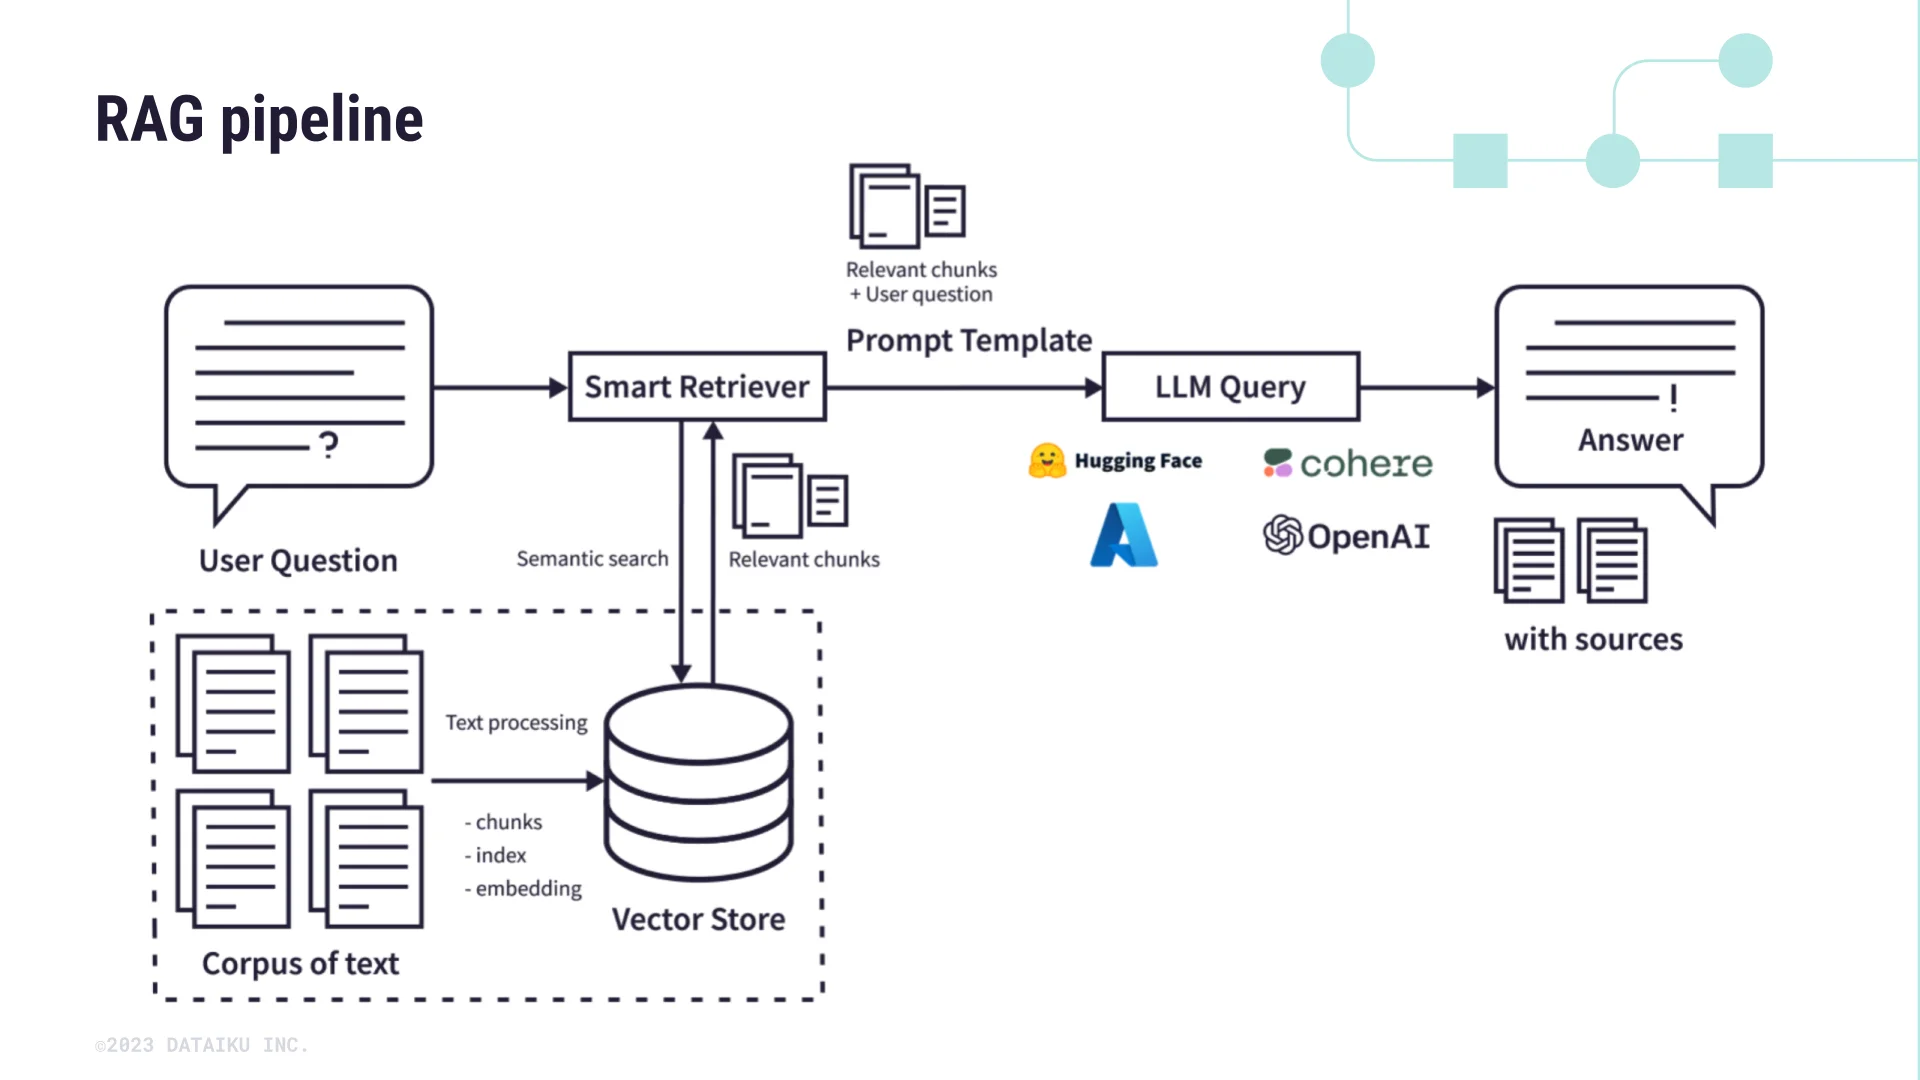
过去,AI助手从履历中寻找线索的最典型方法是RAG(检索增强生成)。RAG会挑选与当前问题词汇相似度最高的若干文档,并将其原文直接传递给LLM。然而,“早餐”这个问题与“母亲那边的糖尿病”这段过往对话在表面词汇上毫无重叠。据研究团队公开的示例显示,当询问“补充能量的食物”时,RAG仅能凭借词汇相似度召回包含“糙米”、“藜麦”、“燕麦”的句子。而过往对话中蕴含的“缺铁”或“半程马拉松训练”等关键语境,因缺乏词汇重叠而被遗漏。
Memorilla改变了这一结构。研究团队开发的参数量约1.94亿的独立学习模块,能够同时读取当前问题的嵌入值(将文本转换为数值列表)和已存储的完整对话历史的嵌入值。它通过交叉注意力机制(用于相互关联部分的技术)分析分散在多篇文档中的信息,将核心信息压缩为16个向量,并直接注入语言模型的输入空间 1。这种方式不是基于词汇相似度的检索,而是根据问题的意图来理解整个存储库的含义。
非摘要式的“问题依赖”读取原理
Memorilla与传统AI摘要技术的区别在于“压缩的时机”。在读取文档的同时立即进行摘要的传统方式,不会考虑未来可能出现的问题。由于必须用一份摘要来应对所有问题,其与具体问题的相关性可能会下降。
相反,Memorilla在问题到来之前不会进行压缩。它首先使用'Qwen3-Embedding-4B'编码器将文档历史一次性转换为数值列表并存储。只有当实际问题出现时,16个经过训练的记忆槽位才会遍历整个存储库,提取“要回答此问题,需要关联哪些信息”的语境 1。如果问题发生变化,被压缩的信息内容也会随之改变。
在此过程中,负责生成答案的LLM(Qwen3-8B)和编码器保持未训练状态,即被冻结。这并非训练语言模型本身,而是仅训练一个大小为194M的中间模块,该模块的作用是将文档嵌入值映射到LLM的输入空间 23。这相当于在LLM的输入嵌入前,直接放置“浓缩了语义的向量”以替代词汇(token)。由于这种结构性特性,Memorilla无法通过仅交换文本的普通API方式使用,必须能够控制LLM的内部机制方可应用 3。
16个向量带来的量化成果与速度
将记忆token的数量固定为16个,在计算量和处理速度上具有显著的效率优势。根据研究团队的数据,即使文档存储库从1个扩展到512个(约128K tokens),Memorilla的响应生成时间仍保持在0.74秒的“常数延迟”。与将整个文档输入LLM的方式相比,后者随着文档数量的增加,延迟会长达19.9秒,Memorilla的速度快了约27倍 12。
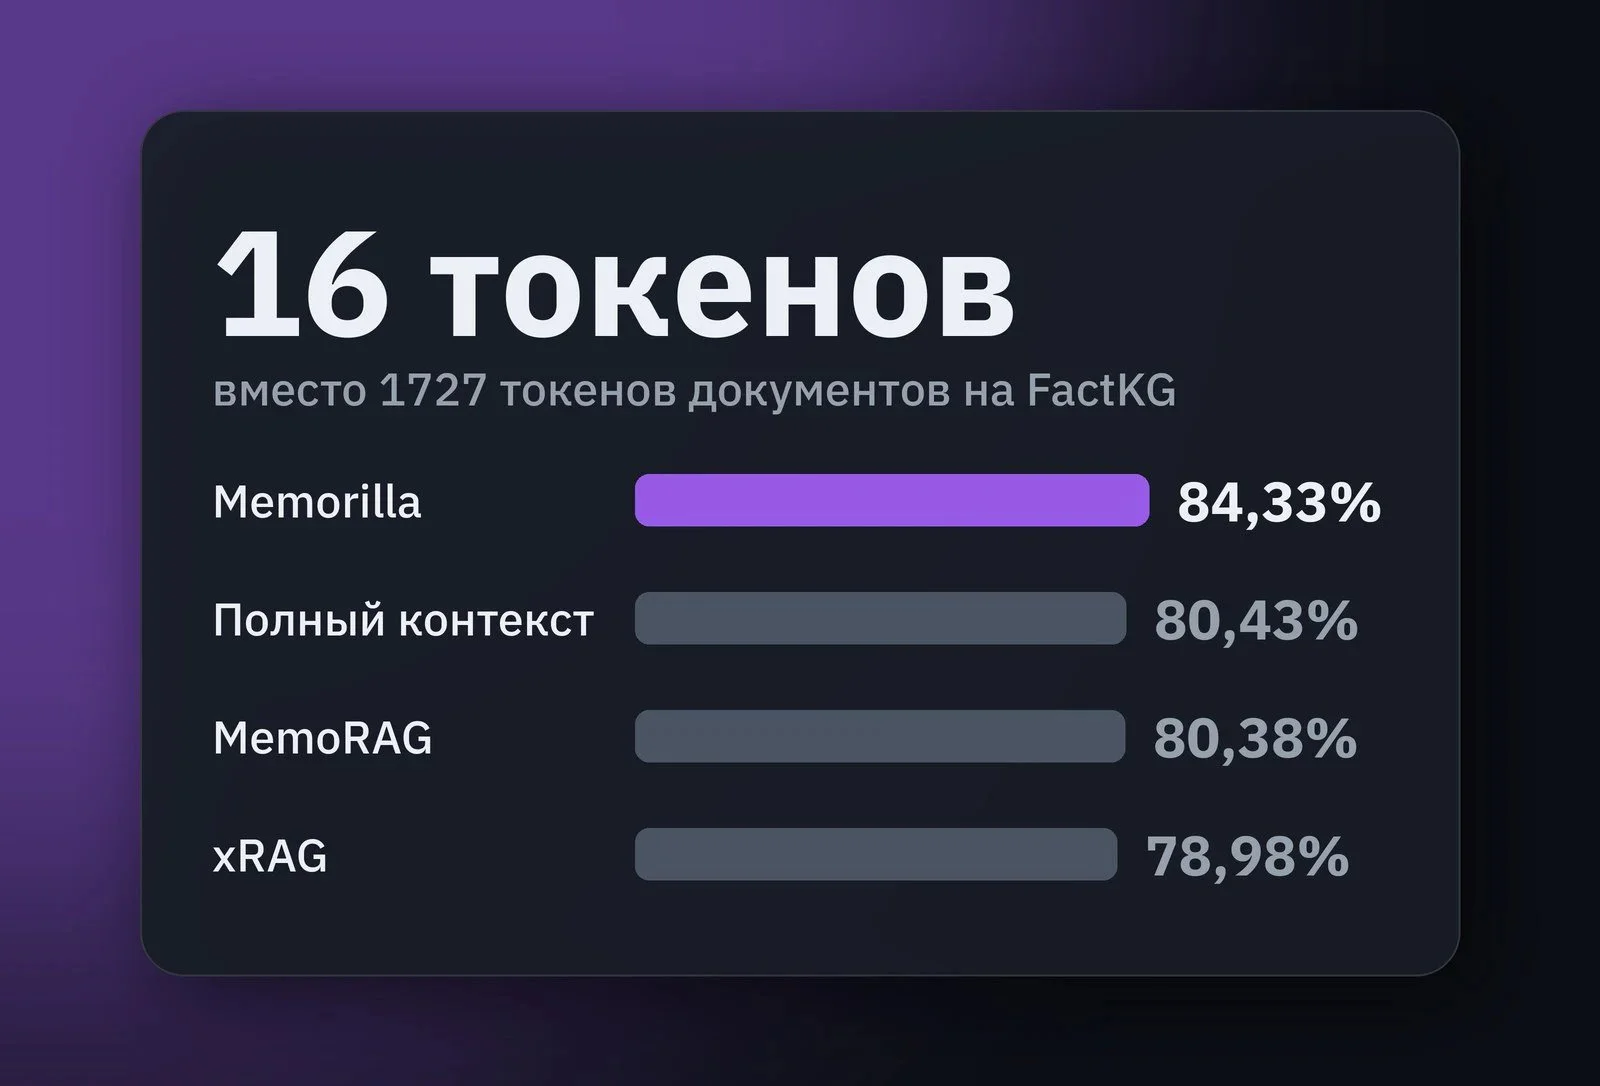
这不仅仅是速度的提升。在需要将多个事实或线索综合起来回答的复杂问题中,其性能甚至优于通读全文的方式。在验证多个事实知识图谱的FactKG基准测试中,Memorilla取得了84.33%的准确率。这不仅高于通读全部上下文的基线方法(80.43%),而且输入文档的token数量仅为后者的1/108 41。既然在通读所有事实的情况下,全上下文方法仍处于落后,可以看出Memorilla的优越性并非仅仅源于信息量的大小。
特别是在为确定一个正确答案需要关联4个以上复杂事实时,差异尤为明显。在检索50篇文档的场景下,RAG方法的性能从78.7%急剧下降至51.8%。相反,Memorilla由于能一次性压缩分散在多篇文档中的事实关系,因此维持在80%以上的准确率 13。在个人化对话数据基准PersonaMem-v2中,Memorilla也达到了44.6%的准确率,大幅超越了最强的RAG方法xRAG(30.9%)和全上下文方法(27.9%) 1。
“早餐菜单”与“糖尿病”能够关联的原因
通过前述的失败案例,可以清楚地确认Memorilla的工作方式。在用户的历史记录中,“母亲那边的糖尿病风险”这一线索与“早餐吃什么”这个问题之间完全没有词汇重叠。
无记忆的普通LLM面对“早餐吃什么?”这一问题,只会给出与糖尿病语境无关的一般早餐列表。而Memorilla通过交叉注意力机制,找到了“问题:早餐”与“存储库:过去提到的糖尿病家族病史”之间微弱的语义联系,将其转换为16个向量,并放置在LLM的输入嵌入之前。由此,LLM给出的不再是简单的早餐菜单列表,而是基于过往对话中仅出现一次的糖尿病家族病史,综合考虑了血糖控制和饱腹感的个性化回答,例如炒蛋或希腊酸奶 2。
RAG依然擅长的“精确名称”与细微信息
Memorilla的语义压缩技术在处理复杂关联推理方面表现强劲,但并非在所有领域都完美无缺。由于注入的仅仅是压缩后的向量而非原文,文档中出现的准确字符串或细微的细节事实存在丢失的可能。研究团队推测压缩技术会保留文档的结构或意义,同时也自行指出了可能丢失精确名称或具体细节事实的局限性 13。
这些局限性通过数据得到了证实。在需要从简短的医学论文摘要中找出明确细节条目的PubMedQA基准测试中,Memorilla录得59%的成绩,低于压缩或检索原文注入的LLMLingua-2(69%) 13。在长篇小说问答基准NarrativeQA中,根据问题类型结果出现分化。在询问“为什么”、“如何”的问题上,Memorilla的ROUGE-L分数比RAG高出5~7个百分点;但在询问精确名称或对象的“谁(who)”、“哪个(which)”问题上,直接提取原文的RAG方法则高出约3个百分点 13。
Memorilla的性能指标是基于研究团队准备的特定组合(Qwen3-8B单一模型)及自设训练划分进行的基准测试环境下测得的 3。由于目前尚缺乏独立的复现验证,因此难以直接将其确定为可在其他模型或普通文本API环境中同等适用的通用标准。
Memorilla之所以能调取旧的糖尿病提及内容,是因为它以问题为导向,遍历整个文档,将所需的因果关系重新组装成16个向量。这标志着AI记忆从单纯的文本积累或摘要,向“问题依赖的语义单元压缩”迈进了一步。但是,在询问特定人物的精确名称或简短的细节条目时,直接检索原文的方式依然强大,结合这两种方法似乎将是未来的发展方向 3。
参考资料
- MEMORILLA: Latent Semantic Memory for LLMs · memory.stanford.edu↩
- ↩
- Memorilla: 16 векторов памяти вместо RAG для LLM · tproger.ru↩
- Memorilla: Latent Semantic Memory for LLMs · arxiv.org↩



