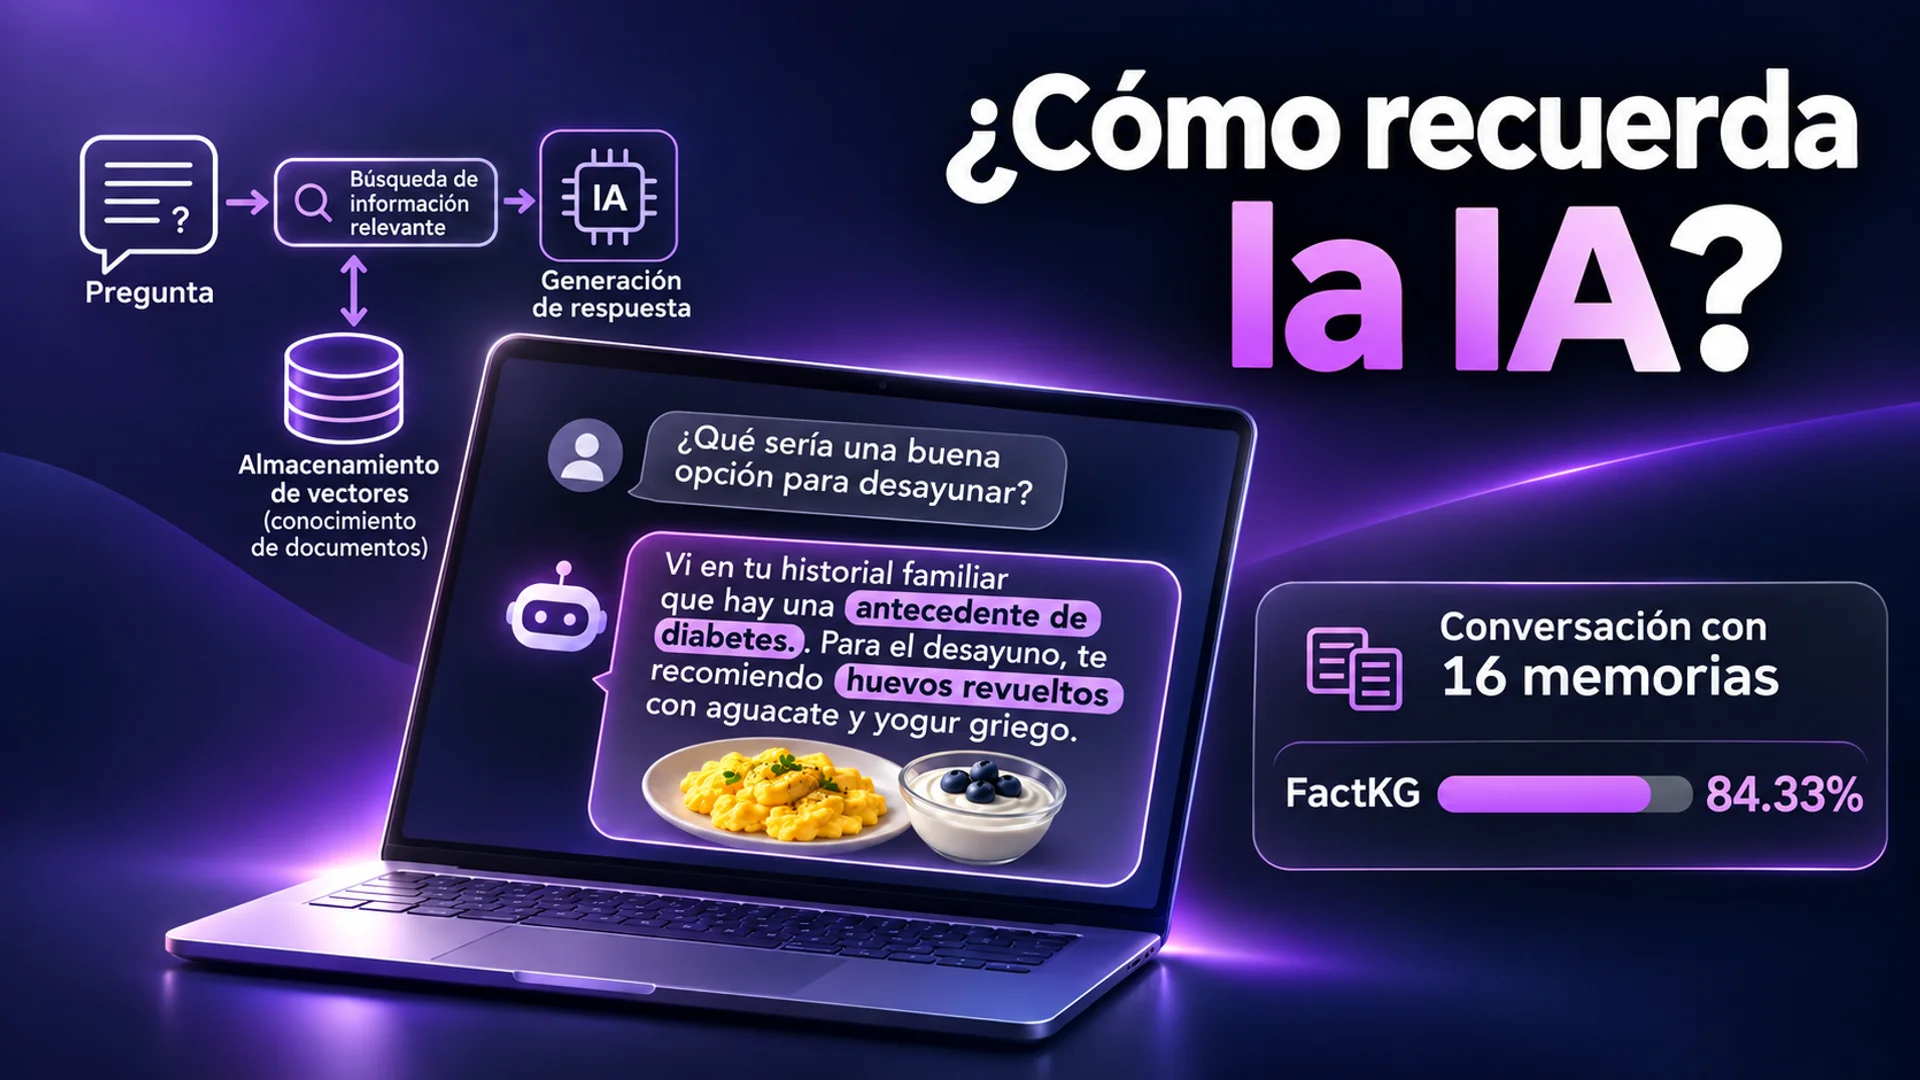
Un usuario mantuvo un total de 107 conversaciones con su asistente de IA, acumulando un historial extenso de aproximadamente 32.000 tokens. De todas esas conversaciones, en una sola oportunidad preguntó: «¿La diabetes del lado de la madre aumenta más el riesgo que la del lado del padre?». Nunca dijo por sí mismo que era diabético. Sin embargo, mucho tiempo después, cuando preguntó «¿Qué como en el desayuno?», un modelo de lenguaje convencional sin función de memoria generó una lista ordinaria de desayunos, totalmente ajena al contexto de la diabetes. En cambio, Memorilla, presentado por un equipo de investigación de las universidades Stanford, MIT, de Pensilvania y de Toronto, generó una respuesta que vincula el desayuno para controlar la glucemia con la mención de diabetes presente en la conversación previa.
Memorilla es un sistema de memoria para modelos de lenguaje de gran escala (LLM) que, en lugar de hacer que el modelo lea en su totalidad documentos extensos o historiales de conversación, conecta las preguntas con la información necesaria y la comprime en 16 «tokens de memoria (vectores)». Estos 16 vectores no son resúmenes reducidos de oraciones específicas, sino el resultado de un módulo de aprendizaje que extrae, mediante atención cruzada, las relaciones semánticas entre la información dispersa en varios documentos en función de la pregunta.
La diferencia decisiva entre RAG y Memorilla
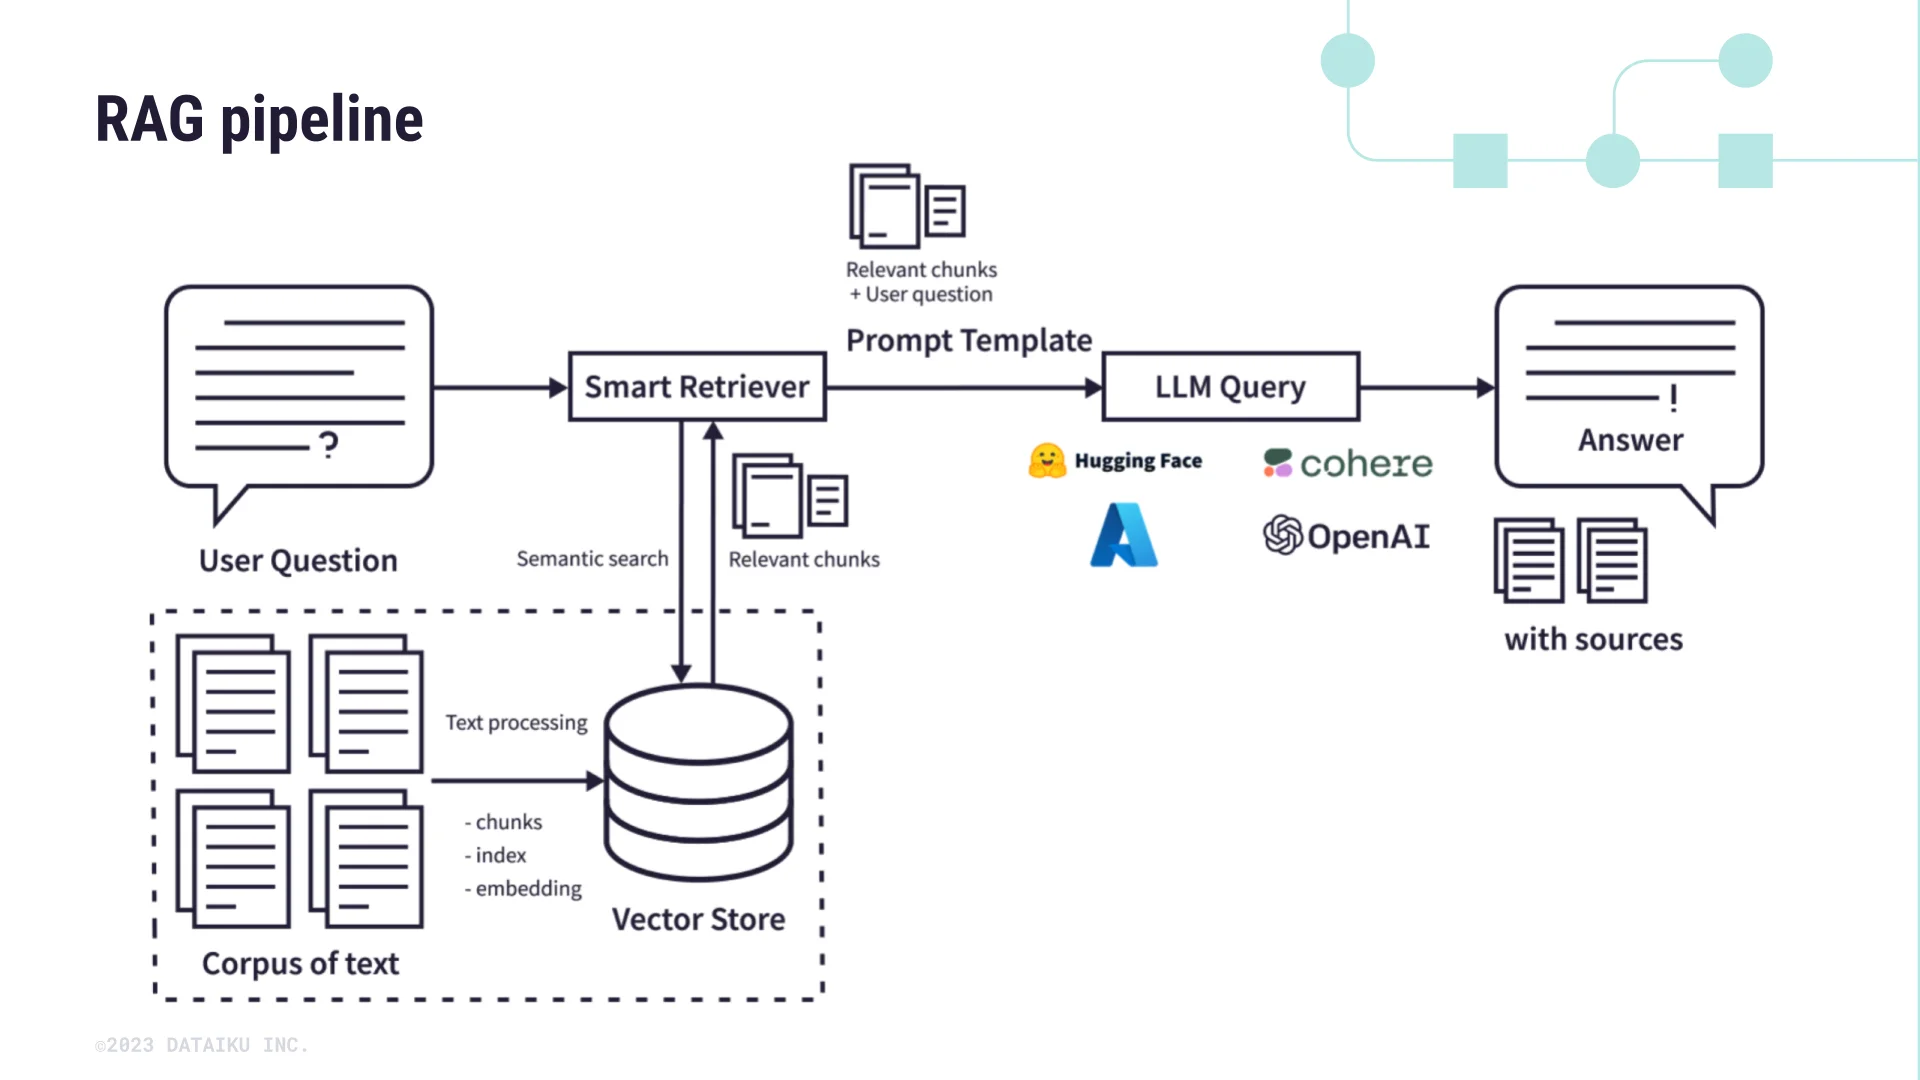
El método más representativo mediante el cual los asistentes de IA del pasado buscaban pistas en el historial es RAG (generación aumentada por recuperación). RAG selecciona varios documentos con la mayor similitud léxica respecto a la pregunta actual y los transmite al LLM en su forma original. No obstante, entre la pregunta «desayuno» y la conversación previa «diabetes del lado de la madre», las palabras superficiales no coinciden en absoluto. Según un ejemplo publicado por el equipo de investigación, ante una pregunta sobre «alimentos para reponer energía», RAG solo recupera oraciones que contienen las palabras «arroz integral», «quinoa» y «avena» por similitud léxica. Contextos esenciales presentes en la conversación previa, como «deficiencia de hierro» o «entrenamiento para media maratón», se pierden por la falta de coincidencia léxica.
Memorilla cambia esta estructura. Un módulo de aprendizaje independiente, desarrollado por los investigadores y con aproximadamente 194 millones de parámetros, lee simultáneamente la incrustación de la pregunta actual (el valor numérico resultante de convertir texto en una lista de números) y las incrustaciones del historial de conversación completo almacenado. Tras analizar la información dispersa en varios documentos mediante atención cruzada (una técnica que conecta las partes relacionadas entre sí), comprime la información clave en 16 vectores y los inserta directamente en el espacio de entrada del modelo de lenguaje 1. Es un método que no realiza una búsqueda por similitud léxica, sino que lee el significado de todo el almacén en función de la intención de la pregunta.
El principio de la lectura «dependiente de la pregunta», no del resumen
El punto donde Memorilla se diferencia de las técnicas tradicionales de resumen con IA reside en el «momento de la compresión». El enfoque tradicional, que resume el documento inmediatamente al leerlo, no tiene en cuenta qué preguntas surgirán posteriormente. Como debe aplicar un único resumen a todas las preguntas posibles, puede perder relevancia frente a cada una de ellas.
En cambio, Memorilla no comprime nada hasta que llega la pregunta. Primero convierte el historial de documentos una sola vez en listas numéricas mediante el codificador «Qwen3-Embedding-4B» y lo almacena. Solo cuando llega la pregunta real, los 16 memoria slots entrenados recorren todo el almacén y extraen el contexto necesario para responder: «Para responder a esta pregunta, hay que conectar esta información con aquella otra» 1. Si cambia la pregunta, también cambian los contenidos que se comprimen.
Durante este proceso, el LLM que redacta las respuestas (Qwen3-8B) y el codificador permanecen sin entrenar, en estado congelado. Lo que se entrena no es el modelo de lenguaje en sí, sino únicamente un módulo intermedio de 194M cuya función es trasladar las incrustaciones de documentos al espacio de entrada del LLM 23. Equivale a situar directamente delante de las incrustaciones de entrada del LLM «vectores con significado concentrado» en lugar de tokens (palabras). Por sus características estructurales, Memorilla no puede emplearse mediante un API convencional de intercambio exclusivo de texto; es necesario poder controlar el interior del LLM para aplicarlo 3.
Rendimiento cuantitativo y velocidad aportados por los 16 vectores
Fijar el número de tokens de memoria en 16 aporta una gran eficiencia en cómputo y velocidad de procesamiento. Según los datos del equipo de investigación, aunque el almacén de documentos crezca de 1 a 512 (aproximadamente 128K tokens), el tiempo de generación de respuestas de Memorilla mantiene una «latencia constante» sin cambiar de 0,74 segundos. Esto es aproximadamente 27 veces más rápido en comparación con el método de introducir documentos completos en el LLM, que experimenta latencias de hasta 19,9 segundos a medida que se acumulan los documentos 12.
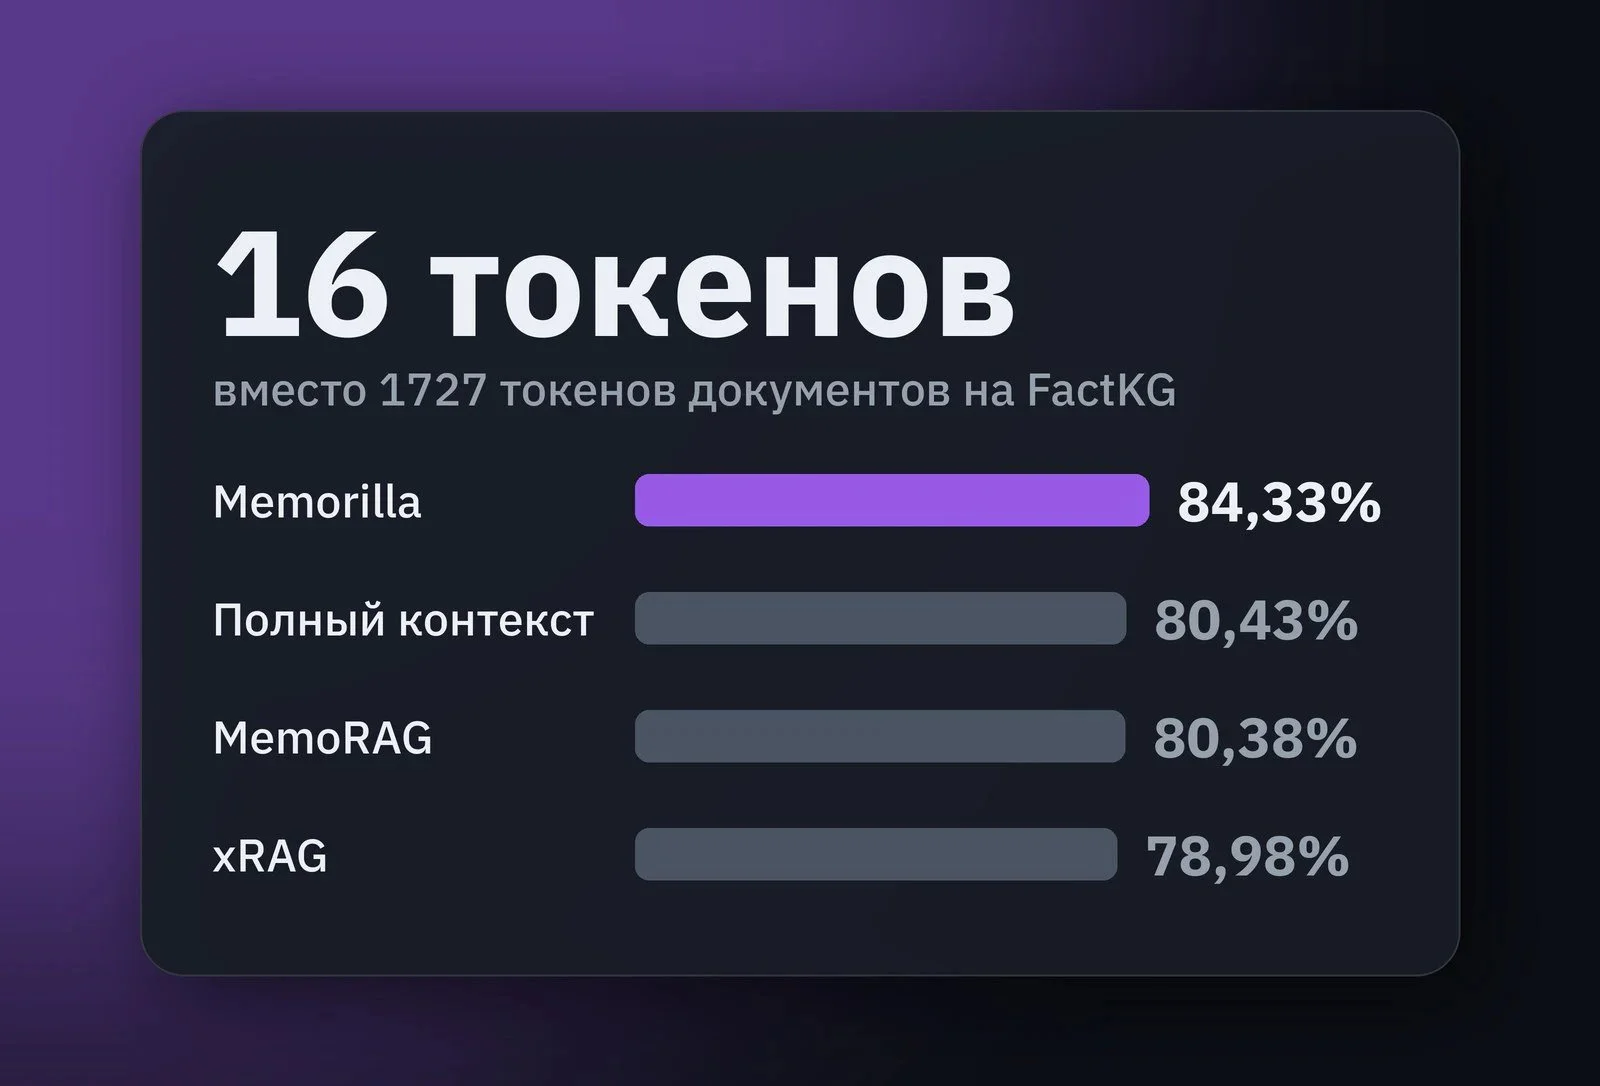
No se trata solo de velocidad. En preguntas complejas que exigen entrelazar varios hechos o pistas para responder, en ocasiones supera el rendimiento obtenido al leer la totalidad de los documentos. En el benchmark FactKG, que verifica múltiples grafos de conocimiento fáctico, Memorilla registró una exactitud del 84,33 %. La exactitud fue superior a la del método de lectura de todo el contexto (80,43 %), mientras que los tokens de documentos de entrada fueron apenas 1/108 41. Dado que el contexto total quedó por detrás pese a leer todos los hechos, la ventaja de Memorilla no proviene de un simple volumen de información.
La diferencia es especialmente notable cuando hay que entrelazar 4 o más hechos complejos para una única respuesta correcta. El método RAG, que recupera 50 documentos, sufrió una caída abrupta del rendimiento desde el 78,7 % al 51,8 %. En cambio, Memorilla mantuvo una exactitud en el rango del 80 %, porque comprime simultáneamente las relaciones entre hechos dispersos en varios documentos 13. También en el benchmark PersonaMem-v2, centrado en datos de conversación personalizados, Memorilla alcanzó una exactitud del 44,6 %, superando ampliamente tanto al método RAG más sólido, xRAG (30,9 %), como al enfoque de contexto completo (27,9 %) 1.
Por qué se conectan la pregunta «menú de desayuno» y «diabetes»
El funcionamiento de Memorilla se confirma con claridad a través del caso de fallo mencionado anteriormente. Entre el historial del usuario, la pista «riesgo de diabetes del lado de la madre» y la pregunta «¿Qué como en el desayuno?» no presentan ninguna coincidencia léxica.
Un LLM general sin memoria responde a la pregunta «¿Qué como en el desayuno?» con una lista general de desayunos ajena al contexto de la diabetes. Memorilla, en cambio, localiza mediante atención cruzada una débil conexión semántica entre «pregunta: desayuno» y «almacén: mención previa de antecedentes familiares de diabetes», la convierte en 16 vectores y los coloca delante de las incrustaciones de entrada del LLM. Como resultado, el LLM no genera una simple lista de menús de desayuno, sino una respuesta personalizada basada en unos antecedentes familiares de diabetes que aparecieron solo una vez en la conversación, considerando simultáneamente el control de la glucemia y la saciedad, como huevo revuelto o yogur griego 2.
Dónde RAG sigue siendo fuerte: «nombres exactos» y datos detallados
La técnica de compresión semántica de Memorilla es potente en razonamiento de conexiones complejas, pero no es perfecta en todos los ámbitos. Como solo se inyectan vectores comprimidos en lugar del texto original, existe la posibilidad de pérdida de cadenas de caracteres exactas escritas en el documento o de hechos específicos menores. El equipo de investigación estima que la compresión preservará la estructura y el significado del documento, pero también declara por sí misma la limitación de poder perder nombres exactos o hechos concretos 13.
Esta limitación se confirma con cifras. En el benchmark PubMedQA, que requiere localizar elementos específicos claros en resúmenes breves de artículos médicos, Memorilla registró un 59 %, mostrando un rendimiento inferior al de LLMLingua-2 (69 %), que comprime o recupera el texto original 13. También en NarrativeQA, donde se pregunta tras leer novelas extensas, los resultados variaron según el tipo de pregunta. En preguntas de «por qué» y «cómo», Memorilla obtuvo una puntuación ROUGE-L entre 5 y 7 puntos porcentuales superior a la de RAG; sin embargo, en preguntas de «quién» (who) y «cuál» (which), que piden nombres exactos o entidades, RAG, que recupera el texto original, logró puntuaciones aproximadamente 3 puntos porcentuales más altas 13.
El rendimiento de Memorilla se midió en un entorno de benchmark basado en una combinación específica preparada por el equipo de investigación (el modelo único Qwen3-8B) y su propia división de entrenamiento 3. Dado que aún no existe una verificación de reproducibilidad independiente, no es posible afirmar con seguridad que estos resultados puedan aplicarse como criterio universal en otros modelos o en entornos API de texto convencionales.
La razón por la que Memorilla pudo recuperar una mención antigua sobre diabetes fue que, tomando la pregunta como referencia, recorrió el conjunto de documentos y reconstruyó las relaciones causales necesarias en 16 vectores. Se trata de un intento de ampliar la memoria de la IA, más allá de la mera acumulación o resumen de texto, hacia una «compresión en unidades semánticas dependientes de la pregunta». No obstante, cuando se necesite preguntar por el nombre exacto de una persona específica o por datos concretos breves, el método de recuperación que localiza el texto original sigue siendo potente, y todo apunta a que la dirección futura será la combinación de ambos enfoques 3.
Referencias
- MEMORILLA: Latent Semantic Memory for LLMs · memory.stanford.edu↩
- ↩
- Memorilla: 16 векторов памяти вместо RAG для LLM · tproger.ru↩
- Memorilla: Latent Semantic Memory for LLMs · arxiv.org↩



