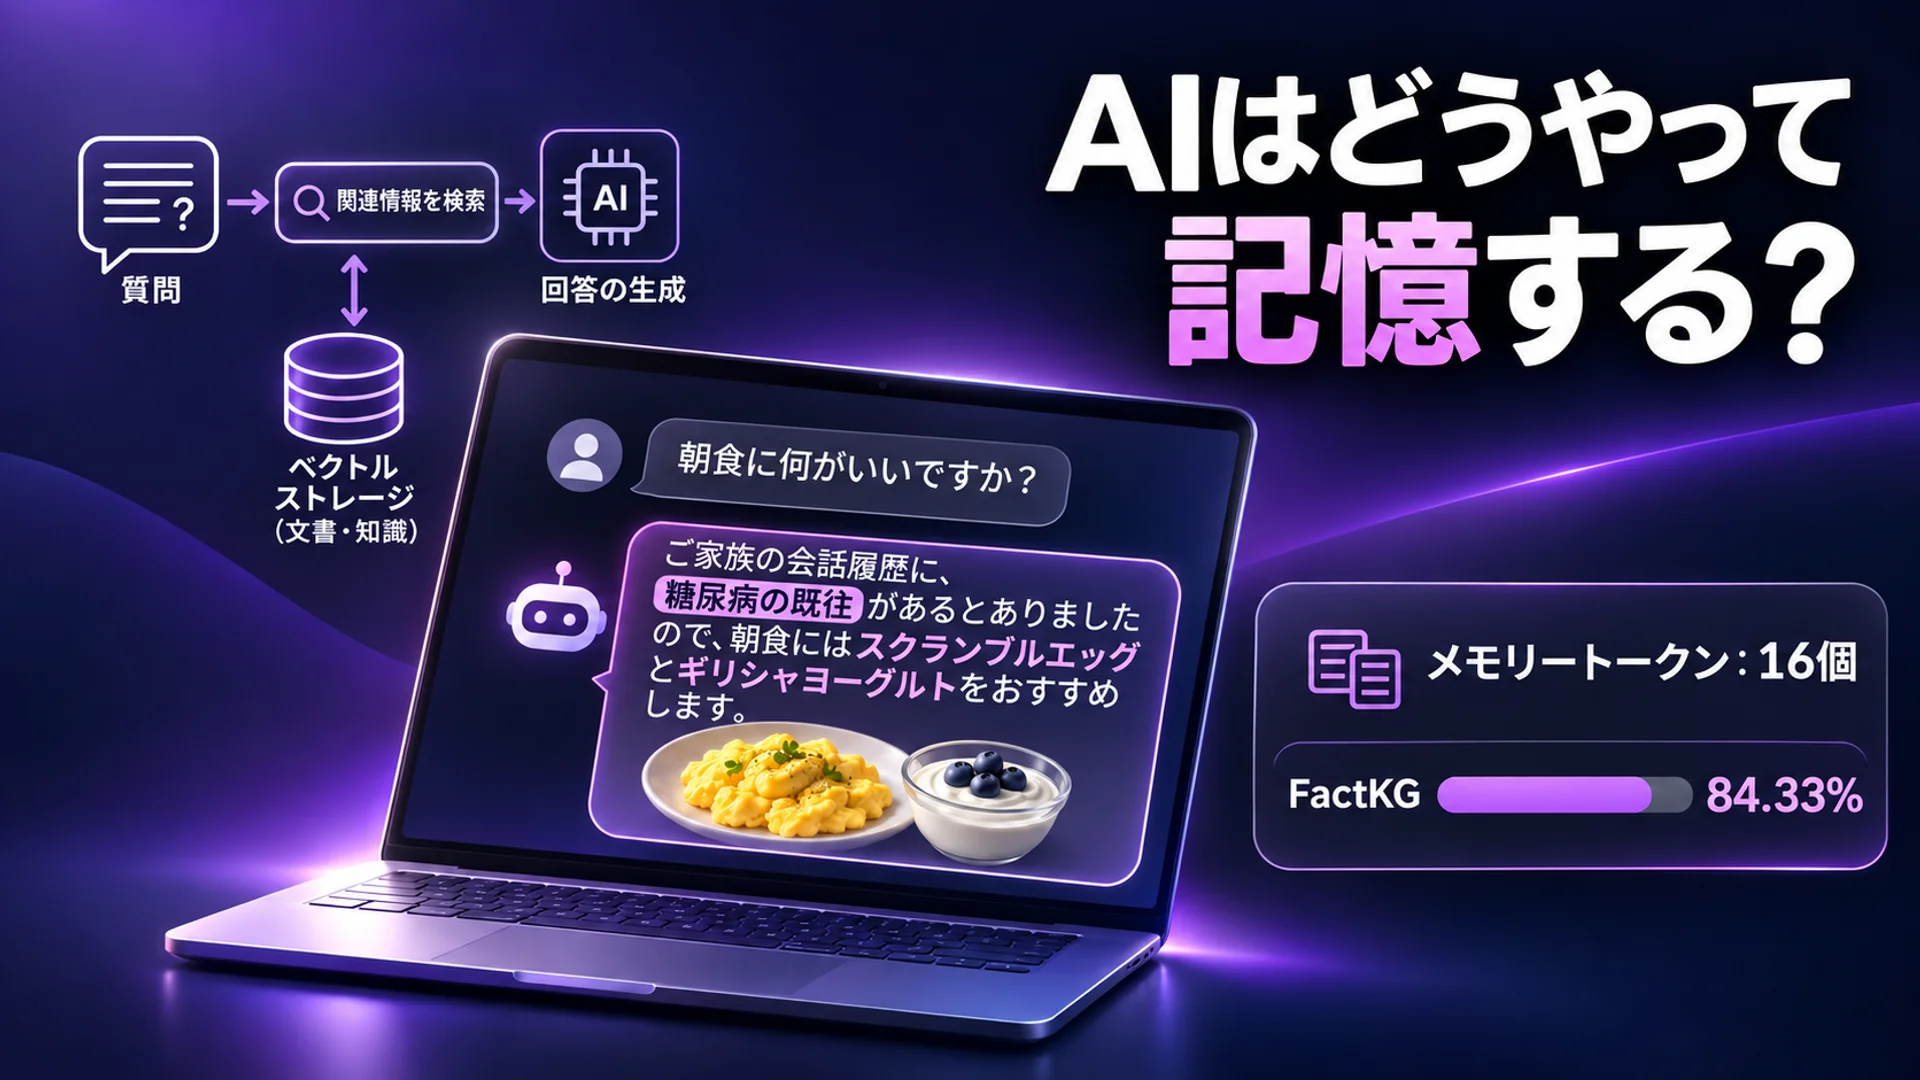
あるユーザーは、AIアシスタントと合計107回の対話を重ね、約3万2,000トークンに及ぶ長い履歴を蓄積しました。この対話の中で、彼はたった一度だけ「母方の糖尿病の方が父方よりもリスクを高めますか?」と尋ねただけです。自分自身が糖尿病患者だと明言したことはありません。しかし、その後のある時点で「朝食は何にしよう?」と質問した際、メモリ機能を持たない通常の言語モデルは、糖尿病の文脈とは無関係な一般的な朝食リストを提示しました。一方、スタンフォード大学、MIT、ペンシルベニア大学、トロント大学の研究チームが公開した「Memorilla」は、血糖値をコントロールする朝食と、過去の対話中に登場した糖尿病の言及を関連付けた回答を生成します。
Memorillaは、膨大なドキュメントや対話履歴をそのまま読み込ませる代わりに、質問と必要な情報を結びつけ、16個の「メモリトークン(ベクトル)」へ圧縮する言語モデル(LLM)向け記憶システムです。これら16個のベクトルは、特定の文を短くまとめた要約ではなく、質問を基準として複数のドキュメントに分散している情報の意味的関連性を、学習モジュールがクロスアテンションを用いて抽出した結果です。
RAGとMemorillaの決定的な違い
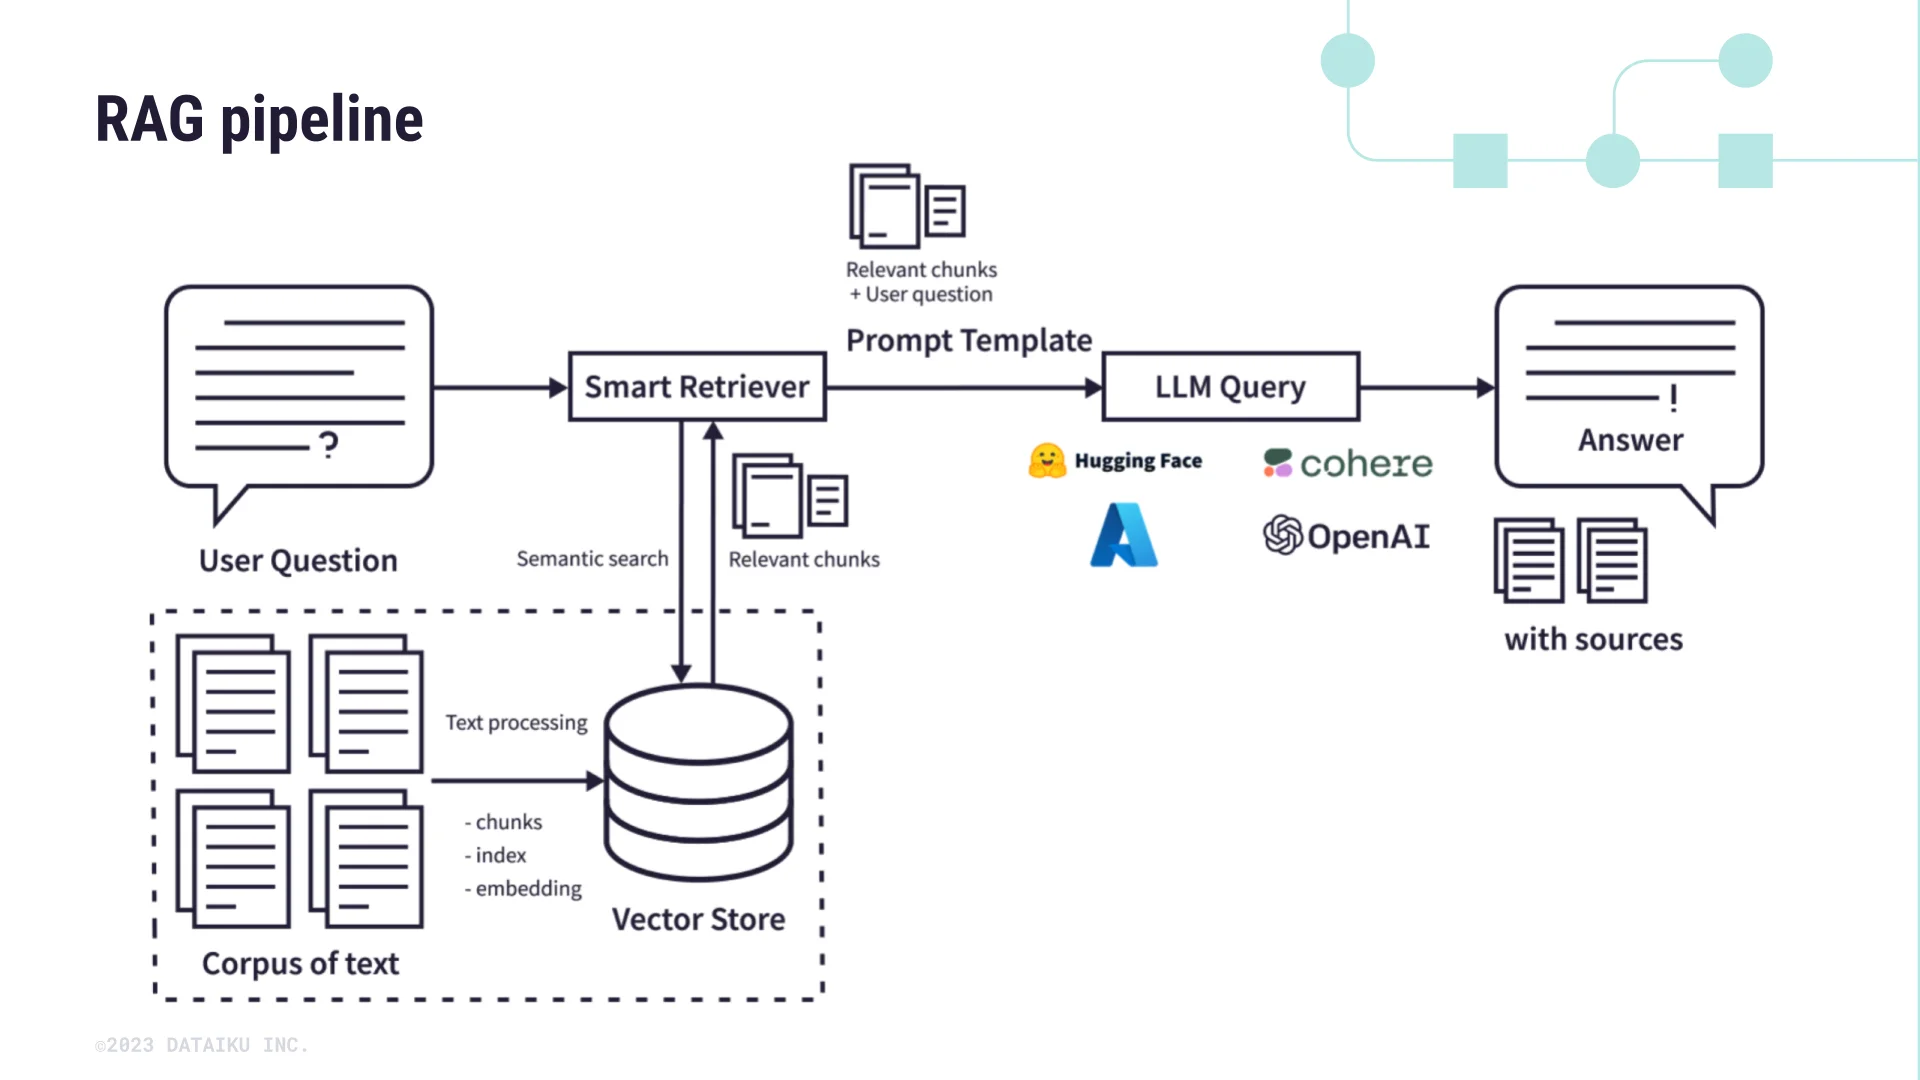
過去のAIアシスタントが履歴から手がかりを探す最も代表的な手法は、RAG(検索拡張生成)です。RAGは、現在の質問と単語の類似性が最も高いドキュメントをいくつか選び、原文のままLLMに渡します。しかし、「朝食」という質問と、「母方の糖尿病」という過去の対話では、表面に現れる単語が全く重複していません。研究チームが公開した例によると、「エネルギー補給食品」を問う質問に対し、RAGは単語の類似性により「玄米」「キヌア」「オートミール」が含まれる文を抽出するに留まります。過去の対話に含まれていた「鉄分不足」や「ハーフマラソンのトレーニング」といった重要な文脈は、単語の重複がないため見逃されます。
Memorillaはこの構造を変えます。研究チームが開発した約1億9,400万のパラメータを持つ独立した学習モジュールは、現在の質問の埋め込み(テキストを数値リストへ変換した値)と、保存されている全対話履歴の埋め込みを同時に読み込みます。複数のドキュメントに分散した情報をクロスアテンション(関連する部分を結び付ける技術)によって分析した後、重要な情報群を16個のベクトルに圧縮し、言語モデルの入力スペースへ直接投入します 1。単語類似性による検索ではなく、質問の意図に合わせて全保存領域の意味を読み取る方式です。
要約ではなく「質問依存型」読み取りの原理
Memorillaが既存のAI要約技術と異なる点は、「圧縮のタイミング」です。ドキュメントを読み取る際に即座に要約する従来の方法は、後になってどのような質問が来るかを考慮していません。一つの要約をあらゆる質問に適用する必要があるため、質問との関連性が薄まる可能性があります。
一方、Memorillaは質問が入力されるまで圧縮を行いません。まずドキュメント履歴を「Qwen3-Embedding-4B」エンコーダーで一度だけ数値リストへ変換して保存します。実際の質問が入力されて初めて、16個の学習済みメモリスロットが全保存領域を走査し、「この質問に答えるには、この情報とあの情報を結び付ける必要がある」という文脈を抽出します 1。質問が変われば、圧縮される情報の内容も変わります。
このプロセスにおいて、回答を生成するLLM(Qwen3-8B)とエンコーダーは、学習されない状態で固定(フリーズ)されます。言語モデル自体を訓練するのではなく、ドキュメント埋め込みをLLMの入力空間へ変換する194Mサイズの中間モジュールのみを学習します 23。単語(トークン)の代わりに「意味が凝縮されたベクトル」を、LLMの入力埋め込みの手前に直接配置することになります。このような構造的特徴により、Memorillaはテキストのみをやり取りする一般的なAPI方式では使用できず、LLMの内部を制御できることが適用の前提となります 3。
16個のベクトルがもたらした定量的な成果と速度
メモリトークン数を16個に固定すれば、演算量と処理速度において効率性が向上します。研究チームのデータによると、ドキュメント保存領域が1個から512個(約128Kトークン)へ拡大しても、Memorillaの応答生成時間は0.74秒で変化しない「定数遅延」を維持しました。ドキュメント全体をLLMに入力する方式が、ドキュメントが蓄積するにつれて遅延が19.9秒まで増大したのと比較すると、約27倍の高速化です 12。
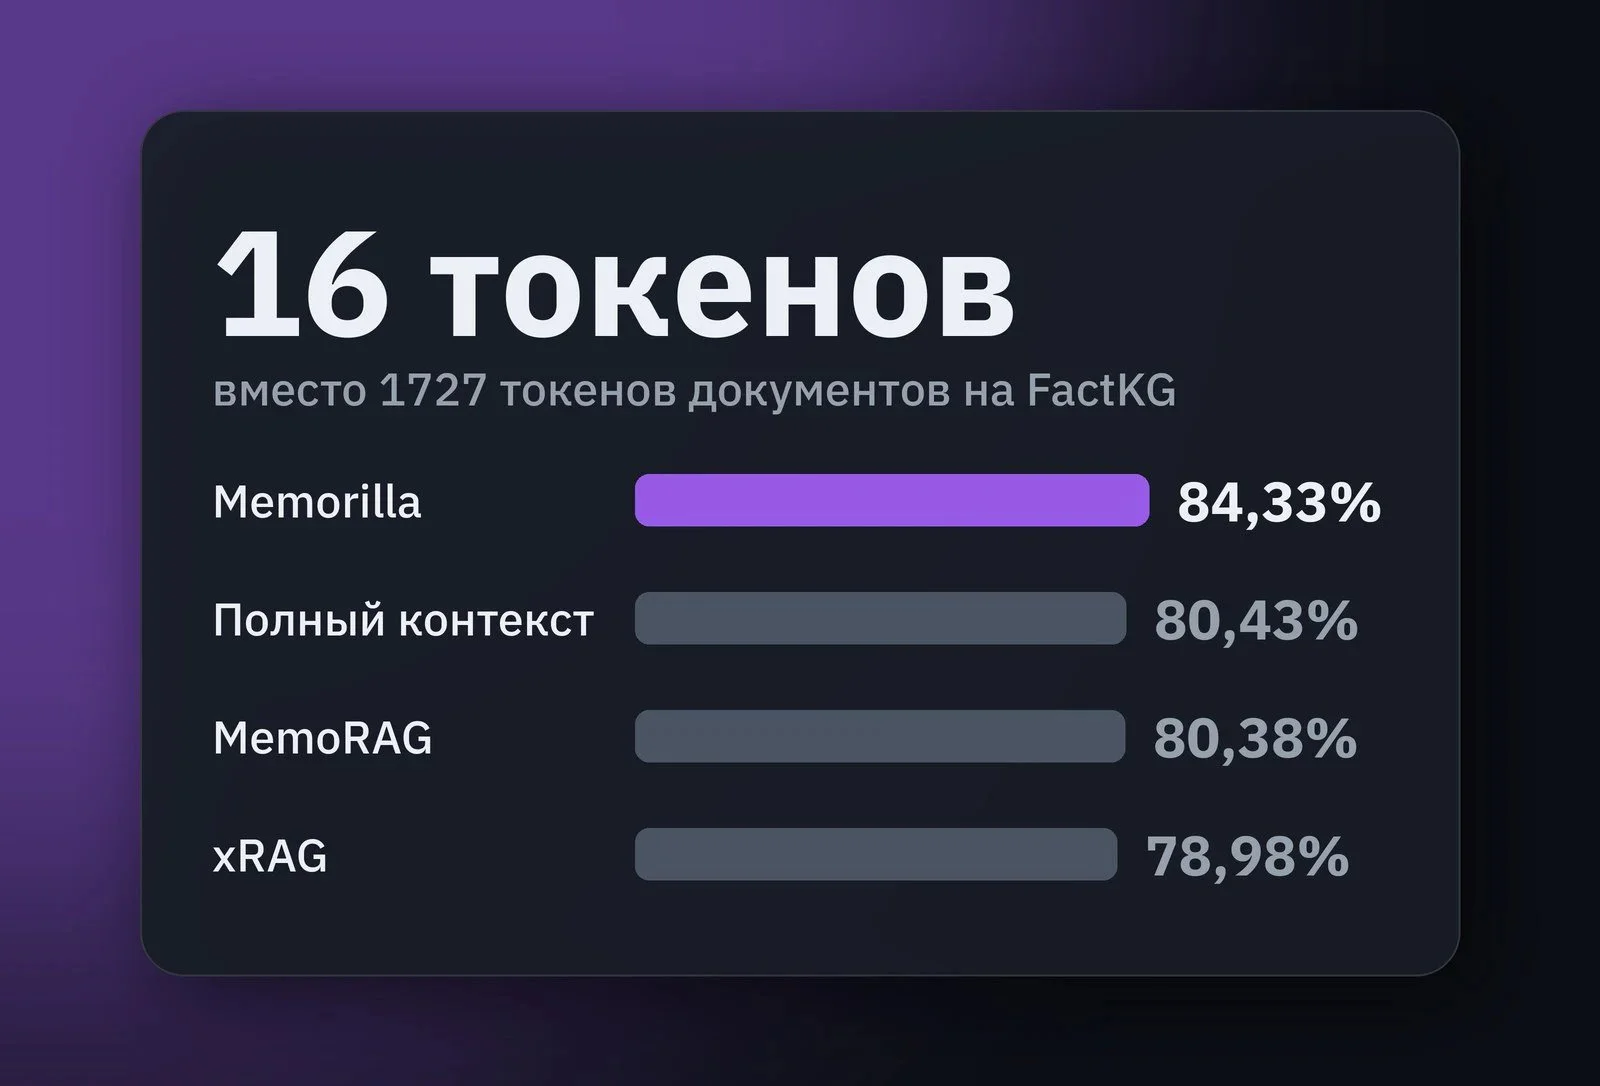
速度だけではありません。複数の事実や手がかりを一つに結び付けて回答すべき複雑な質問においては、ドキュメント全体を読み込ませるよりも高い性能を示すケースもあります。複数の事実知識グラフを検証するFactKGベンチマークにおいて、Memorillaは84.33%の精度を記録しました。全コンテキストを読み込む方式(80.43%)よりも精度が高い一方で、入力されるドキュメントトークンは108分の1にすぎませんでした 41。全コンテキスト方式がすべての事実を読み込みながら遅れを取ったことを考慮すれば、Memorillaの優位性は単純な情報量に起因するものではないと見られます。
特に、一つの正答のために4つ以上の複雑な事実を組み合わせる必要がある際に差が顕著になります。50個のドキュメントを検索するRAG方式では、性能が78.7%から51.8%へ急激に低下しました。対してMemorillaは、複数ドキュメントに分散した事実の関係を同時に圧縮するため、80%台の精度を維持しました 13。パーソナライズされた対話データを用いたPersonaMem-v2ベンチマークにおいても、Memorillaは44.6%の精度を達成し、最強のRAG方式であるxRAG(30.9%)や全コンテキスト方式(27.9%)を大きく上回りました 1。
「朝食メニュー」という質問と「糖尿病」が結び付く理由
Memorillaの動作方式は、前述の失敗例を通じて明確に確認できます。ユーザー履歴中の「母方の糖尿病リスク」という手がかりと、「朝食は何にしよう?」という質問との間には、単語の重複が全くありません。
メモリを持たない一般的なLLMは、「朝食は何にしよう?」という質問に対し、糖尿病の文脈とは無関係な一般的な朝食リストを提示します。対してMemorillaは、「質問:朝食」と「保存領域:過去の糖尿病の家族歴への言及」の間の弱い意味的関連性をクロスアテンションによって発見し、16個のベクトルへ変換します。そしてこれをLLMの入力埋め込みの手前に配置します。その結果、LLMは単純な朝食メニューのリストではなく、過去の対話でたった一度だけ登場した糖尿病の家族歴を基盤として、血糖値コントロールと満腹感を同時に考慮したスクランブルエッグやギリシャヨーグルトといったパーソナライズされた回答を生成します 2。
依然としてRAGが強い「正確な名前」と細かい情報
Memorillaの意味圧縮技術は、複雑な関連性を用いた推論において強力ですが、あらゆる領域で万能というわけではありません。原文ではなく圧縮されたベクトルのみが注入されるため、ドキュメントに記載された正確な文字列や細部事実が失われる可能性があります。研究チームは、圧縮がドキュメントの構造や意味を保持すると推定しつつも、正確な名前や具体的な詳細事実は失われる可能性が高いという限界を自ら明らかにしています 13。
この限界は数値で確認されています。短い医学論文アブストラクトから明確な細項目を見つける必要があるPubMedQAベンチマークでは、Memorillaが59%を記録し、原文を圧縮または検索して投入するLLMLingua-2(69%)より低い性能を示しました 13。長編小説を読んだ後に質問するNarrativeQAにおいても、質問の種類によって結果が分かれました。「なぜ」「どのように」を問う質問では、MemorillaがRAGより5〜7パーセントポイント高いROUGE-Lスコアを示しましたが、正確な名前や対象を問う「誰が(who)」「どれが(which)」という質問では、原文をそのまま取得したRAGが3パーセントポイント前後高いスコアを記録しました 13。
Memorillaの性能は、研究チームが用意した特定の組み合わせ(Qwen3-8B単一モデル)と、独自の学習分割に基づくベンチマーク環境で測定された数値です 3。独立した再現検証はまだ実施されていないため、他のモデルや一般的なテキストAPI環境で同様に適用できる汎用的な基準だと断定することは困難です。
Memorillaが古い糖尿病への言及を引き出せた理由は、質問を基準として全ドキュメントを走査し、必要な因果関係を16個のベクトルへ再構成したことにあります。これは、AIの記憶を単なるテキストの蓄積や要約から、「質問依存型意味単位の圧縮」へと拡張する試みです。ただし、特定の人物の正確な名前や短い詳細項目を尋ねる必要がある場合は、原文をそのまま探す検索方式が依然として強力であり、両アプローチを組み合わせることが今後の方向性になると見られます 3。
参考文献
- MEMORILLA: Latent Semantic Memory for LLMs · memory.stanford.edu↩
- ↩
- Memorilla: 16 векторов памяти вместо RAG для LLM · tproger.ru↩
- Memorilla: Latent Semantic Memory for LLMs · arxiv.org↩



