玩《宝可梦 火红》的 AI 智能体在月见山洞穴中三次回到同一条路线。这并非由于模型的算力不足。问题出在一行错误记忆的笔记中,智能体将洞穴入口旁宝可梦中心的位置误记为山的“东侧”。当它离开中心时,误以为自己已经穿过大山,于是便沿着脸颊之下折返,重复了三次回到原路的循环。当 Anthropic 对这个记忆文件夹应用了被称为“Dreaming(做梦)”的步骤后,该智能体将自己的笔记与原始作业记录(日志)进行了对照,修正了错误的行,并在下一次尝试中顺利通过洞穴,到达了下一座城市蓝之市 1。
说“AI 在做梦”并不意味着指代某种神秘的意识现象。这里的“做梦”是指智能体在完成作业后的空闲时间里,重新审视积累的记录、回顾自己的笔记并修正错误的检验环节。本文将具体探讨 Anthropic 发布的“做梦”过程执行何种任务,以及当笔记得到修正和整理时,在性能方面会体现出怎样的差异,并通过实际实验数值加以解析。
“梦”这一比喻背后的简单行为机制
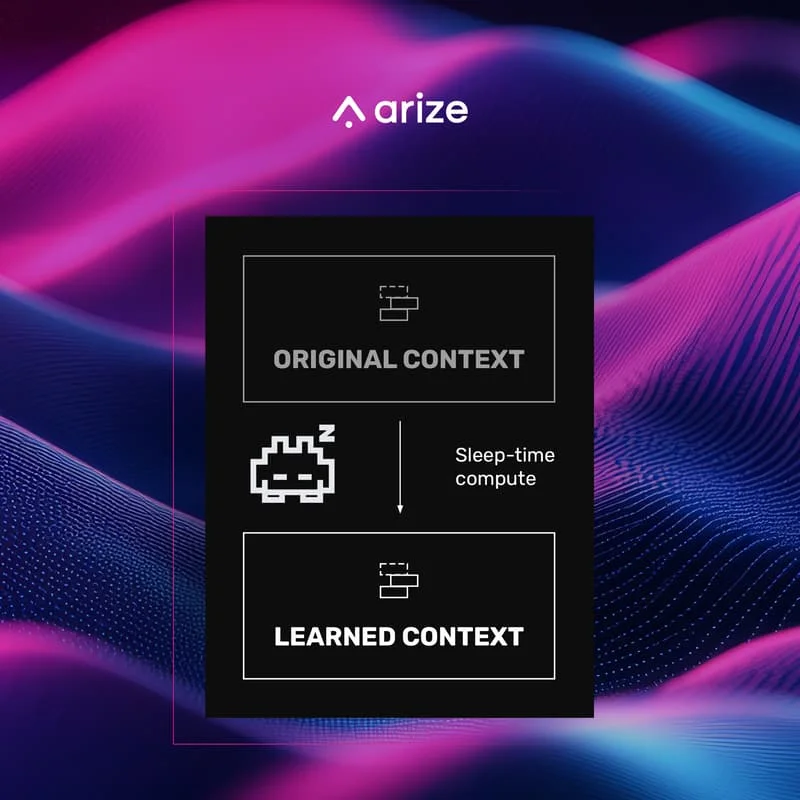
如果用一句话概括“做梦”,那就是智能体在作业结束后打开原始作业记录,将其与自己的笔记进行对照、修正错误,并整理散乱内容的过程 1。这一概念源于 Letta 和加州大学伯克利分校研究团队提出的“睡眠时间计算(Sleep-time Compute)”。Letta 研究团队在 2025 年 4 月 21 日的博客中介绍,在用户未直接进行交互的空闲时间内,让智能体基于持久化记忆重新组织信息并进行预先推断,可以在未来的对话中减少不必要的计算 2。其核心思想是将未经处理的“原始上下文(raw context)”转换为经过整理的“习得上下文(learned context)” 2。
Anthropic 所提出的“做梦”是将这一构想移植到智能体的作业记录中。其结构如下:最底层是可检索的原始作业记录,其上是只提取重要内容的笔记,通过链接将主题页面连接起来的 Wiki,以及每次开启新会话时自动读取的信息。“做梦”就是指将这些上层记录与下层的原始记录进行对照、构建并修正的相互关系 1。因此,“梦”一词并非指代类似生物睡眠的意识状态,而是将记忆整理穿插于主作业之间这一调度机制的比喻表达。
笔记的“类型”与“阅读习惯”决定分数
“做梦”所做的第一件事是改变笔记的质量。Anthropic 在评估记忆利用能力的 CL-Bench 1.0 数据库查询任务中,要求针对每个问题开始新的会话,且只能继承上一次会话中记忆文件夹的文件 1。回答之后会给出正确答案,让模型探究错误原因,并记录对下一个问题有帮助的内容。在此过程中,各模型的做法产生了分歧。Sonnet 4.6 将导致答案错误的未经验证的推测散落在多个文件中,而 Opus 5 则先测试原因,只记录已验证的规则及其依据 1。
结果直接体现在分数上。在回答质量的平均评分(即平均奖励分)中,Opus 5 在没有记忆的情况下为 0.564,但在使用经过“做梦”整理的记忆文件夹时提升至 0.828 1。另一方面,留下未经验证推测的 Sonnet 4.6 在同样的对比中仅从 0.330 提升至 0.364 1。留下已验证规则的路径与留下推测的路径之间存在显著差异。不过,像 Opus 5.5 或 Sonnet 5.5 这样留下已验证规则的其他模型分别取得了 0.838 和 0.833 的分数,与 Opus 5 相当,且在无记忆条件下反而略高于 Opus 5 1。正如这些数值所显示的,“做梦”的优势并非来自记忆数量的多少,而是来自区分已确认事实与推测的方式。
即便笔记写得很好,如果不阅读也是无效的。在实验中,Sonnet 4.6 在回答前打开记忆文件的比例甚至不足一半,但 Sonnet 5 在没有额外指示的情况下,十次中有九次打开了记忆 1。当指示 Sonnet 4.6 在回答前阅读记忆并测试原因假设时,分数从 0.364 提升至 0.641。这是各条件执行三次后的平均值 1。这一表现表明,取出并使用整理后的笔记这一习惯本身可能成为性能的瓶颈。相反,如果过于一律地限制记录什么,反而会带来损失。当给 Opus 5 加上“只记录失败”的指令时,其提升幅度反而减少了。Anthropic 解释说,对于高性能模型,与其强行规定具体的筛选标准,不如交由模型自行判断 1。
如果没有“做梦”,记录管理会吞噬主作业
选择记录的能力之所以重要,在《宝可梦 火红》实验中体现得更为鲜明。Anthropic 分别运行了一次 Sonnet 3.7 和 Fable 5,比较了它们在第 1 万步时的记忆 1。Sonnet 3.7 详尽地记录了战斗、道具和遇到的人物,在 225 个文件夹中留下了 413 个文件。问题在于,由于游戏状态不断变化,这些详尽的记录很快便过时了。检索过时记录消耗了更多的时间和资源,直到约第 1 万步左右,它开始创建第四个整合记忆文件夹。随后的 17 个步骤中,它创建了 6 个文件并删除了 9 个,却在游戏内未采取任何行动 1。
Fable 5 则不同。它没有记录那些每次都可以从屏幕确认的当前位置或金钱,只记录了自主发现的战略和计划。它在两个文件夹中维持了 9 个文件,加上一个全局文件(global.md),总共 10 个文件,结果将 Sonnet 3.7 仅获得的 1 枚徽章增加到了 4 枚 1。这一对比反向说明了“做梦”的必要性。如果缺乏与原始记录对照、整理过时和错误信息的环节,管理疯长的记录本身就会侵蚀主作业。Claude 在洞穴中徘徊三次,也是因为一次错误的定位被随后直接使用于判断,从而导致了这一问题 1。
将散落文档串联起来的 Wiki “做梦”
“做梦”并不止步于修正单个笔记,还可以扩展至按主题连接分散信息的 Wiki。Anthropic 针对被其收购的软件公司 Stainless 的内部资料约 35 万项(以模型处理文本的单位“token”计约 4.2 亿个)尝试了这一方法 1。它让 Opus 5 智能体在最多 128 个会话中撰写 Wiki,继承前一个会话留下的链接,添加页面,合并重复内容,并与出处对照。当撰写 Wiki 的会话从 2 个增加到 128 个时,仅查看 Wiki 进行回答时的评分标准达成率从 13% 提升至 48% 1。
这与搜索有何不同?仅使用搜索时的得分为 53%。将 Wiki 与搜索结合使用时则提升至 54% 到 61% 1。这些比率表示的是满足针对 25 个问题分别设定的评估标准的程度。特别是在需要综合多个文档信息的问题中,Wiki 的效果显著,这在关于收购的独立测试(24 个问题)中得到了证实。在该测试中,对于分类为需要文档综合或判断、计算的条目,参考 Wiki 时达到了 87%,而仅使用搜索时为 73% 1。Anthropic 报告称,若将“做梦”生成的 Wiki 与搜索结合使用,每个问题约可节省 2 万个 token。这是在寻找答案时的成本节约,但预先制作和管理 Wiki 则需要额外的计算 1。
不过,即便是这种 Wiki,编写指南也决定了其质量。在假设存在企业收购的法律审查任务中,评分依据是是否准确描述了合同条件。由于最初的指南并未要求保留合同条件,多个智能体在同一个共享表中记录条件时相互覆盖,导致部分消失,最终只有 57 项评估对象事实中的 41 项(约 72%)进入了审查文书 1。在分析失败原因并更改指南,让每个合同由智能体负责单独的页面并按原文引用条件后,新的 Wiki 保留了全部 57 项事实,审查文书也完全满足了该任务的标准 1。这意味着,无论整理过程多么精细,如果保留的内容与使用目的不匹配,也是毫无用处的。
结论:“做梦”并非魔法,而是“检验规则”的问题
用一句话概括通过“做梦”所报告出的差异,那就是它与各任务中应用到的笔记和 Wiki 的回顾、对照、整理步骤有关。未经修正的《宝可梦 火红》记忆导致智能体三次陷入相同的循环而未能到达蓝之市,但在使用“做梦”后将笔记与原始作业记录对照修正的记忆继续进行时,智能体绕过了洞穴并到达蓝之市。在 CL-Bench 数据库任务中,留下已验证规则的 Opus 5,其平均奖励分从无记忆时的 0.564 提升至使用记忆文件夹时的 0.828。不过,在同一任务中,留下已验证规则的 Opus 5.5 和 Sonnet 5.5 分别取得了 0.838 和 0.833 的相近分数,且在无记忆条件下略高于 Opus 5。在 Stainless 资料中,将撰写 Wiki 的会话从 2 个增加到 128 个,仅查看 Wiki 进行回答时的评分标准达成率从 13% 提升至 48%;仅使用包含 128 个会话的 Wiki 时得分低于仅使用搜索时的 53%,而在将 Wiki 与搜索结合使用时则提升至 54% 到 61% 1。因此,共同确认的一点是:在应用了“做梦”的案例中,检查并修正笔记和 Wiki 的步骤起了作用,但这并不能证明所有效果都源于单纯打开原始日志这一单一机制 1。
然而,“做梦”并非单纯地堆积新记忆,而是回顾并修正既有笔记和 Wiki,必要时添加页面或重新建立链接的整理步骤,因此随之而来的是设计上的判断。如果写了笔记但在新会话中不打开阅读,就无法利用该笔记;也有模型因持续管理过时信息而将主作业停止了 17 个步骤 1。Anthropic 承认,记忆可能在最初记录时就存在错误,或者随环境变化而过时,并将调整检查周期(即检查变更可能性大的信息或高频使用信息的先后顺序)以应对每次检查所有记忆所带来的成本,列为未来课题 1。归根结底,“做梦”并非魔法般的自动整理,关键在于由谁以何种指南设计缩小原始记录与笔记之间差距的规则。
参考资料
- 꿈을 꿔서 장기기억 달성하는 클로드 새로운 기능 소개 · gall.dcinside.com↩
- Sleep-time Compute · letta.com↩



