포켓몬 레드를 하던 AI 에이전트가 달맞이산 동굴에서 세 번이나 같은 길을 되돌아갔습니다. 모델의 연산 능력이 부족해서가 아니었습니다. 동굴 입구 옆 포켓몬센터의 위치를 산의 '동쪽'으로 잘못 적은 메모 한 줄이 문제였습니다. 센터를 나올 때 이미 산을 통과했다고 착각한 에이전트는, 턱 아래로 내려가 원래 왔던 길로 돌아가는 루프를 세 번 반복했습니다. 앤트로픽이 이 기억 폴더에 '드리밍(dreaming)'이라 부르는 단계를 적용하자, 에이전트는 자기 메모를 원래 작업 기록(로그)과 대조해 위치 한 줄을 고쳤고, 다음 시도에서 동굴을 통과해 다음 도시인 블루시티에 도착했습니다 1.
'AI가 꿈을 꾼다'는 말이 신비로운 의식 현상을 뜻하는 것은 아닙니다. 여기서 드리밍은 작업을 마친 에이전트가 유휴 시간에 쌓인 기록을 다시 열어 자기 메모를 되읽고 오류를 고치는 검수 단계입니다. 이 글에서는 앤트로픽이 공개한 '드리밍'이 구체적으로 어떤 작업을 수행하는지, 그리고 메모를 고치고 정리했을 때 성능에서 어떤 차이가 나타났는지 실제 실험 수치로 따져봅니다.
'꿈'이라는 비유 뒤에 있는 단순한 동작
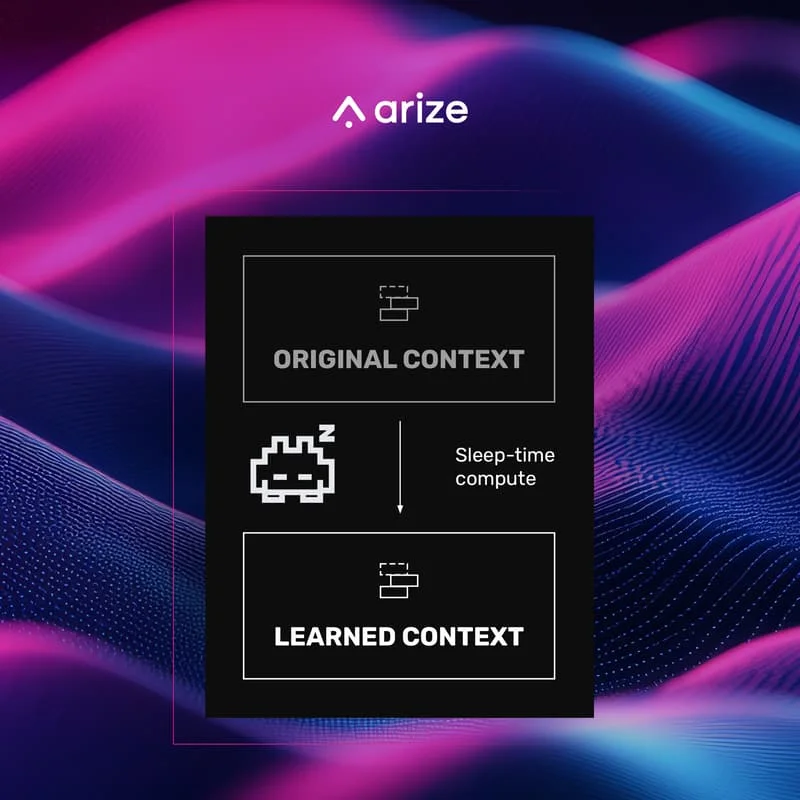
드리밍을 한 문장으로 줄이면, 작업이 끝난 뒤 에이전트가 원본 작업 기록을 열어 자신의 메모와 대조하고 오류를 고치며 흩어진 내용을 정리하는 과정입니다 1. 이 개념의 뿌리는 레타(Letta)와 UC 버클리 연구진이 제안한 '수면 시간 연산(sleep-time compute)'에 있습니다. 레타 연구팀은 2025년 4월 21일 블로그에서, 사용자가 직접 상호작용하지 않는 유휴 시간에 에이전트가 지속된 기억을 바탕으로 정보를 재구성하고 미리 추론하도록 하면, 나중에 대화할 때 불필요한 계산을 줄일 수 있다고 소개했습니다 2. 이때 원시 데이터 그대로인 '원시 컨텍스트(raw context)'를 정리된 '학습된 컨텍스트(learned context)'로 변환하는 것이 핵심 아이디어입니다 2.
앤트로픽이 말하는 드리밍은 이 발상을 에이전트의 작업 기록에 옮긴 것입니다. 구조는 다음과 같습니다. 가장 아래에 검색 가능한 원본 작업 기록이 있고, 그 위에 중요한 내용만 추린 메모, 주제별 페이지를 링크로 이은 위키, 그리고 새 세션이 시작될 때마다 자동으로 읽히는 정보가 올라갑니다. 드리밍은 이 위쪽 기록들을 아래쪽 원본 기록에 대조해 만들고 고치는 관계를 뜻합니다 1. 따라서 '꿈'이라는 단어는 생물학적 수면과 닮은 의식 상태를 가리키는 것이 아니라, 본 작업 사이에 메모리 재정리를 끼워 넣는 스케줄링을 비유한 표현입니다.
메모의 '종류'와 '읽는 습관'이 점수를 가른다
드리밍이 하는 첫 번째 일은 메모의 질을 바꾸는 것입니다. 앤트로픽은 기억 활용 능력을 평가하는 CL-Bench 1.0의 데이터베이스 질의 과제에서, 질문마다 새 세션을 시작하고 이전 세션의 기억 폴더 파일만 이어받을 수 있게 했습니다 1. 답변 후에는 정답을 알려줘 틀린 이유를 알아보고 다음 질문에 도움이 될 내용을 기록할 기회를 줬습니다. 여기서 모델들의 방식이 갈렸습니다. 소네트(Sonnet) 4.6은 오답의 원인에 대한 미검증 추측을 여러 파일에 흩뿌렸고, 오퍼스(Opus) 5는 원인을 먼저 시험한 뒤 검증을 마친 규칙과 그 근거만 기록했습니다 1.
결과는 점수에서 그대로 드러났습니다. 답변에 매긴 점수의 평균인 평균 보상 점수를 보면, 오퍼스 5는 기억 없이 0.564였으나 드리밍을 통해 정리된 기억 폴더를 사용했을 때 0.828로 올랐습니다 1. 반면 미검증 추측을 남긴 소네트 4.6은 같은 비교에서 0.330에서 0.364로 오르는 데 그쳤습니다 1. 검증된 규칙을 남긴 경로와 추측을 남긴 경로의 차이가 큽니다. 다만 오퍼스 5.5나 소네트 5.5처럼 검증 규칙을 남긴 다른 모델은 0.838과 0.833으로 오퍼스 5와 비슷했고, 기억이 없는 조건에서는 오히려 오퍼스 5보다 약간 높은 점수를 받았습니다 1. 이 수치가 보여주듯, 드리밍의 이점은 메모 양 자체가 아니라 확인된 사실과 추측을 가려내는 방식에서 옵니다.
메모를 잘 써도 읽지 않으면 소용이 없습니다. 실험에서 소네트 4.6은 답변 전에 기억 파일을 여는 비율이 절반에도 못 미쳤지만, 소네트 5는 별도 지시 없이 열 번 중 아홉 번을 열었습니다 1. 소네트 4.6에게 답변 전 기억을 읽고 원인에 대한 가설을 시험하라고 지시하자, 점수가 0.364에서 0.641로 올랐습니다. 각 조건을 세 번 실행한 평균 값입니다 1. 정리된 메모를 꺼내 쓰는 습관 자체가 성능의 병목이 될 수 있음을 보여주는 대목입니다. 반대로 무엇을 기록할지 너무 일률적으로 제한하면 손해가 생겼습니다. 오퍼스 5는 '실패만 기록하라'는 지침이 붙자 오히려 향상 폭이 줄었습니다. 앤트로픽은 성능이 높은 모델에는 구체적인 선별 기준을 강요하기보다 모델 자체 판단에 맡기는 편이 낫다고 설명합니다 1.
드리밍이 없으면, 기록 관리가 본 작업을 잡아먹는다
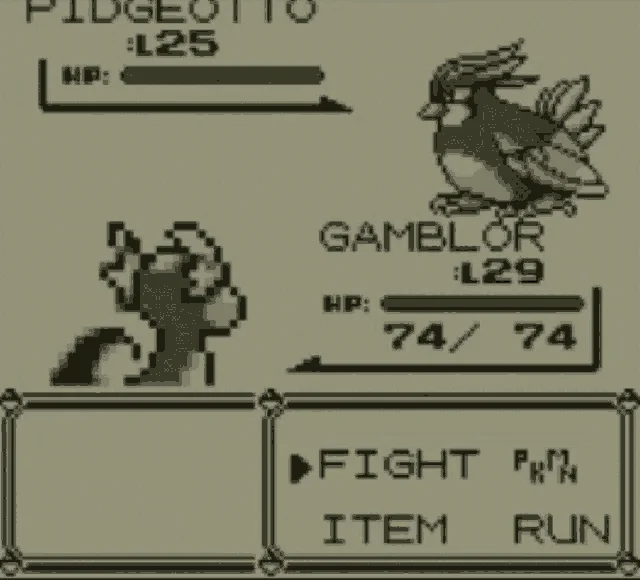
기록을 선택하는 능력이 중요한 이유는 포켓몬 레드 실험에서 더 생생하게 확인할 수 있습니다. 앤트로픽은 소네트 3.7과 페이블(Fable) 5를 각각 한 번 실행해 약 1만 단계 시점의 기억을 비교했습니다 1. 소네트 3.7은 전투, 아이템, 만난 인물을 촘촘히 적어 225개 폴더에 파일 413개를 남겼습니다. 문제는 게임 상태가 계속 바뀌니 이 촘촘한 기록이 금세 낡아 버렸다는 점입니다. 낡은 기록을 뒤지는 데 시간과 자원이 더 들었고, 약 1만 단계 무렵에는 네 번째 통합 기억 폴더를 만들기 시작했습니다. 이어진 17단계 동안 파일 6개를 만들고 9개를 지우면서, 정작 게임 안에서는 아무 행동도 하지 못했습니다 1.
페이블 5는 달랐습니다. 화면에서 매번 확인할 수 있는 현재 위치나 소지금은 굳이 적지 않고, 스스로 알아낸 전략과 계획만 남겼습니다. 두 폴더 안의 파일 9개와 전역 파일(global.md) 하나로 총 10개를 유지했고, 그 결과 소네트 3.7이 1개에 그친 배지를 4개까지 얻었습니다 1. 이 대비는 드리밍의 필요성을 역으로 설명합니다. 원본과 대조해 낡고 잘못된 정보를 정리하는 단계가 없으면, 무성하게 불어난 기록을 관리하는 일 자체가 본작업을 잠식하기 때문입니다. 클로드가 동굴에서 세 번 헤맸던 것도, 한 번 잘못 적은 위치가 이후 판단에 그대로 쓰였기 때문에 벌어진 일이었습니다 1.
흩어진 문서를 하나로 꿰매는 위키 드리밍
드리밍은 개별 메모를 고치는 데서 멈추지 않고, 흩어진 정보를 주제별로 엮는 위키까지 확장할 수 있습니다. 앤트로픽은 자사가 인수한 소프트웨어 회사 스테인리스(Stainless)의 내부 자료 약 35만 개(모델이 텍스트를 처리하는 단위인 토큰으로 약 4억 2,000만 개)를 대상으로 이 방식을 시험했습니다 1. 오퍼스 5 에이전트들이 최대 128개 세션에 걸쳐 위키를 작성하고, 앞선 세션이 남긴 연결을 이어받으며 페이지를 추가하고 중복을 합치고 출처와 대조하게 했습니다. 위키 작성 세션이 2개에서 128개로 늘어나자, 위키만 보고 답했을 때의 채점 기준 충족률은 13%에서 48%로 올랐습니다 1.
검색과 어떻게 다를까요. 검색만 썼을 때의 점수는 53%였습니다. 위키와 검색을 함께 쓰면 54%에서 61%로 올랐습니다 1. 이 비율은 질문 25개에 각각 설정한 평가 기준을 얼마나 충족했는지를 나타냅니다. 특히 여러 문서의 정보를 엮어야 하는 질문에서 위키의 효과가 컸는데, 이는 합병 관련 별도 시험(질문 24개)에서 확인되었습니다. 해당 시험에서 문서 종합이나 판단·계산이 필요하다고 분류된 항목에서는 위키를 참조했을 때 87%, 검색만 했을 때 73%를 받았습니다 1. 앤트로픽은 드리밍으로 만든 위키와 검색을 함께 쓸 경우 질문당 약 2만 토큰을 절약할 수 있다고 보고했는데, 이는 답을 찾을 때의 비용 절감이고, 위키를 미리 만들고 관리하는 데는 별도의 연산이 필요합니다 1.
하지만 이 위키도 작성 지침이 품질을 결정합니다. 기업 인수 가정을 둔 법률 검토 과제에서는, 계약 조건을 정확히 설명했는지를 채점했습니다. 처음 지침이 계약 조건 보존을 요구하지 않자 여러 에이전트가 하나의 공유 표에 조건을 적다가 서로 덮어써 일부가 사라졌고, 평가 대상 사실 57개 중 41개, 약 72%만 검토문에 들어갔습니다 1. 실패 원인을 검토한 뒤 계약마다 에이전트가 개별 페이지를 맡고 조건을 원문 그대로 인용하도록 지침을 바꾸자, 새 위키는 57개 사실을 모두 보존했고 검토문도 그 과제 기준을 모두 충족했습니다 1. 정리 과정이 아무리 정교해도, 무엇을 남길지가 사용 목적과 맞지 않으면 소용없다는 뜻입니다.
결론: 드리밍은 마법이 아니라 '검수 규칙'의 문제
드리밍으로 보고된 차이를 한 문장으로 줄이면, 각 과제에 적용된 메모와 위키의 되읽기·대조·정리 단계와 관련되어 있습니다. 수정되지 않은 포켓몬 레드 기억은 세 차례 같은 루프로 돌아가 블루시티에 이르지 못했지만, 드리밍 후 메모를 원래 작업 기록과 대조해 고친 기억으로 진행한 경우에는 동굴을 돌아 블루시티에 도착했고, CL-Bench 데이터베이스 과제에서 검증 규칙을 남긴 오퍼스 5는 평균 보상 점수가 기억 없이 0.564에서 기억 폴더를 사용했을 때 0.828로 올랐습니다. 다만 같은 과제에서 검증 규칙을 남긴 오퍼스 5.5와 소네트 5.5는 0.838과 0.833으로 비슷했고, 기억이 없는 조건에서는 오퍼스 5보다 조금 높았습니다. 스테인리스 자료에서 위키 작성 세션을 2개에서 128개로 늘리자 위키만 보고 답했을 때의 채점 기준 충족률은 13%에서 48%로 올랐고, 세션을 128개로 늘린 위키만 쓴 점수는 검색만 쓴 53%보다 낮았으며, 위키와 검색을 함께 썼을 때 54%에서 61%로 올랐습니다 1. 따라서 공통적으로 확인되는 것은 드리밍이 적용된 사례들에서 메모와 위키를 점검하고 고치는 단계가 관련되어 있다는 점이지, 모든 효과가 원본 로그를 열기만 하는 단일 메커니즘으로 증명된 것은 아닙니다 1.
그러나 드리밍은 단순히 새 기억을 쌓는 일이 아니라 기존 메모와 위키를 되읽어 고치고, 필요하면 페이지를 추가하거나 링크를 다시 연결하는 정리 단계인 만큼, 설계상의 판단이 따라옵니다. 메모를 쓰되 새 세션에서 열어 읽지 않으면 그 메모를 활용할 수 없었고, 낡은 정보를 계속 관리하느라 본작업을 17단계나 멈춘 모델도 있었습니다 1. 앤트로픽은 기억이 최초 기록에서 틀리거나 환경이 바뀌며 낡을 수 있다고 인정하며, 모든 기억을 매번 검사하는 비용 때문에 바뀔 가능성이 큰 정보나 자주 쓰이는 정보부터 점검 주기를 조절하는 문제를 향후 과제로 남겼습니다 1. 결국 드리밍은 마법 같은 자동 정리가 아니라, 원본 기록과 메모 사이의 간격을 좁히는 규칙을 누가, 어떤 지침으로 설계하느냐에 달려 있습니다.
참고자료
- 꿈을 꿔서 장기기억 달성하는 클로드 새로운 기능 소개 · gall.dcinside.com↩
- Sleep-time Compute · letta.com↩