26B MoE 模型被开发者 Everett 粘贴到一个需要 24 小时运行的本地分类应用中,却意外陷入了瓶颈。模型本身足够聪明,但常驻内存导致笔记本的交换(Swap)使用量激增,威胁到了 SSD 的寿命。将大模型长期驻留在小设备上,存储设备难以承受。问题在于,他只需要一个擅长单一任务的模型。
Tolby 应用的作者 Everett 在“剪枝(pruning)”中找到了答案。这种方法大幅削减模型内部实际参与计算的组件——专家(expert),并对剩余部分进行重新对齐,从而构建出一个稠密(dense)模型。据他报告,这种结合剪枝、修复和锚定(pinning)的方法,在单一分类任务中与原始模型保持了 92% 的一致性,同时将内存占用减半(相比 12B 模型),速度提升了一倍。然而,本文更需要关注的关键点并非结果,而是过程。最常用专家保留的直觉为何完全失败,以及究竟应该以何种标准保留专家,才是该实验的核心所在。
MoE 的模型体积重于参与计算的组件
要理解此实验,首先必须审视 Gemma 4 26B-A4B 的结构。根据 Ollama 官方模型页面,该模型拥有总计 25.2B 参数,但实际计算仅使用 3.8B 参数,属于 MoE 模型。MoE(混合专家模型)将模型权重拆分为多个专家,每个令牌(token)由路由器(router)这一选择器从 128 个专家中仅激活 8 个进行计算 1。
在此,直觉与现实发生了冲突。既然每次只使用 8 个专家,为何需要保存全部 25.2B 参数?因为路由器为每个令牌更换专家,所以整个模型必须常驻内存,以便在任何时刻都能激活所需专家 2。也就是说,MoE 通过分离计算量和内存用量来降低计算复杂度。Everett 的问题正是源于这种计算与内存的分离。即便计算很轻,由于整个模型需加载到内存,小型设备便不堪重负。
因此,他反其道而行之。如果将路由器选中的 8 个专家直接固定为 8 个会怎样?若仅保留 8 个专家,选择器的对象也只有这 8 个,路由器实质上便消失了。参与计算的组件大小与模型大小达成一致,即 MoE 转变为稠密模型的那一刻 3。最终成品是一个拥有 3.81B 参数的稠密模型。唯一的问题在于,保留哪 8 个专家。
“保留常用项”直觉的崩塌
首先想到的标准是使用频率。从 Everett 找到的专家使用可视化资料来看,在生成(decode)阶段,大部分专家几乎不被激活,只有少数专家出现明显的尾部分布 2。推测认为只需保留最常用的部分并丢弃其余,似乎极为合理。他尝试了基于“热度”的剪枝,即仅选择排名靠前的专家。结果彻底崩塌。尽管 Claude 等模型警告称这会失败,但他起初认为只是选择失误,于是重试了一次 2。
要理解失败原因,必须区分模型处理提示词的两个阶段。读取(prefill)是一次性处理完整提示词的阶段,写入(decode)是逐词生成答案的阶段。Everett 在实验中分离这两个阶段的原因正在于此 2。然而令人惊讶的是,当专家数量减少到 16 个以下时,崩溃的不是写入阶段,而是读取阶段。写入阶段尚能忍受剪枝,但读取阶段的表现却崩塌到无法使用的程度 2。
由此得出核心教训。在 MoE 中,常用的并不等于重要的。Everett 提出假设:即使某个专家仅对特定令牌激活一次,该专家也可能对整体表达产生不成比例的巨大影响 2。参考可解释性研究的趋势,据报告指出,边界令牌(boundary token),即模型准备答案的关键点,往往发生重要决策 2。如果几乎不被使用的专家正是在该点激活一次从而改变全局,那么频率就完全无法反映重要性。最终,他转而采用以贡献度而非频率为标准来选择专家,以确保准确性。
在块边界进行“修复”的方法
即使确定了要保留的专家,也必须填补剪枝造成的空缺。Everett 将此过程称为“修复(healing)”。这意味着像扑灭蔓延的火灾一样,平息受损的内部表达并恢复至原始状态,本文将此阶段比喻为“灭火器”。
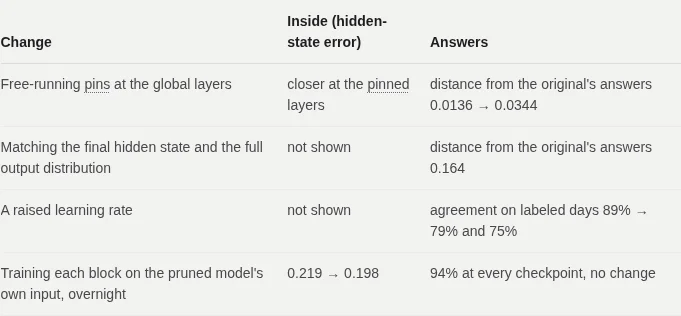
在剪枝过程中,他观察到一个有趣的现象。经过滑动窗口层时增大的误差,在经过块末尾的全局注意力层时反而减小了 2。由于全局注意力层观察整个上下文,看似在修复前面的损伤。不过,Everett 本人加注说明:“与其断定此解释正确,不如说是正在为现象寻找一个看似合理的理由” 2。无论如何,他认为如果使全局注意力层的输出值尽可能接近原始模型,即使内部重新排列,也能在块边界恢复状态。
他使用的工具是锚定(pinning)。该方法不是仅仅在模型末端追求正确答案,而是直接训练中间表达(hidden state)在块边界匹配原始模型的表达 2。他用一句话总结了这种差异:“不是让答案正确,而是让其产生相同的想法” 3。这就是块级训练(block-local training)的本质。实际上,在首次修复运行中,基于零学习提示词的误差从 0.69 降至 0.42,减少了约 40% 2。不过,Everett 诚实地记录道:“并未与原始模型完全一致”,状态仅恢复了一半。
单一任务表现良好,其余能力丧失
必须分离地看待此过程产生的结果与局限性。在分类任务中,压缩模型与原始 26B 模型的一致性为 92%。作为参考,同一项目中 12B 模型与 26B 的一致性比例为 90%,因此 3.81B 的压缩模型展现了相当或更优的一致性 32。尽管这未达到 Everett 最初设定的 98% 目标 2。他报告称,在该规模上,它优于同参数级的 Gemma 4 E2B(约 5B) 2。
最初因交换空间增加而担忧 SSD 的问题,是此实验的实际驱动力 2。
然而,丧失的能力也很明显。Everett 明确指出,该模型不适用于通用任务,需要知识的工作性能大幅下降。解释是因为知识被剪除了 3。虽然通过块级训练对齐了思考过程而非答案,但仍未能与原始模型完全一致 32。他提出方法的效率也仍在验证中。他认为可以在用户设备上用自有数据以约 5GB 内存进行训练,但明确表示“尚未在真实用户设备上测试” 3。该实验自我定义为非研究项目,而是工程副业 2。
影响而非频率决定专家的选择
最终,此实验回答的问题只有一个。即便剪除 MoE 权重的 85%,能否胜任单一任务?答案是“能胜任单一任务,但保留标准决定成败”。从 128 个专家中选择 8 个时,保留最常用的直觉方法在读取阶段使整个模型崩溃 2,只有选择了真正为准确性做出实际贡献的专家后,才开启了将块边界修复以匹配原始模型的路径 2。结果是,在单一分类中保持 92% 一致性,内存减半,速度加倍 3,但通用知识也随之被剪除 3。
留给读者的实用结论简化为两点。第一,在 MoE 轻量化中,若要缩小路由器选择的活跃参数数量与模型整体大小之间的差距,必须固定路由器,并将选择专家的标准从使用频率改为影响力。第二,这种“灭火器”模型始终是将原始模型的特定表达移植到小型稠密模型的尝试,而非所有任务皆精的万能小型化。当放下“保留常用项”这一假设的瞬间,便成为了在小设备上保留大模型单一功能的起点。