24時間稼働のローカル分類アプリに26B MoEモデルを組み込んだ開発者のEverett氏は、予期せぬ場所で壁にぶつかりました。モデル自体は十分に賢かったものの、常駐メモリによってノートPCのスワップ使用量が増加し、SSDの寿命を脅かしたのです。大きなモデルを小さなデバイスに長時間載せ続けると、ストレージが耐えられなかったというわけです。必要だったのは、たった一つのタスクだけを確実にこなすモデルでした。
Tolbyアプリの作者であるEverett氏は、その答えを「プルーニング(pruning、枝刈り)」に求めました。モデル内部で実際の計算を行う部品である専門家(expert)を大幅に減らし、残った部分を再整列させることで、一つの密接(dense)モデルを構築する方法です。彼の報告によれば、この枝刈り・修復・フィニグ(pinning)を組み合わせた手法は、ある分類タスクにおいて元モデルとの一致率92%を達成しつつ、12Bモデル comparedにメモリを半減、速度を2倍に改善しました。ただし、この記事で確認すべきより重要なポイントは、結果ではなくプロセスです。最も頻繁に使われる専門家だけを残せばよいという当然の直感がなぜ完全に失敗したのか、そしてどのような基準で残すべきか、この実験の核心はそこにあります。
MoEは計算に使用する部品よりも重いモデル
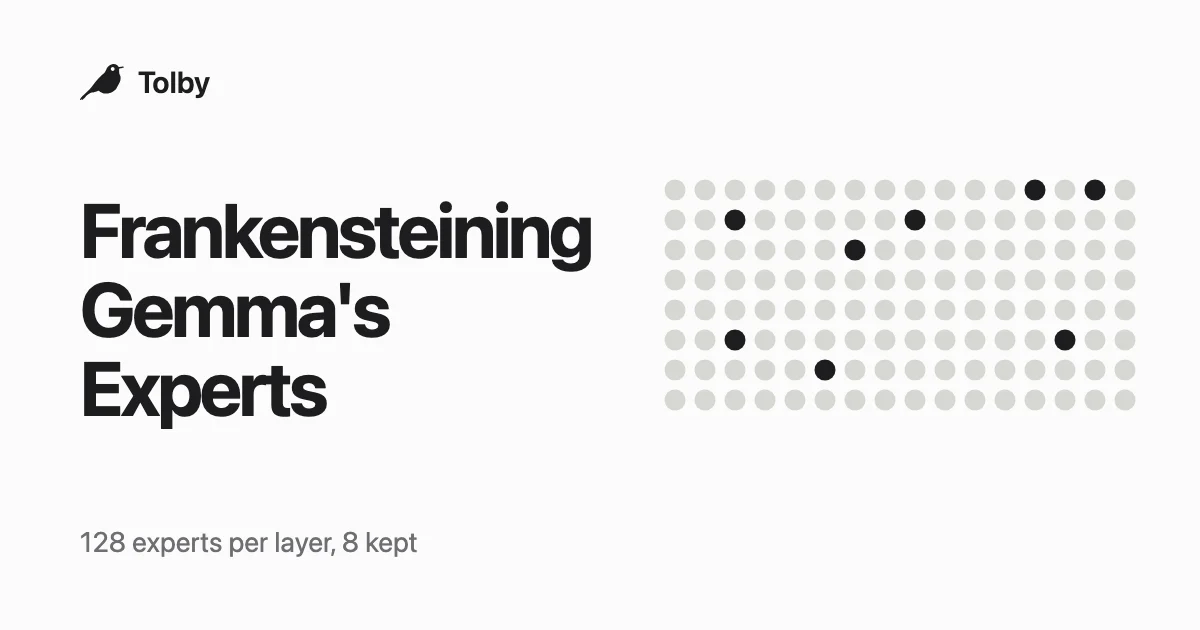
この実験を理解するには、まずGemma 4 26B-A4Bがどのような構造をしているかを確認する必要があります。Ollamaの公式モデルページによると、このモデルは総計25.2Bパラメータを持つものの、実際の計算には3.8Bのみを使用するMoEモデルです。MoE(Mixture of Experts、混合専門家モデル)は、モデルの重みを複数の専門家に分割して配置し、トークンごとにルーター(router)という選択機が128個中から8個のみを起動して計算させる構造です 1。
ここで直感と現実が一致しません。一度に8個しか使わないのに、なぜ25.2Bをすべて保存する必要があるのでしょうか。ルーターがトークンごとに専門家を入れ替えるため、モデル全体がメモリ上に常駐していなければ、任意の瞬間に専門家を起動できないからです 2。つまりMoEは、計算量を削減する代わりに、メモリ使用量を計算量から分離した構造です。Everett氏の課題は、まさにこの計算とメモリの分離によって生じました。計算自体は軽量化されていても、モデル全体をメモリに載せる容量のせいで、小さなデバイスが息苦しくなったのです。
そこで彼は逆の発想を試みました。ルーターが選ぶ8個を、最初から8個に固定してしまえばどうなるでしょうか。専門家を8個だけ残せば、選択機が選ぶ対象も8個しかないため、ルーターは事実上不要になります。計算に使用する部品の数とモデルサイズが一致する、すなわちMoEが密接モデルに変貌する瞬間です 3。最終的な成果物は、3.81Bパラメータの密接モデルとなりました。問題はたった一つ、どの8個を残すかという点でした。
「頻繁に使うものを残す」という直感の崩壊
真っ先に浮かぶ基準は使用頻度でした。Everett氏が発見した専門家の使用頻度可視化データによると、回答を生成(decode)する段階において、多くの専門家はほとんど起動せず、少数だけが際立つしっぽ分布(ロングテール)が明らかになりました 2。頻繁に使われるものだけを残し、残りは削除すればよいという推測は、極めて合理的に見えました。彼は上位の専門家だけを選択する「人気ベースの枝刈り」を試みましたが、結果は完全な崩壊でした。Claudeなどのモデルは失敗を警告しましたが、彼は単に選択が誤りだったと考え、再挑戦しました 2。
失敗の理由を理解するには、モデルがプロンプトを処理する2つの段階を区別する必要があります。読み込み(prefill)はプロンプト全体を一括で処理する段階、書き込み(decode)は回答をトークン単位で生成する段階です。Everett氏が実験でこの2つの段階を分離したのもそのためです 2。ところが驚くべきことに、専門家を16個以下に削減した際に崩壊したのは書き込みではなく、読み込み段階でした。書き込みは枝刈りに耐えましたが、読み込みは耐えられないほど表現能力が崩壊しました 2。
ここから核心的な教訓が得られます。MoEにおいて、頻繁に使われることと重要であることは同等ではありません。Everett氏は仮説を立てました。特定のトークンで一度だけ起動する場合でも、その専門家が全体の表現に対して不均衡に大きな影響を与えるケースがあるかもしれないという判断です 2。彼が参考にした解釈可能性(Interpretability)研究の傾向によれば、境界トークン、すなわちモデルが回答を準備する地点において重要な決定が行われると報告されています 2。ほとんど使われない専門家がまさにその地点で一度発火し、状況を激変させるのであれば、頻度は重要度を全く反映していません。最終的に彼は、頻度ではなく正確さを維持することに貢献度の大きい専門家を選ぶ方式に切り替えました。
ブロック境界で「修復」する方法
残す専門家を決定したとしても、削除した箇所に生じた穴を埋めなければなりません。Everett氏はこの過程を「healing(修復)」と呼びました。燃え広がる火を消すように、損傷した内部表現を鎮静化させ、元の状態に戻すという意味合いから、この記事ではこの段階を「消火器」に例えます。
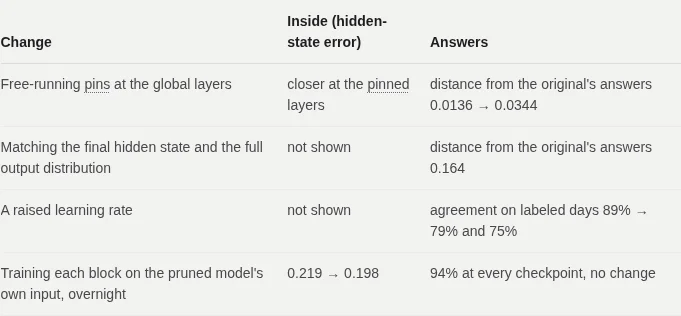
枝刈りの過程で、彼は興味深い現象を観測しました。スライディング・ウィンドウ・レイヤーを通過する際に増大していたエラーが、ブロック末尾のグローバル・アテンション・レイヤーを通過すると減少したのです 2。グローバル・アテンション・レイヤーは全体のコンテキストを見るため、過去の損傷を修復しているように見えました。ただし、Everett氏自身は「この説明が正しいと断定するのではなく、もっともらしい理由を付加している段階だ」と留保を述べています 2。いずれにせよ、彼はグローバル・アテンション・レイヤーの出力値を元モデルに可能な限り合わせることで、内部がどのように再配置されていても、ブロック境界において状態を復元できると考えました。
彼が使用したツールは「pinning(固定)」です。モデルの最終出力で正解だけを合わせるのでなく、ブロック末尾の中間表現(hidden state)を元モデルの表現に直接適合させて学習させる手法です 2。彼はこの違いを一文中にまとめました。「正解を合わせるのでなく、同じ思考をさせること」という説明です 3。これがブロック単位学習(block-local training)の本質です。実際の最初の修復実行では、未学習プロンプトを基準にしたエラーが0.69から0.42へと、約40%減少しました 2。ただし、Everett氏は「元モデルと完全に一致したわけではなかった」と述べ、半分ほど回復した状態であると率直に記録しています。
一つのタスクは得意だが、他の能力は失われる
この過程が生み出した結果と限界を、分離して捉える必要があります。分類タスクにおいて、圧縮モデルは元モデル26Bとの一致率が92%でした。参考までに、同じ項目において12Bモデルが26Bと一致する割合は90%であるため、3.81Bの圧縮モデルが同レベル以上の一貫性を示したと言えます 32。Everett氏が当初目標とした98%には未達でしたが 2。同パラメータ規模のGemma 4 E2B(約5B)よりも、そのサイズにおいて優れていたと彼は報告しています 2。
初期のスワップ増加によりSSDを懸念していた問題が、この実験の実質的な動機でした 2。
しかし、失われた点も明確です。Everett氏は、このモデルが汎用タスク用ではなく、知識を要するタスクでは著しく低下すると断言しています。知識が枝刈りされたためだという説明です 3。ブロック単位学習により、回答だけでなく思考プロセスを合わせようとしましたが、元モデルと完全に同一にはなりませんでした 32。彼が提案する手法の効率性も、まだ検証中です。ユーザーデバイスにおいて自分のデータで約5GBのメモリで学習できると考えていますが、「実際のユーザーデバイスではまだ試験していない」と明示しています 3。この実験も、自らを研究ではなくエンジニアリングのサイドプロジェクトと規定しています 2。
頻度ではなく、影響が専門家を選ぶ
結局、この実験が答える問いは一つです。MoEの重みの85%を削減しても、一つのタスクをこなせるかという問いに対し、答えは「一つのタスクなら可能だが、残すべきものを選ぶ基準が成否を分ける」というものです。128個から8個を選ぶ際、最も頻繁に使用されるものを残すという直感的な手法は、読み込み段階でモデルを完全に崩壊させました 2。正解を維持することに実際に貢献する専門家を選んだ後に限り、ブロック境界を元モデルに合わせて修復する道が開かれました 2。その結果、ある分類タスクにおいて一致率92%を達成しつつ、メモリは半減、速度は2倍となりましたが 3、汎用的な知識は同時に枝刈りされました 3。
読者に残る実用的な結論は二点に集約されます。第一に、MoEの軽量化において、ルーターが選択するアクティブパラメータ数とモデル全体サイズのギャップを縮めるには、ルーターを固定し、専門家を選択する基準を使用頻度から影響度へ変換する必要があります。第二に、こうした「消火器」モデルは、あくまで元モデルの特定の表現を小型密接モデルに移植する試みであり、あらゆるタスクを得意とする万能な小型化ではありません。「頻繁に使うものを残す」という前提を一度手放す瞬間が、むしろ小さなデバイスに大きなモデルの特定機能を生かして組み込む出発点となります。