El desarrollador Everett, que integró un modelo MoE de 26B en una aplicación de clasificación local que debe funcionar durante las 24 horas, se encontró con un obstáculo inesperado. El modelo en sí era lo suficientemente inteligente, pero el uso de memoria residente aumentó el consumo de swap del portátil, poniendo en peligro la vida útil de la unidad SSD. Al intentar mantener un modelo grande durante mucho tiempo en un dispositivo pequeño, el almacenamiento simplemente no resistió. El problema residía en la necesidad de un modelo que destacara en una única tarea.
Everett, autor de la aplicación Tolby, encontró la respuesta en la 'poda (pruning)'. Su método consistió en eliminar una parte significativa de los expertos (expert), que son los componentes internos del modelo que realmente calculan valores, y reajustar las partes restantes para crear un único modelo denso (dense). Según su informe, este enfoque combinado de poda, curación (healing) y fijación (pinning) logró una concordancia del 92% con el original en una tarea de clasificación, mejorando a la mitad el uso de memoria y duplicando la velocidad en comparación con un modelo de 12B. Sin embargo, el punto más importante que debe considerarse en este artículo no es el resultado, sino el proceso. El núcleo de este experimento reside en explicar por qué fracasó por completo la intuición obvia de que bastaría con conservar los expertos más utilizados, y bajo qué criterios deben seleccionarse.
El modelo MoE es más pesado que los componentes que utiliza para calcular
Para comprender este experimento, es necesario examinar primero la arquitectura de Gemma 4 26B-A4B. Según la página oficial de modelos de Ollama, se trata de un modelo MoE que posee 25,2B parámetros en total, pero que solo utiliza 3,8B en los cálculos reales. La estructura de un modelo MoE (Mixture of Experts o modelo de mezcla de expertos) divide los pesos del modelo en múltiples expertos, y un selector denominado router (encaminador) despierta solo 8 de los 128 expertos para que realicen el cálculo en cada token 1.
En este punto, la intuición y la realidad se contradicen. Si solo se utilizan 8 expertos a la vez, ¿por qué es necesario almacenar los 25,2B completos? La razón es que, como el router cambia de experto en cada token, todo el modelo debe permanecer activo en la memoria para poder activar cualquier experto en cualquier momento 2. Es decir, el MoE es una arquitectura que, a cambio de reducir la cantidad de cálculos, separa el consumo de memoria de la cantidad de cómputo. El problema de Everett surgió precisamente de esta separación entre cálculo y memoria. Aunque los cálculos eran ligeros, el dispositivo pequeño no podía respirar debido a la carga de tener que cargar el modelo completo.
Por lo tanto, pensó a la inversa. ¿Qué pasaría si los 8 expertos elegidos por el router se fijaran permanentemente en esos 8? Si solo se conservan 8 expertos, el selector solo tendría 8 candidatos posibles, por lo que el router desaparece prácticamente. Es el momento en que los componentes utilizados para el cálculo coinciden con el tamaño del modelo, es decir, cuando el MoE se convierte en un modelo denso 3. El resultado final fue un modelo denso de 3,81B parámetros. El único problema restante era: ¿qué 8 expertos conservar?
El colapso de la intuición de "conservar lo que más se usa"
El criterio que viene primero a la mente suele ser la frecuencia de uso. En la visualización del uso de expertos que Everett encontró, durante la fase de generación (decode) la mayoría de los expertos apenas se activaban, revelando una distribución de cola en la que solo unos pocos brillaban intensamente 2. La suposición de que bastaría con conservar los más frecuentes y descartar el resto parecía extremadamente razonable. Probó una 'poda basada en popularidad', seleccionando únicamente los expertos más altos. El resultado fue un colapso total. Aunque modelos como Claude le advirtieron que fracasaría, él atribuyó la falla simplemente a una elección errónea y volvió a intentarlo 2.
Para entender por qué fracasó, es preciso distinguir las dos fases con las que el modelo trata el prompt: prefill (lectura) y decode (escritura). El prefill es la fase que procesa todo el prompt de una sola vez, mientras que el decode es la fase que genera la respuesta token por token. La razón por la que Everett separó estas dos fases en su experimento es precisamente esta 2. Sin embargo, sorprendentemente, cuando el número de expertos se redujo a 16 o menos, la fase que se derrumbó no fue la escritura (decode), sino la lectura (prefill). La escritura resistió la poda, pero la lectura vio su representación colapsar hasta un punto insoportable 2.
De aquí surge la lección clave. En los modelos MoE, lo que se usa frecuentemente no es lo mismo que lo que es importante. Everett formuló una hipótesis: incluso si un experto se activa apenas una vez para un token específico, ese experto puede tener un impacto desproporcionadamente grande en la representación completa 2. Según las tendencias en las investigaciones de interpretabilidad que él consultó, se reporta que las decisiones importantes ocurren en los tokens de límite (boundary tokens), es decir, en los puntos donde el modelo se prepara para generar la respuesta 2. Si un experto casi nunca usado se activa una sola vez en ese punto y cambia por completo el resultado, la frecuencia de uso no refleja en absoluto su importancia. Finalmente, Everett abandonó el criterio de frecuencia y pasó a seleccionar los expertos según su contribución real a la preservación de la precisión.
La forma de "curar" en los límites de los bloques
Aunque se determinen qué expertos conservar, es necesario cubrir los huecos dejados por los expertos eliminados. Everett denominó a este proceso 'healing' (curación). En este artículo se compara esta fase con un 'extintor', dado que su propósito es apagar como un incendio propagado las representaciones internas dañadas, calmándolas para devolverlas a su estado original.
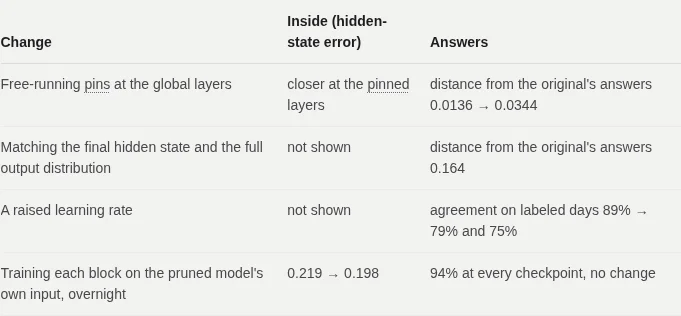
Durante la poda, observó un fenómeno interesante: los errores que aumentaban al pasar por las capas de ventana deslizante (sliding window layers) disminuían al atravesar las capas de atención global (global attention) situadas al final de los bloques 2. Puesto que las capas de atención global tienen visión completa del contexto, parecía que reparaban los daños previos. No obstante, el propio Everett añadió una nota de precaución, indicando que "más que afirmar que esta explicación es correcta, está buscando una justificación plausible" 2. De todos modos, concluyó que, ajustando al máximo la salida de las capas de atención global al modelo original, era posible restaurar el estado en los límites de los bloques, independientemente de cómo se reorganizaran las representaciones internas.
La herramienta que utilizó se denomina pinning (fijación). Consiste en entrenar para que las representaciones intermedias (hidden state) al final de cada bloque se ajusten directamente a las del modelo original, en lugar de limitarse a acertar la respuesta final al final del modelo 2. Él resumió esta diferencia en una sola frase: "no se trata de acertar la respuesta, sino de hacer que piense igual" 3. Esto es la esencia del entrenamiento local por bloques (block-local training). En efecto, en la primera ejecución de curación, el error en prompts no entrenados redujo de 0,69 a 0,42, una disminución aproximada del 40% 2. Sin embargo, Everett registró con honestidad que el estado había recuperado "solo la mitad", ya que "no alcanzaba una coincidencia perfecta con el original".
Hace bien una cosa, pero pierde otras
Es preciso separar los resultados y las limitaciones derivados de este proceso. En la tarea de clasificación, el modelo comprimido coincidió con el modelo original de 26B en un 92%. Cabe señalar que, en el mismo apartado, la tasa de concordancia entre el modelo de 12B y el de 26B es del 90%; por tanto, el modelo comprimido de 3,81B demostró una consistencia igual o superior 32. Eso sí, sin alcanzar el 98% que Everett se había fijado como objetivo original 2. Él reporta que, en esa escala de tamaño, superó a Gemma 4 E2B (aproximadamente 5B), que pertenece a la misma categoría de parámetros 2.
La preocupación inicial por la vida útil de la SSD debido al aumento del uso de swap fue el motor real de este experimento 2.
No obstante, las pérdidas son evidentes. Everett subraya que este modelo no es apto para tareas generales y que su rendimiento se degrada notablemente en tareas que requieren conocimiento. La explicación es que el conocimiento ha sido podado 3. Aunque el entrenamiento por bloques ajustó el proceso de razonamiento en lugar de la respuesta, el modelo no llegó a ser idéntico al original 32. La eficiencia del método que propone también está aún en proceso de verificación. Considera que es posible entrenarlo con los propios datos del usuario utilizando aproximadamente 5GB de memoria en el dispositivo del usuario, pero especifica claramente que "aún no se ha probado en dispositivos de usuarios reales" 3. Este experimento se define a sí mismo no como una investigación, sino como un proyecto secundario de ingeniería 2.
Son la influencia, no la frecuencia, los que seleccionan a los expertos
En definitiva, la pregunta a la que este experimento responde es única. Ante el interrogante de si es posible realizar una tarea aunque se elimine el 85% de los pesos de un MoE, la respuesta es: "sí, es posible realizar una tarea, pero el criterio para elegir qué conservar determina el éxito o el fracaso". El método intuitivo de conservar lo más frecuentemente usado al elegir 8 de entre 128 expertos colapsó por completo el modelo en la fase de lectura (prefill) 2. Solo tras seleccionar los expertos que contribuyen realmente a preservar la precisión correcta, se abrió la vía de curar los límites de los bloques ajustándolos al original 2. Como resultado, se obtuvo una concordancia del 92% en una clasificación, con la mitad de memoria y el doble de velocidad 3, pero el conocimiento general también fue eliminado junto con el resto 3.
Las conclusiones prácticas que quedan para el lector se reducen a dos. Primero, en la ligereza de los modelos MoE, si se desea reducir la brecha entre el número de parámetros activos que elige el router y el tamaño total del modelo, es preciso fijar el router y cambiar el criterio de selección de expertos de la frecuencia de uso a la influencia. Segundo, estos modelos tipo extintor constituyen, en todo caso, un intento de trasplantar representaciones específicas del original a un modelo denso pequeño; no son una miniaturización universal capaz de hacerlo todo bien. El momento en que se deja de lado la premisa de 'conservar lo más usado' es, paradójicamente, el punto de partida para integrar una función clave de un modelo grande en un dispositivo pequeño.