26B MoE 모델을 24시간 돌아야 하는 로컬 분류 앱에 붙여 넣은 개발자 Everett은 예상치 못한 곳에서 막혔습니다. 모델 자체는 충분히 똑똑했는데, 상주하는 메모리 때문에 노트북의 스왑 사용량이 늘어나 SSD 수명을 위협한 것입니다. 큰 모델을 작은 기기에 오래 올려두려니 저장장치가 버티지 못한 셈입니다. 문제는 딱 하나만 잘하는 모델이 필요하다는 점이었습니다.
Tolby 앱의 저자 Everett은 답을 '가지치기(pruning)'에서 찾았습니다. 모델 내부에서 실제로 값을 계산하는 부품인 전문가(expert)를 크게 덜어내고 남은 부분을 다시 맞춰, 하나의 밀집(dense) 모델을 만드는 방식입니다. 그의 보고에 따르면, 이 가지치기·치유·핀닝을 결합한 방식은 한 가지 분류 작업에서 원본과 92% 일치하면서 12B 모델 대비 메모리를 절반, 속도는 두 배로 개선했습니다. 다만 이 글에서 확인해야 할 더 중요한 지점은 결과가 아니라 과정입니다. 가장 많이 쓰이는 전문가만 남기면 된다는 당연한 직관이 왜 완전히 실패했는지, 그리고 어떤 기준으로 남기면 되는지가 이 실험의 핵심입니다.
MoE는 계산에 쓰는 부품보다 무거운 모델
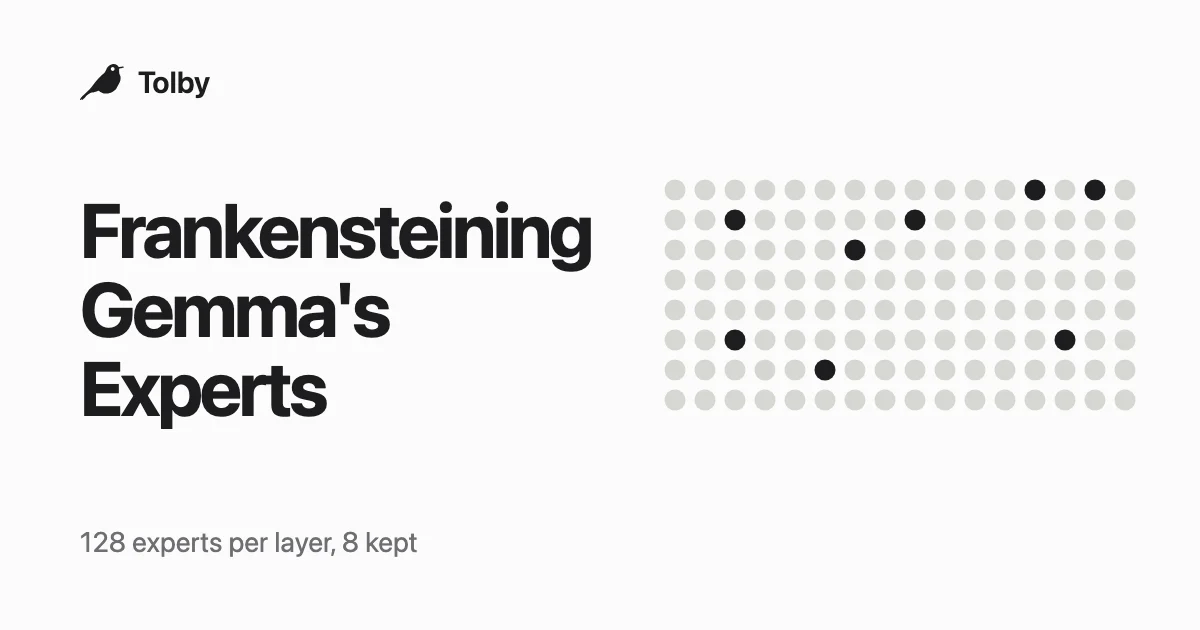
이 실험을 이해하려면 먼저 Gemma 4 26B-A4B가 어떤 구조인지 봐야 합니다. Ollama 공식 모델 페이지에 따르면 이 모델은 총 25.2B 파라미터를 가지지만, 실제 계산에는 3.8B만 쓰는 MoE 모델입니다. MoE(Mixture of Experts, 혼합 전문가 모델)는 모델의 가중치를 여러 전문가로 쪼개 두고, 토큰마다 라우터(router)라는 선택기가 128개 중 8개만 깨워 계산하게 하는 구조입니다 1.
여기서 직관과 실제가 엇갈립니다. 한 번에 8개만 쓰는데 왜 25.2B를 전부 저장해야 할까요. 라우터가 토큰마다 전문가를 갈아치우기 때문에, 모델 전체가 메모리에 살아 있어야 어느 순간에도 깨울 수 있기 때문입니다 2. 즉 MoE는 계산량을 줄이는 대신, 메모리 사용량을 계산량과 분리해 놓은 구조입니다. Everett의 문제는 정확히 이 계산과 메모리의 분리 때문에 생겼습니다. 계산은 가벼워도, 통째로 올려두는 용량 탓에 작은 기기가 숨을 쉬지 못한 것입니다.
그래서 그는 반대로 생각했습니다. 라우터가 고르는 8개를 아예 8개로 고정해 버리면 어떨까요. 전문가를 8개만 남기면 선택기가 고를 대상도 8개뿐이므로 라우터는 사실상 사라집니다. 계산에 쓰는 부품과 모델의 크기가 일치하게 되는, 즉 MoE가 밀집 모델로 바뀌는 순간입니다 3. 최종 결과물은 3.81B 파라미터의 밀집 모델이 되었습니다. 문제는 단 하나, 어떤 8개를 남기느냐였습니다.
'자주 쓰는 것을 남긴다'는 직관의 붕괴
가장 먼저 떠오르는 기준은 사용 빈도였습니다. Everett이 찾은 전문가 사용 시각화 자료를 보면, 답을 생성(decode)하는 단계에서 대부분 전문가는 거의 깨지 않고 소수만 번쩍이는 꼬리 분포가 드러났습니다 2. 자주 쓰이는 것만 남기고 나머지를 버리면 되겠다는 추측은 지극히 합리적으로 보였습니다. 그는 상위 전문가만 고르는 '인기도 기반 가지치기'를 시도했습니다. 결과는 완전히 붕괴였습니다. Claude 같은 모델이 실패할 것이라 경고했지만, 그는 그냥 선택을 잘못했거니 여기고 다시 시도했습니다 2.
왜 실패했는지를 이해하려면 모델이 프롬프트를 다루는 두 단계를 구분해야 합니다. 읽기(prefill)는 프롬프트 전체를 한꺼번에 처리하는 단계, 쓰기(decode)는 답을 토큰씩 만들어 내는 단계입니다. Everett이 실험에서 이 두 단계를 분리한 이유도 여기에 있습니다 2. 그런데 놀랍게도 전문가를 16개 이하로 줄였을 때 무너진 쪽은 쓸기가 아니라 읽기였습니다. 쓰기는 가지치기를 견뎠지만, 읽기는 버틸 수 없을 정도로 표현이 무너졌습니다 2.
여기서 핵심 교훈이 나옵니다. MoE에서 자주 쓰이는 것과 중요한 것은 같지 않습니다. Everett은 가설을 세웠습니다. 특정 토큰 딱 한 번만 깨지더라도, 그 전문가가 표현 전체에 불균형적으로 큰 영향을 주는 경우가 있을 것이라는 판단입니다 2. 그가 참고한 해석가능성 연구 경향에 따르면, 경계 토큰, 즉 모델이 답을 준비하는 지점에서 중요한 결정이 일어나는 것으로 보고됩니다 2. 거의 안 쓰이는 전문가가 바로 그 지점에서 한 번 발화하며 판을 바꾼다면, 빈도는 중요도를 전혀 반영하지 못합니다. 결국 그는 빈도가 아니라 정확도를 지키는 데 공헌도가 큰 전문가를 고르는 방식으로 갈아탔습니다.
블록 경계에서 '치유'하는 방법
남길 전문가를 정했다 해도, 잘라낸 자리에서 난 구멍은 메워야 합니다. Everett은 이 과정을 'healing(치유)'이라 불렀습니다. 마치 번지는 불을 끄듯 손상된 내부 표현을 진정시켜 원본 상태로 되돌린다는 뜻에서, 이 글은 이 단계를 '소화기'라 비유합니다.
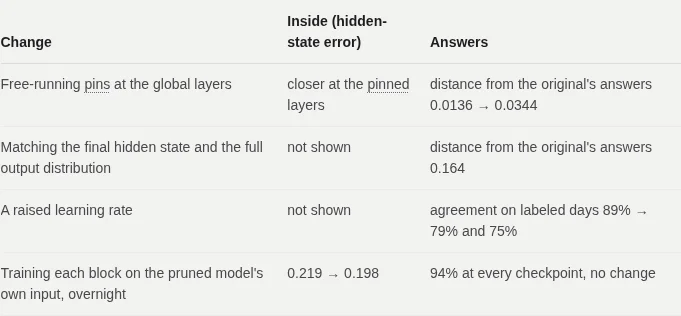
가지치기 도중 그는 흥미로운 현상을 보았습니다. 슬라이딩 윈도우 층을 지나며 커지던 오류가, 블록 끝의 전역 주의 층을 지나며 줄어든 것입니다 2. 전역 주의층이 전체 문맥을 보기 때문에 앞의 손상을 수습하는 것처럼 보였습니다. 다만 Everett 자신은 "이 설명이 맞다고 단정하기보다 그럴듯한 이유를 붙이는 중"이라고 단서를 달아 두었습니다 2. 어쨌든 그는 전역 주의 층의 출력값을 원본 모델에 최대한 맞추면, 내부가 제아무리 재배치되어도 블록 경계에서 상태를 복원할 수 있다고 봤습니다.
그가 쓴 도구가 핀닝(pinning)입니다. 모델 끝에서 정답만 맞히는 대신, 블록 끝의 중간 표현(hidden state)을 원본의 표현에 직접 맞춰 학습시키는 방법입니다 2. 그는 이 차이를 한 문장으로 정리했습니다. "정답을 맞추는 게 아니라, 같은 생각을 하게 만드는 것"이라는 설명입니다 3. 이것이 블록 단위 훈련(block-local training)의 본질입니다. 실제로 첫 치유 실행에서 무학습 프롬프트 기준 오류가 0.69에서 0.42로, 약 40% 줄었습니다 2. 다만 Everett은 "원본과 완벽하게 일치하지는 않았다"며 절반쯤 회복된 상태라고 정직하게 기록했습니다.
한 가지 일은 잘하고, 나머지는 잃는다
이 과정이 만들어 낸 결과와 한계를 분리해서 봐야 합니다. 분류 작업에서 압축 모델은 원본 26B와 92% 일치했습니다. 참고로 같은 항목에서 12B 모델이 26B와 일치하는 비율이 90%이므로, 3.81B짜리 압축 모델이 동급 이상의 일관성을 보인 셈입니다 32. Everett이 원래 목표로 세운 98%에는 미달했지만 말입니다 2. 같은 파라미터급인 Gemma 4 E2B(약 5B)보다는 그 크기에서 우월했다고 그는 보고합니다 2.
초기 스왑 증가로 SSD를 걱정하던 문제가 이 실험의 실제 동력이었습니다 2.
그러나 잃은 것도 분명합니다. Everett은 이 모델이 범용 작업용이 아니며, 지식이 필요한 작업은 크게 저하된다고 못 박습니다. 지식이 잘려나갔기 때문이라는 설명입니다 3. 블록 단위 훈련으로 답이 아니라 사고 과정을 맞췄지만, 원본과 완전히 같아지진 않았습니다 32. 그가 제안하는 방법의 효율성도 아직 검증 중입니다. 사용자 기기에서 자기 데이터로 약 5GB 메모리로 훈련할 수 있다고 보지만, "실제 사용자 기기에서는 아직 시험하지 않았다"고 명시했습니다 3. 이 실험도 스스로를 연구가 아닌 엔지니어링 사이드 프로젝트로 규정합니다 2.
빈도가 아니라 영향이 전문가를 고른다
결국 이 실험이 답하는 질문은 하나입니다. MoE 가중치의 85%를 덜어내도 한 가지 일은 할 수 있느냐에 대해, 답은 "한 가지 일은 된다, 단 남길 것을 고르는 기준이 성패를 가른다"입니다. 128개 중 8개를 고를 때 가장 많이 쓰이는 것을 남기는 직관적인 방법은 읽기 단계에서 모델을 통째로 무너뜨렸고 2, 정답을 지키는 데 실제로 공헌하는 전문가를 고른 뒤에야 블록 경계를 원본에 맞춰 치유하는 경로가 열렸습니다 2. 그 결과 한 분류에서 92% 일치하면서 메모리는 절반, 속도는 두 배가 된 대신 3, 범용 지식은 함께 잘려나갔습니다 3.
독자에게 남는 실용적 결론은 두 가지로 좁혀집니다. 첫째, MoE 경량화에서 라우터가 고르는 활성 파라미터 수와 모델 전체 크기의 간극을 줄이려면, 라우터를 고정하고 전문가를 고르는 기준을 사용 빈도가 아닌 영향으로 바꿔야 합니다. 둘째, 이런 소화기 모델은 어디까지나 원본의 특정 표현을 소형 밀집 모델에 이식하는 시도이지, 모든 일을 잘하는 만능 소형화가 아닙니다. 자주 쓰는 것을 남긴다는 가정을 한 번 내려놓는 순간이, 오히려 작은 기기에 큰 모델의 한 기능을 살려 넣는 출발점이 됩니다.