AI 驱动的开发工作流中,成本与效率的平衡点在哪里?最近,在将大语言模型(LLM)作为辅助工具使用的工作流中,如何在减少 Token 浪费的同时保持性能备受关注。其核心在于通过 MCP(Model Context Protocol)对接 DeepSeek 模型。要点很简单:构建一种分工策略(HITL,Human-in-the-Loop),将规格明确的长任务委派给 DeepSeek,而由宿主客户端(如 Claude)直接处理关键判断和细微调整。
为什么通过 MCP 调用 DeepSeek 时会产生双重消耗
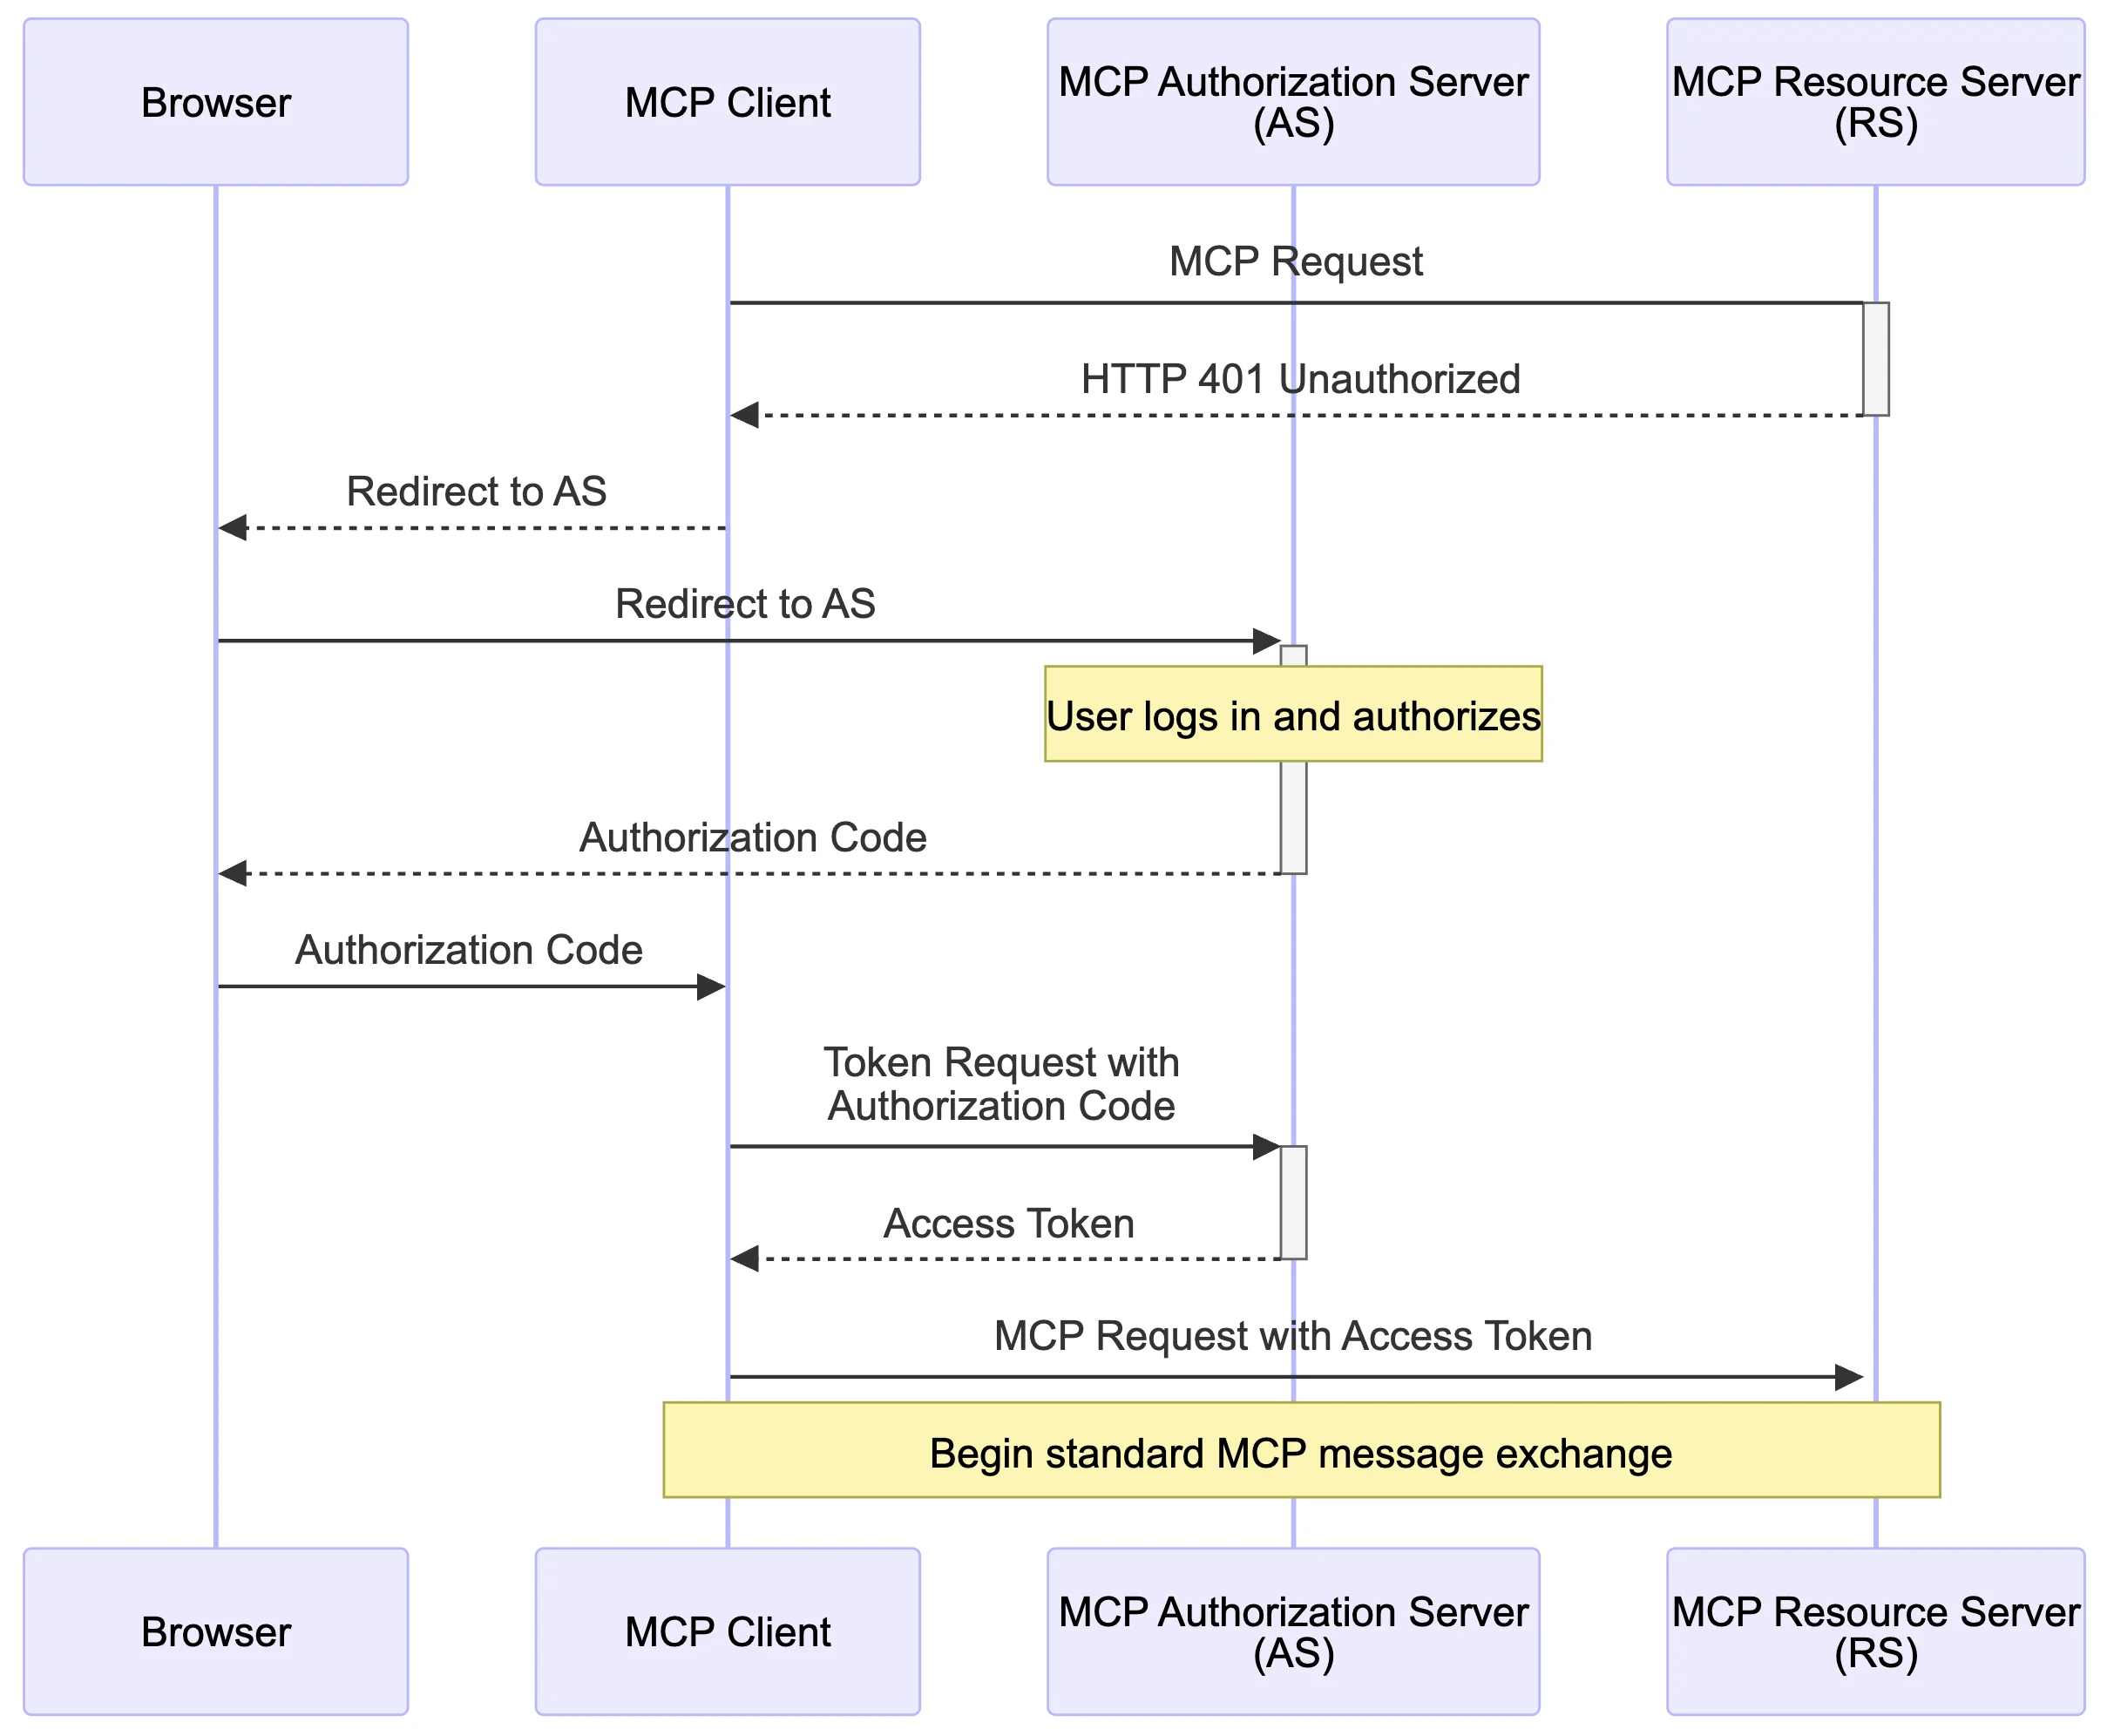
在将 AI Agent 与外部模型连接时,最常见的问题是“双重消耗”。当将 DeepSeek 模型(如 deepseek-flash)连接到 Claude 等宿主客户端时,如果仅将 MCP 服务器配置为调用 API 的窗口,DeepSeek 生成的长输出 Token 会再次作为宿主的输入 Token 传输,从而导致重复消耗 1。也就是说,即使 DeepSeek 完美地执行了长任务,一旦原样将其结果引入,就会浪费宿主的上下文窗口并产生不必要的成本。
为了防止这种 Token 浪费,MCP 服务器的设计需要进行优化:将 DeepSeek 生成的长结果“保存为文件”,或者仅返回宿主能够理解的最小化摘要及结果状态 1。在一个实际开发案例中,开发者明确指示 Claude “以节省 Token 的方式制作 MCP”,从而引导系统将 DeepSeek 的响应保存为文件或处理为优化格式。此外,还添加了一个可以监控 DeepSeek 的调用次数、Token 消耗量、余额等的模块,从而实现了资源的精准管理 1。
DeepSeek 的 1M 上下文窗口利用与成本结构
将长任务委派给 DeepSeek 具有优势的原因在于其强大的上下文处理能力和低廉的 Token 单价。DeepSeek V4.1 Flash 模型(deepseek-flash)提供了 1M(100 万)Token 的庞大上下文窗口 2, 3。这对于一次性处理数百页文档或非常长的会话极为有利。利用这一特性,可以将长上下文处理本身委派给 DeepSeek,并仅接收最终产出物(如保存为文件),从而从根本上阻止其对宿主客户端上下文的占用 2, 3。
在成本方面,这种分工的优势也显而易见。DeepSeek 的 deepseek-flash 模型在高峰时段的收费为:每 100 万输入 Token 0.30 美元,每 100 万输出 Token 1.20 美元(非高峰时段减半)2, 3。相比之下,Claude Opus 5.5 等最新高级模型的 Token 单价高达每 100 万输入 Token 4.00 美元,每 100 万输出 Token 20.00 美元 3。由于生成长文本或分析长文档的大规模生成任务中,输出 Token 的成本占比必然很大,因此形成了将该部分由单价低 10 倍的 DeepSeek 分担的结构。
分工策略:应交给 DeepSeek 的“长任务”
在利用 MCP 将 AI 引入为辅助工具时,需要明确哪些任务应委派给 DeepSeek。根据社区案例,规格明确的大规模生成任务最符合 DeepSeek 的特点 1。典型的例子包括样板代码、大量测试代码编写、简单的数据转换,以及需要长输出结果的代码生成等。将独立且可验证的任务分配给 DeepSeek,可以使 Claude 只专注于复杂的设计和规格编写,从而更有效地分配资源 1。
在一个将 2D HTML Canvas 树木动画转换为 3D(2.5D 蒙皮)的项目中,验证了该策略的成功案例。生成算法、打包、网格生成等规格明确的模块由 DeepSeek 实现,在总共 740 行代码中仅出现了 1 个错误,展现了近乎完美的生成质量 1。在此过程中,DeepSeek 虽然消耗了约 3.7 万 Token 完成长任务,但由于经过了上述 MCP 优化结构,并未占用宿主的上下文。
宿主(Claude)应直接处理的“重要判断”
不能将所有任务都抛给辅助模型。对于失败代价高或需要高度上下文理解力的判断,应由宿主客户端(Claude)直接负责。从某位开发者制定的分工策略来看,Claude 被设置为直接处理小规模代码修改及设计、多文件间的关系及隐藏规则把握,以及错误成本高的原因分析、安全、数据删除、计算等工作 1。此外,财务相关代码编写或涉及安全问题的部分也保留在宿主的判断领域 1。
特别是基于截图的视觉验证或细微调整,是宿主模型必须直接介入的领域。在前面提到的 3D 树木动画转换项目中,尽管 DeepSeek 出色地生成了基础代码,但针对实际形状、光线、明暗等的视觉细微调整需要进行基于截图的反复验证,因此由 Claude 直接进行了控制 1。此外,为了弥补被指出的 Claude 短板“搜索能力”,还引入了 DeepSeek 的网络搜索功能,并行采用了在需要时让 DeepSeek 使用搜索工具的混合策略 1。
DeepSeek MCP 服务器的组成部分与安全性
支持这些工作流的开源生态系统也在快速增长。代表性的项目 DMontgomery40/deepseek-mcp-server 是一个与 DeepSeek V4.1 Flash 和 V4 Pro API 对接的 MCP 服务器,向宿主客户端提供总共 11 种工具 2。该服务器包含多种功能工具,如用于简单聊天的 chat_completion、处理无状态 Responses API 调用的 create_response,以及用于账户状态检查的 get_user_balance 等 2。
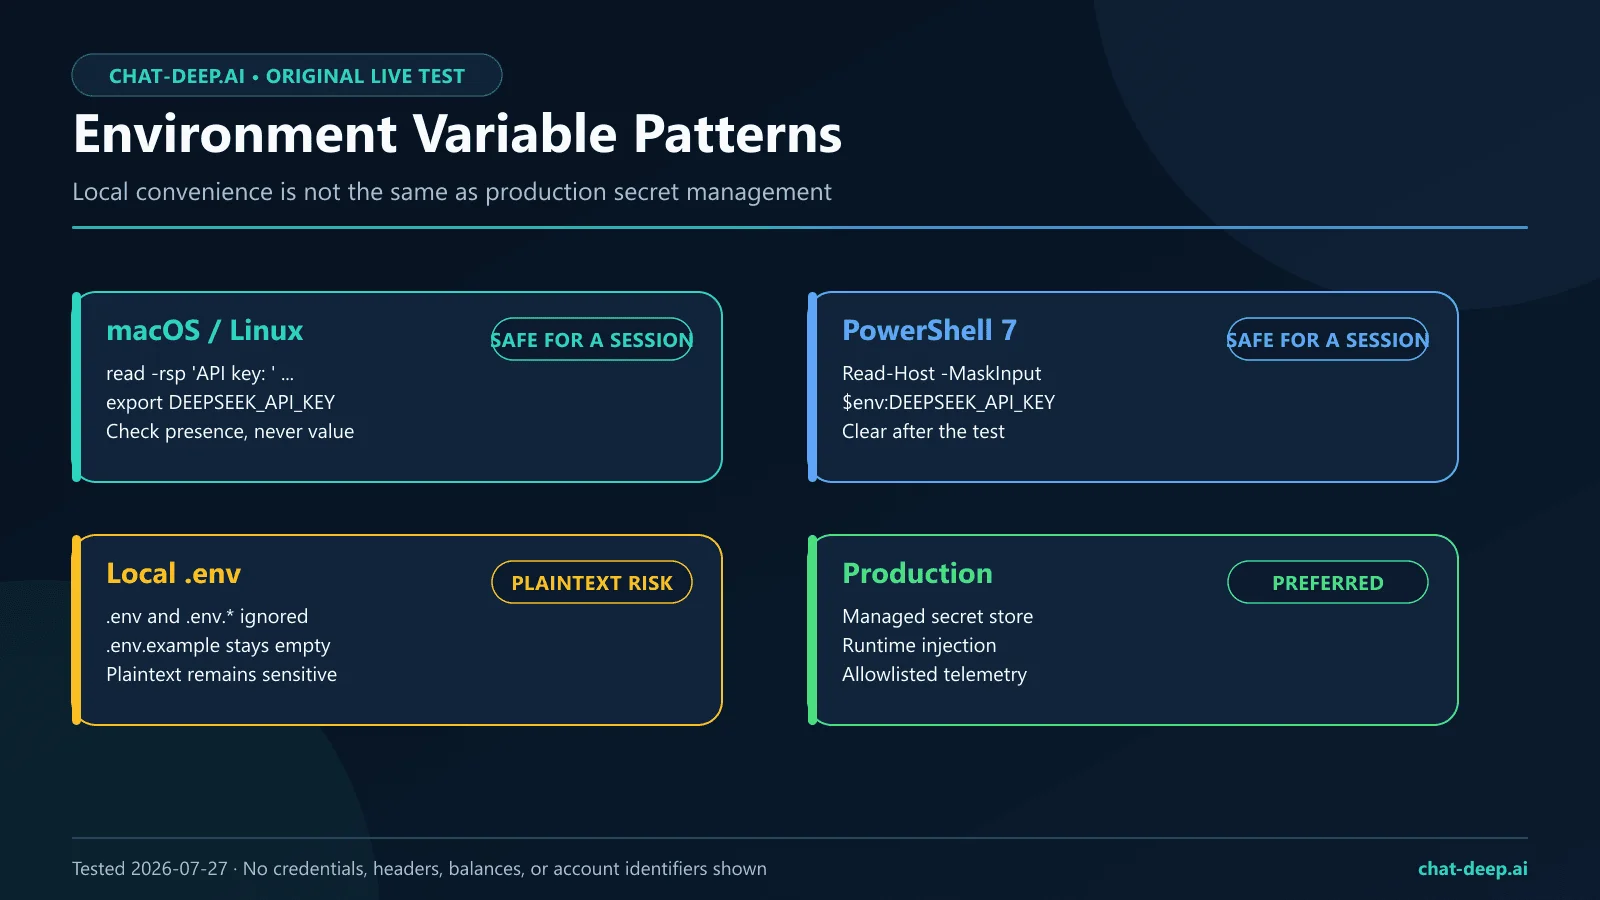
利用 MCP 服务器的文件管理工具(upload_file, list_files, retrieve_file, delete_file),可以将 DeepSeek 生成的庞大输出结果安全地存储和管理在宿主之外,这在防止双重消耗方面起着核心作用 2。在安全和管理方面,当以 HTTP 模式运行时,要求设置 MCP_HTTP_AUTH_TOKEN 以应用 Bearer Token 认证,并通过 MCP_HTTP_ALLOWED_ORIGINS 限制浏览器来源等基本安全装置 2。此外,deepseek-v4-flash 目前作为 deepseek-flash 的临时别名提供,且服务器的默认模型设置值指定为 deepseek-flash,对接时需注意这些点 2。
构建实用工作流的提示
最终,要想通过 DeepSeek MCP 对接将 Token 效率提升两倍以上,前提是要定义“让哪个模型做什么”的角色。DeepSeek 在推出 Search 和 Fetch API 时,除了模型 Token 费用外,还按每 1,000 次请求 0.75 美元收费,因此通过 MCP 服务器控制并优化这些外部 API 调用非常重要 2。
建议在实务应用中按以下顺序设计 MCP 架构。
- 第 1 步:设置结果旁路路径:在宿主客户端的提示词中,明确指示 MCP 服务器“将结果保存为文件或仅返回最小摘要” 1。
- 第 2 步:委派大规模生成:对于测试代码、样板代码等规格明确的 700 行以上的代码或文本转换任务,利用 DeepSeek 的 1M 上下文窗口和
deepseek_batch进行并行处理 1。 - 第 3 步:保护宿主资源:不将生成的文件直接加载到宿主的上下文中,而是仅向 Claude 传递“文件位置”或“执行结果的错误代码”等指标以请求判断 1。
- 第 4 步:人类/宿主介入(HITL):仅在需要进行基于截图的视觉验证或需要对安全及财务逻辑进行细微调整时,由宿主客户端或用户介入 1。
这种体系超越了单纯节省 API 单价的阶段。因为它防止了高价模型的上下文窗口因低价的大规模生成 Token 而不必要地膨胀,并构建了使最昂贵、最智能的资源仅用于“判断”的结构。
最终,AI 开发环境中的效率问题,不是选择一个好模型的问题,而是利用 MCP 等标准协议,精细地拆解“长任务的生成”和“重要判断”,将其分配给不同模型和工具的架构设计问题。一旦将 DeepSeek MCP 设计为独立的作业节点——“不单纯是替代 API,而是将结果旁路存储为文件从而释放宿主”,就能同时抓住 Token 成本和处理时间这两只兔子。
参考资料
- 클로드 코드에 딥시크MCP 붙였어 · gall.dcinside.com↩
- GitHub - DMontgomery40/deepseek-mcp-server: Model Context Protocol server for DeepSeek's advanced language models · github.com↩
- LLM API Pricing 2026: OpenAI, Gemini, Claude & Grok | IntuitionLabs · intuitionlabs.ai↩



