¿Dónde reside el equilibrio entre coste y eficiencia en los flujos de trabajo de desarrollo basados en IA? Recientemente, ha cobrado relevancia mantener el rendimiento mientras se reducen los derroches de tokens en los flujos de trabajo que utilizan modelos de lenguaje grandes (LLM) como herramientas de asistencia. En el centro de esta tendencia se encuentra la integración del modelo DeepSeek mediante el MCP (Model Context Protocol). La clave es sencilla: construir una estrategia de distribución de roles (HITL, Human-in-the-Loop) donde las tareas largas con especificaciones claras se delegan a DeepSeek, mientras que las decisiones cruciales y los ajustes finos los gestiona directamente el cliente anfitrión (como Claude).
Por qué se produce un doble consumo al llamar a DeepSeek mediante MCP
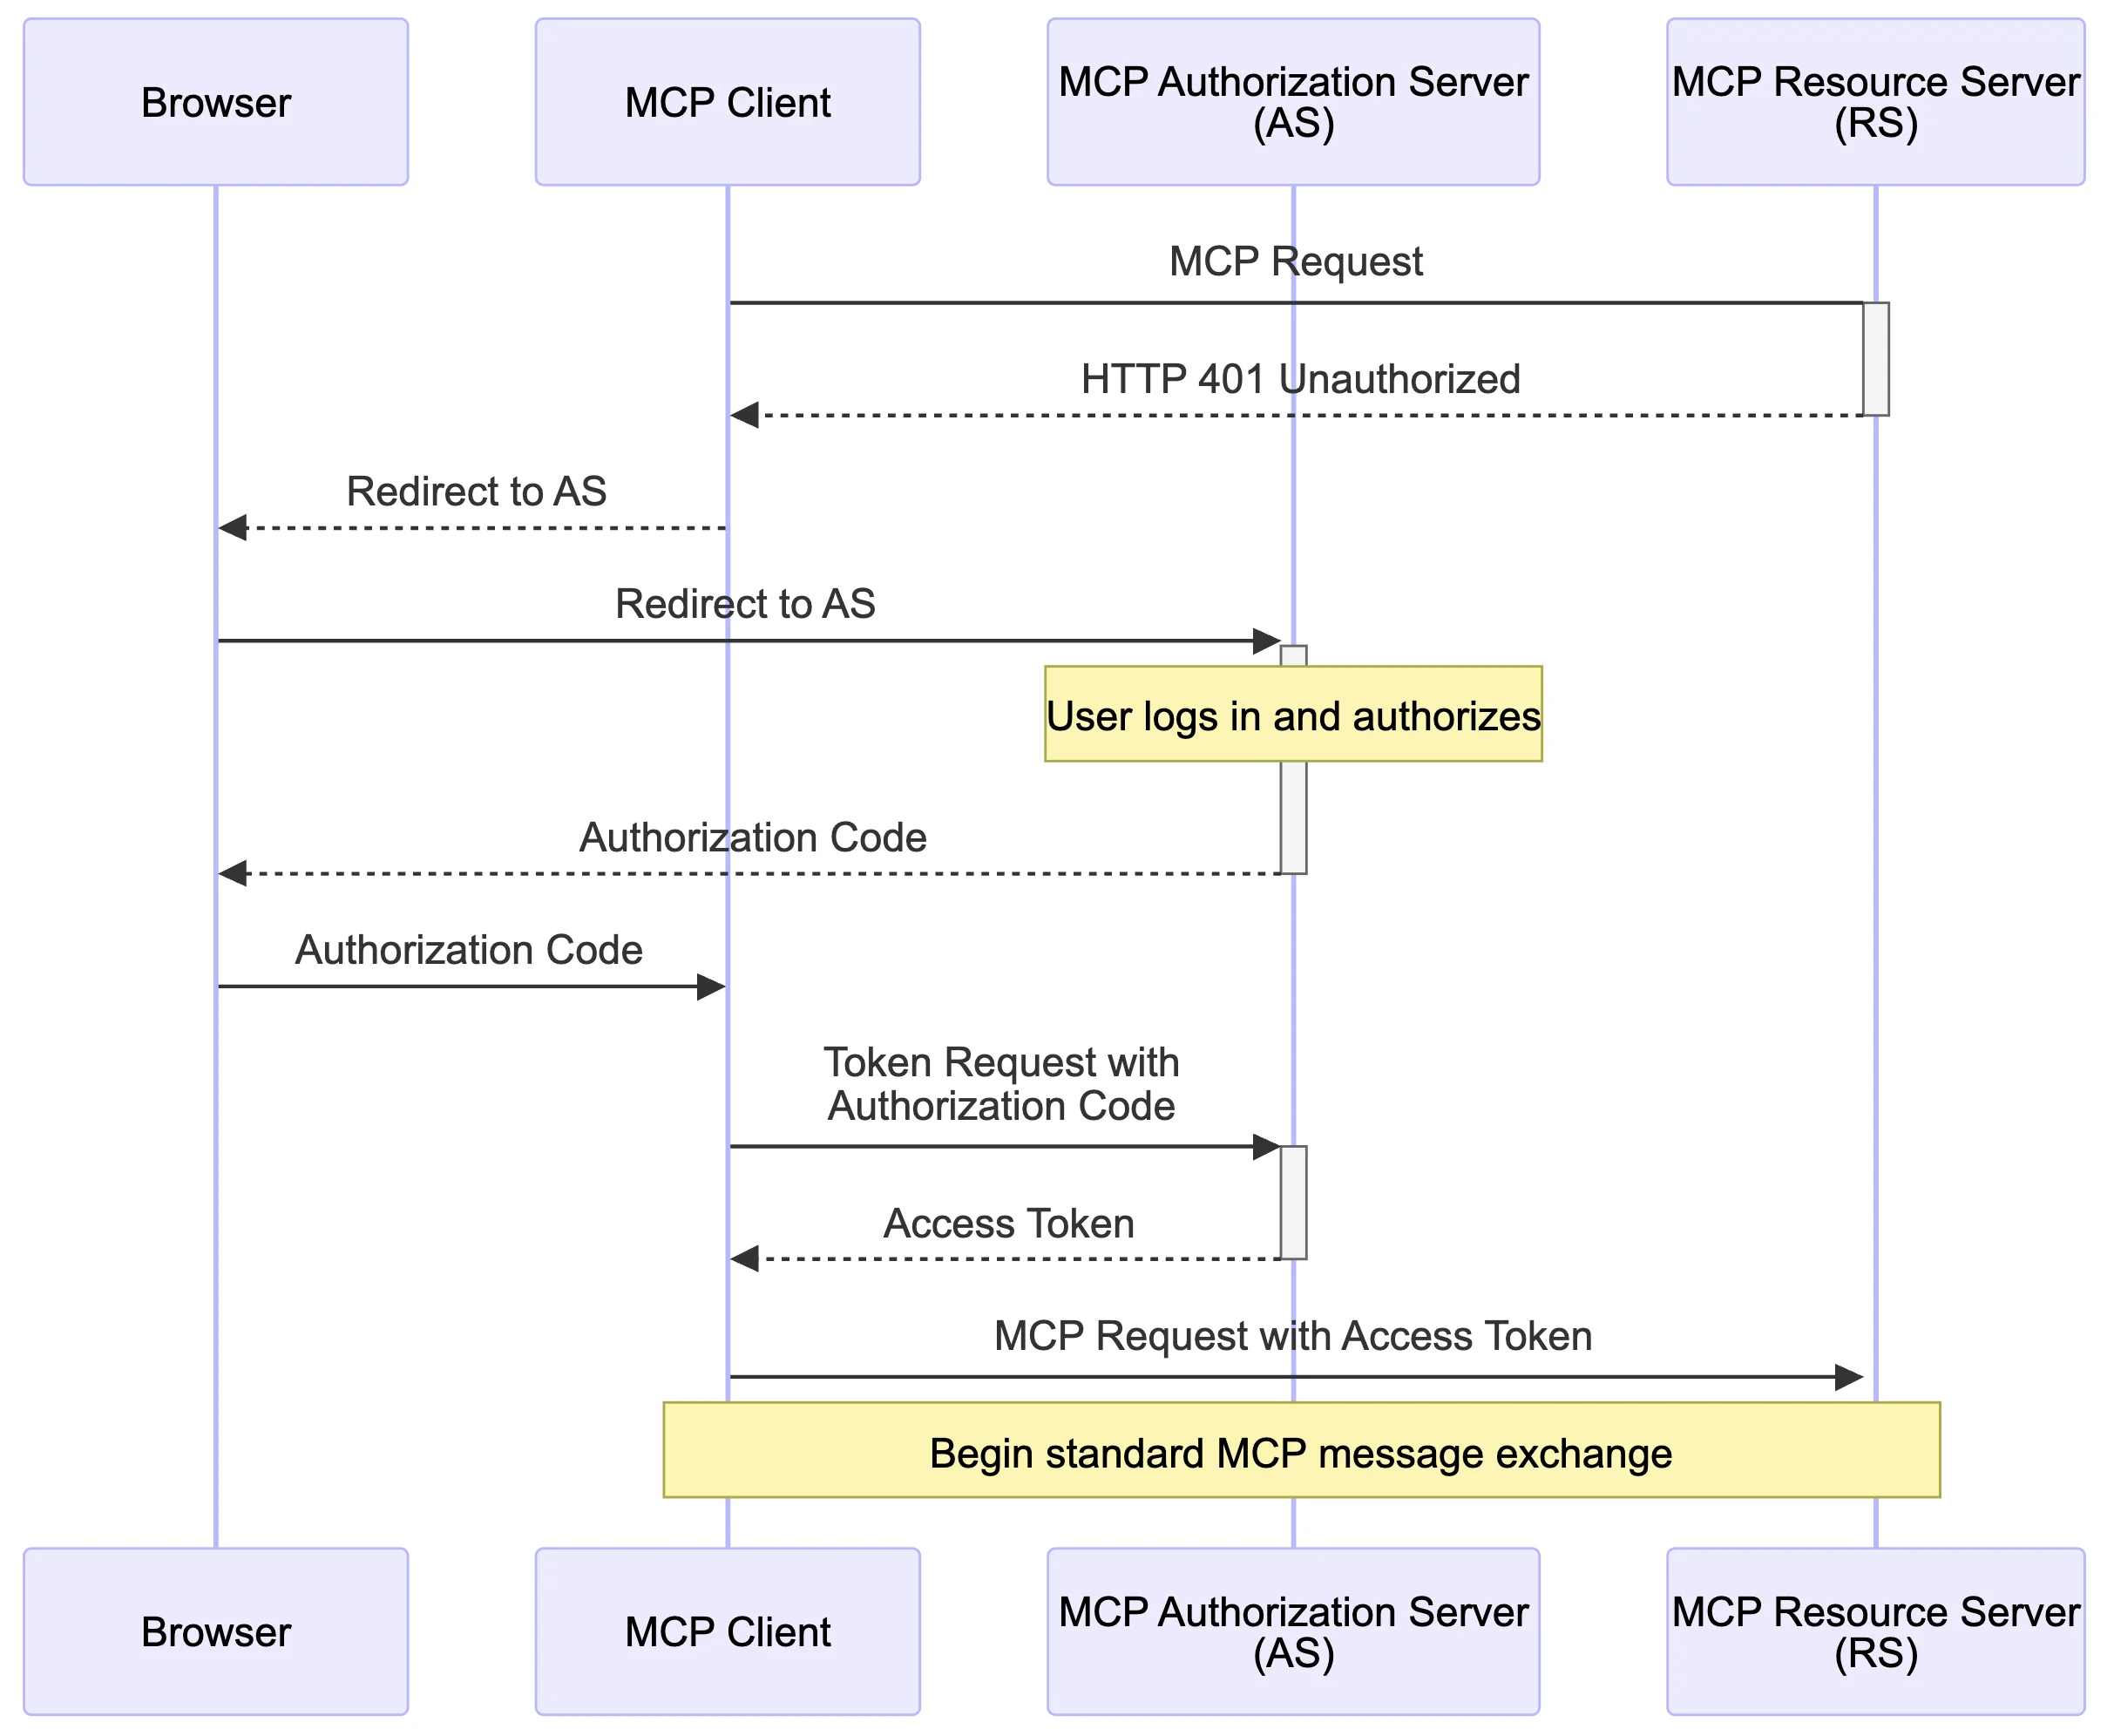
El problema más frecuente al conectar agentes de IA con modelos externos es el 'doble consumo'. Al conectar modelos DeepSeek (como deepseek-flash) a un cliente anfitrión como Claude, si el servidor MCP se configura simplemente como una ventanilla para llamar a la API, los largos tokens de salida generados por DeepSeek se reenvían como tokens de entrada al host, provocando un consumo duplicado 1. Es decir, aunque DeepSeek haya ejecutado perfectamente una tarea larga, el momento en que se traslada su resultado tal cual, se desperdicia la ventana de contexto del host y se incurre en costes innecesarios.
Para evitar este desperdicio de tokens, es necesario diseñar el servidor MCP de forma optimizada para que guarde los largos resultados generados por DeepSeek en 'archivos' o solo devuelva un resumen mínimo y el estado de los resultados que el host pueda entender 1. De hecho, en un caso práctico de desarrollo, se instruyó explícitamente a Claude para "desarrollar el MCP de manera que ahorre tokens", adoptando un enfoque que indujera a guardar las respuestas de DeepSeek en archivos o a procesarlas en formato optimizado. De esta forma, fue posible añadir incluso un módulo para monitorear las llamadas a DeepSeek, el consumo de tokens, el saldo, etc., permitiendo una gestión precisa de los recursos 1.
Uso de la ventana de contexto de 1M de DeepSeek y estructura de costes
Las razones para delegar tareas largas a DeepSeek radican en su potente capacidad de manejo de contexto y en el bajo precio unitario de sus tokens. El modelo DeepSeek V4.1 Flash (deepseek-flash) ofrece una amplia ventana de contexto de 1M (1 millón) de tokens 2, 3. Esto resulta muy ventajoso para procesar de una sola vez documentos de cientos de páginas o sesiones de conversación extremadamente largas. Aprovechando esta característica, se puede delegar a DeepSeek el manejo del contexto extenso y recibir únicamente los productos finales (como archivos guardados), impidiendo así que el cliente anfitrión vea ocupada su ventana de contexto 2, 3.
En el aspecto financiero, también se evidencian claramente las ventajas de esta distribución de roles. El modelo deepseek-flash de DeepSeek impone tarifas de 0,30 USD por millón de tokens de entrada y 1,20 USD por millón de tokens de salida en horas pico (la mitad en horas no punta) 2, 3. En contraste, los modelos premium recientes como Claude Opus 5.5 tienen precios de 4,00 USD por millón de tokens de entrada y 20,00 USD por millón de tokens de salida 3. Dado que las tareas de generación masiva, como crear textos extensos o analizar documentos largos, suponen un alto peso en costes de tokens de salida, resulta viable una estructura que delegue esta parte a DeepSeek, cuyo precio unitario es diez veces menor.
Estrategia de distribución de roles: las 'tareas largas' que deben delegarse a DeepSeek
Al implementar IA como herramienta de asistencia mediante MCP, se requieren criterios claros sobre qué tareas delegar a DeepSeek. Según casos comunitarios, las tareas de generación masiva con especificaciones claras se ajustan mejor a DeepSeek 1. Ejemplos representativos incluyen boilerplates, escritura masiva de código de pruebas, transformaciones simples de datos y generación de código que requiere resultados extensos. Si se asignan a DeepSeek tareas independientes y verificables, Claude puede concentrarse únicamente en el diseño complejo y la redacción de especificaciones, distribuyendo los recursos de forma mucho más eficiente 1.
En un proyecto real de conversión de una animación de árbol 2D en HTML Canvas a 3D (skinning 2.5D) se verificó el éxito de esta estrategia. Módulos con especificaciones claras, como algoritmos de generación, empaquetado y creación de mallas, fueron implementados por DeepSeek; de un total de 740 líneas de código, solo se produjo 1 error, mostrando una calidad de generación casi perfecta 1. En este proceso, DeepSeek consumió aproximadamente 37,000 tokens para completar la tarea larga, pero al pasar por la estructura optimizada de MCP mencionada anteriormente, no ocupa el contexto del host.
Las 'decisiones importantes' que el host (Claude) debe gestionar directamente
No se deben delegar todas las tareas a los modelos auxiliares. Las decisiones con alto costo de fallo o que requieren una comprensión profunda del contexto deben ser asumidas directamente por el cliente anfitrión (Claude). Al observar una estrategia de distribución de roles establecida por un desarrollador, se configuró para que Claude gestionara directamente pequeñas correcciones de código y diseño, la identificación de relaciones entre múltiples archivos y reglas ocultas, así como tareas con alto costo de error como análisis de causa raíz, seguridad, eliminación de datos y cálculos 1. Además, también se reservó para el juicio del host la redacción de código financiero o las partes involucradas en temas de seguridad 1.
En particular, la verificación visual basada en capturas de pantalla y los ajustes finos delicados son ámbitos en los que debe intervenir directamente el modelo host. En el proyecto antes mencionado de conversión de animación de árbol 3D, aunque DeepSeek generó magníficamente el código base, los ajustes visuales finos como la apariencia real, la luz y el contraste requirieron una validación repetitiva basada en capturas de pantalla, por lo que Claude los controló directamente 1. Asimismo, para compensar la 'capacidad de búsqueda', señalada como un punto débil de Claude, se incluyó la función de búsqueda web de DeepSeek, implementándose también una estrategia híbrida que permitía a DeepSeek utilizar herramientas de búsqueda cuando fuera necesario 1.
Componentes y seguridad del servidor DeepSeek MCP
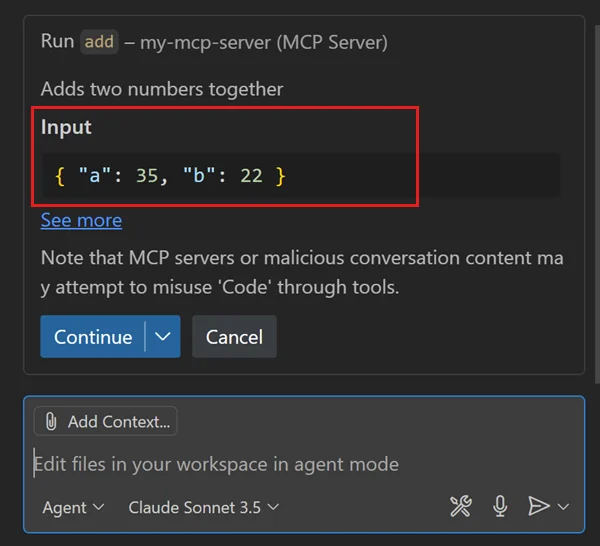
El ecosistema de código abierto que respalda este flujo de trabajo también está creciendo rápidamente. Por ejemplo, el proyecto DMontgomery40/deepseek-mcp-server es un servidor MCP que se integra con las API de DeepSeek V4.1 Flash y V4 Pro, proporcionando un total de 11 herramientas al cliente anfitrión 2. Este servidor incluye diversas herramientas funcionales como chat_completion para chats simples, create_response para gestionar llamadas sin estado a la API Responses, e get_user_balance para verificar el estado de la cuenta 2.
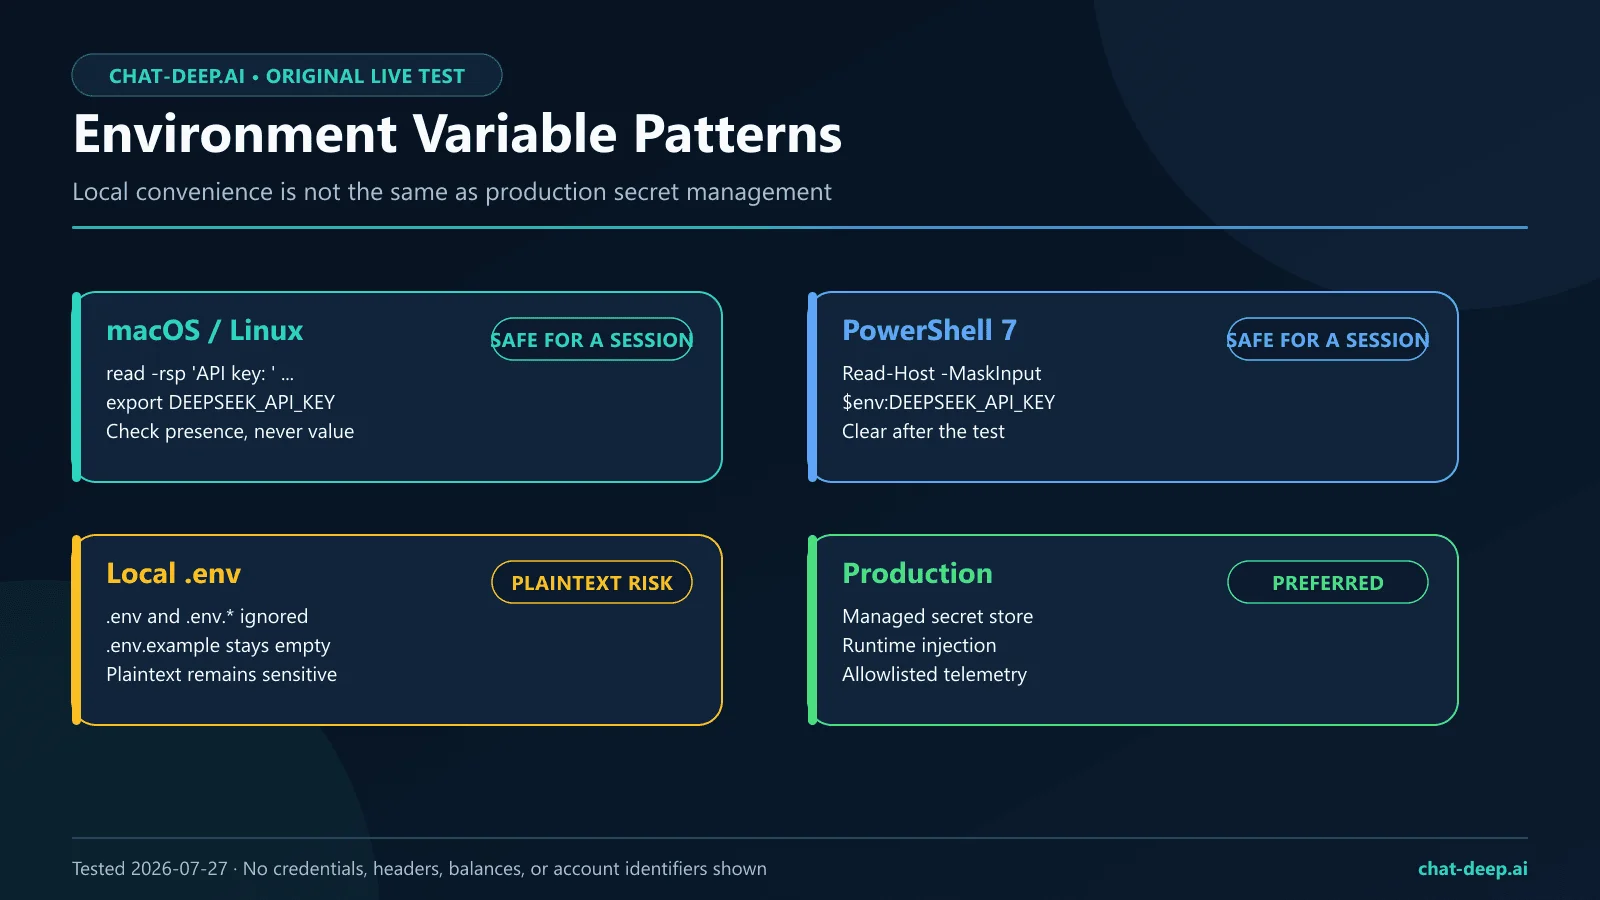
Al utilizar las herramientas de gestión de archivos del servidor MCP (upload_file, list_files, retrieve_file, delete_file), se puede guardar y gestionar de forma segura fuera del host los vastos resultados generados por DeepSeek, jugando un papel fundamental en la prevención del doble consumo 2. Por otro lado, en cuanto a seguridad y gestión, al ejecutarse en modo HTTP se requieren medidas de seguridad esenciales como configurar MCP_HTTP_AUTH_TOKEN para aplicar autenticación de token bearer y limitar el origen del navegador mediante MCP_HTTP_ALLOWED_ORIGINS 2. Además, deepseek-v4-flash se ofrece actualmente como alias temporal de deepseek-flash, y se debe tener en cuenta que el valor predeterminado del modelo en el servidor está configurado como deepseek-flash 2.
Consejos para establecer un flujo de trabajo práctico
En definitiva, para elevar la eficiencia de tokens más del doble mediante la integración de DeepSeek MCP, debe resolverse primero la definición de roles sobre 'qué modelo debe hacer qué'. DeepSeek ha lanzado las API Search y Fetch, cobrando 0,75 USD por cada 1.000 solicitudes, aparte de los costes de tokens del modelo, por lo que es crucial controlar y optimizar estas llamadas a APIs externas a través del servidor MCP 2.
Para su aplicación práctica, se recomienda diseñar la arquitectura MCP siguiendo este orden.
- Paso 1: Establecer una ruta de desvío para los resultados: Indicar explícitamente al servidor MCP en el prompt del cliente anfitrión que "guarde los resultados en archivos o devuelva solo un resumen mínimo" 1.
- Paso 2: Delegar la generación masiva: Utilizar la ventana de contexto de 1M de DeepSeek y
deepseek_batchpara procesar en paralelo tareas de conversión de texto o códigos de más de 700 líneas con especificaciones claras, como pruebas o boilerplates 1. - Paso 3: Preservar recursos del host: No cargar directamente en el contexto del host los archivos generados, sino solicitar juicios a Claude pasando solo indicadores como la 'ubicación del archivo' o los 'códigos de error del resultado de ejecución' 1.
- Paso 4: Intervención humana/host (HITL): Intervenir el cliente anfitrión o el usuario solo cuando sea necesaria una verificación visual basada en capturas de pantalla o ajustes finos de lógica de seguridad o financiera 1.
Este sistema va más allá del simple ahorro de precios de API. Impide que la ventana de contexto de los modelos caros se inflame innecesariamente por tokens de generación masiva baratos, creando una estructura donde el recurso más caro y inteligente se destina únicamente al 'juicio'.
Al final, la eficiencia en el entorno de desarrollo de IA no es un problema de elegir bien un solo modelo, sino de diseñar una arquitectura que utilice protocolos estándar como MCP para segmentar con precisión entre los modelos y herramientas la 'generación de tareas largas' y las 'decisiones importantes'. En el momento en que se diseñe DeepSeek MCP no como una simple API alternativa, sino como un 'punto de trabajo independiente que libera al host desviando los resultados a archivos', se podrán lograr simultáneamente los objetivos de reducir costes de tokens y tiempos de procesamiento.
Referencias
- 클로드 코드에 딥시크MCP 붙였어 · gall.dcinside.com↩
- GitHub - DMontgomery40/deepseek-mcp-server: Model Context Protocol server for DeepSeek's advanced language models · github.com↩
- LLM API Pricing 2026: OpenAI, Gemini, Claude & Grok | IntuitionLabs · intuitionlabs.ai↩



