仅使用个人GPU从零开始训练以韩语为中心的1.35B参数模型的实验已经公开。scarlet-alpha-1.3b-preview项目以总计240美元的成本完成了约220亿(22B)token规模的预训练,降低了技术门槛,但同时也明确暴露了小型模型所面临的硬件与数据局限性 1。从训练过程中因VRAM限制而进行精度选择所获得的经验,到导致基准测试分数被高估的数据污染问题,再到因特殊token初始化失败而引发的句子结尾错误,本文整理了旨在设计小型韩语模型的从业人员必须掌握的具体洞察与常见陷阱。
240美元消化220亿token的硬件限制现实
使用个人GPU训练1.35B参数模型时,首先面临的现实问题是VRAM的物理限制。scarlet-alpha-1.3b-preview的预训练利用4张至8张RTX 5090 GPU进行,规模约为220亿(22B)token,总成本约为240美元 1。即使1.35B模型的规模看似较小,但若包含优化器状态,其实际VRAM使用量将超过25GB,因此在单张RTX 5090的环境中甚至无法加载模型 1。受此限制,模型并行或多GPU分布式训练成为必不可少的前提条件。
精度选择也可能导致与直觉预期不符的结果。虽然从节省内存的角度可以考虑采用最新的FP4精度,但实验结果显示,尽管FP4的矩阵乘法本身速度较快,但由于每一层附加的额外开销导致GPU需等待CPU,且内存效率低于FP8,最终导致训练速度变慢 1。因此,即使是小型模型,FP8混合精度训练也是现实的基准点,需谨记盲目降低精度可能会同时损害性能和内存效率。
租用云端GPU时发生的网络与存储故障
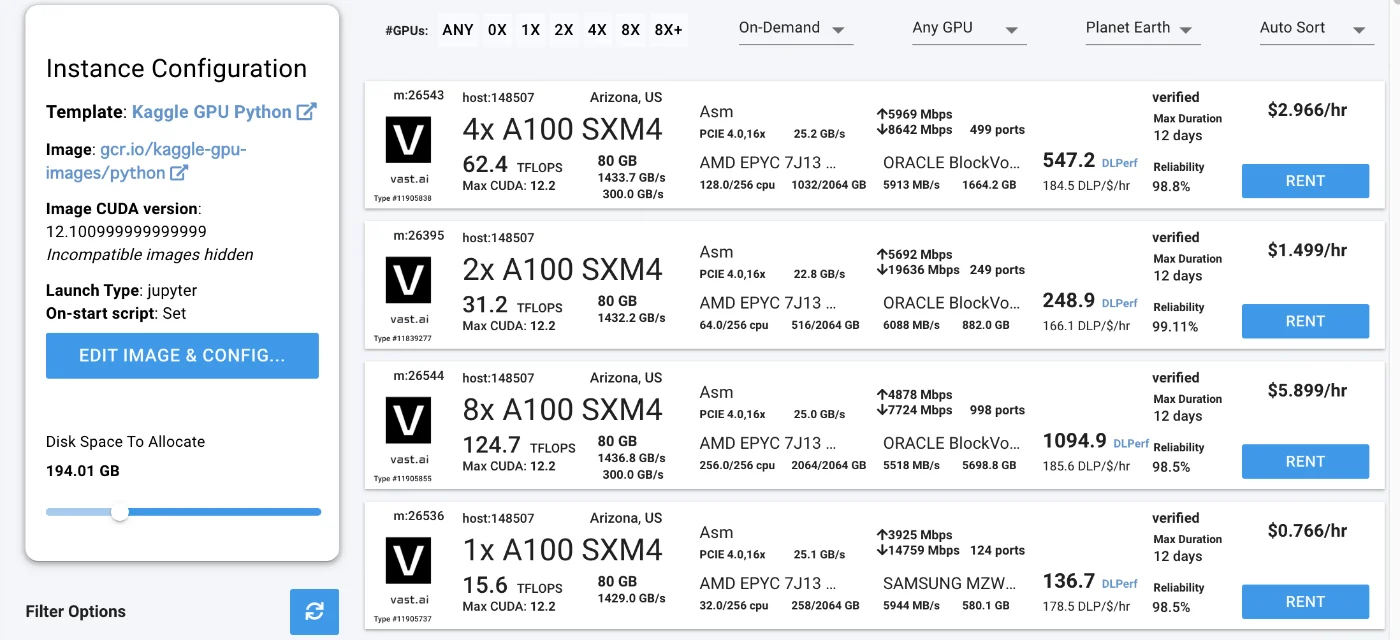
为了弥补个人环境的局限性,若使用vast.ai等云端GPU租赁平台,主机间网络带宽的巨大差异会成为一个显著变量。在使用vast.ai时,对于未通过数据中心认证的主机,4台中有3台因网络问题甚至无法开始训练 1。
即使训练看似正常进行,若存储连接不稳定,会导致检查点保存延迟,进而造成已累积的部分训练进度丢失,此类案例已有报道 1。仅仅获得GPU算力并不保证训练成功,需要具备能够预先验证并阻断训练数据加载及模型保存路径所用网络带宽与存储稳定性的基础设施管理能力。
夸大基准测试分数的韩语数据污染
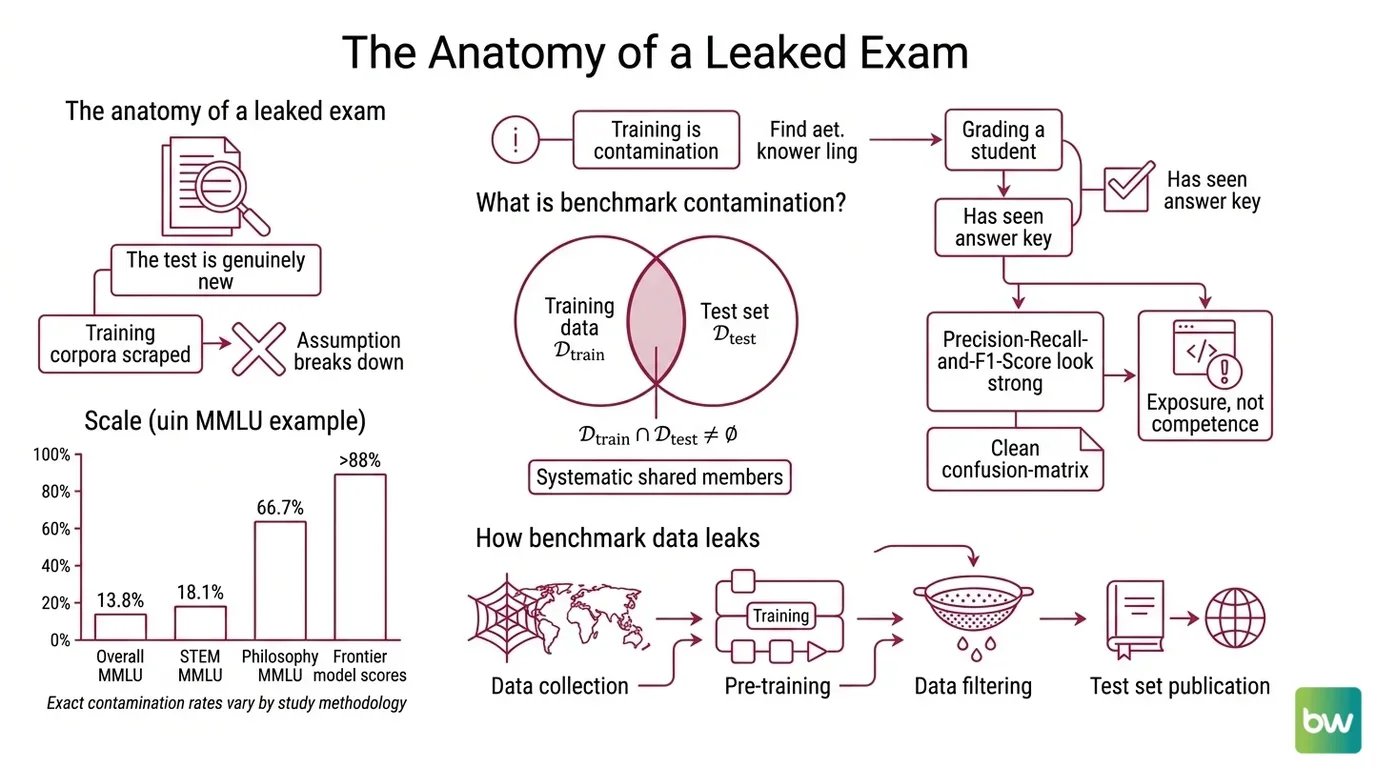
在预训练阶段,训练数据的来源是决定评估指标可靠性的核心因素。scarlet-alpha-1.3b-preview在预训练检查点基准上,在KoBEST COPA等多个韩语基准测试中记录了显著高于gemma-3-1b-pt的分数,但这一过程涉及了数据污染(Contamination)现象 1。
若重点使用维基百科作为训练数据,其与基准测试集的重合率会急剧升高,导致分数高于实际语言理解能力,从而产生高估结果 1。具体而言,在KoBEST BoolQ中,1404道题目中有1025道与训练数据高度重合,因此在评估中被剔除;排除重合题目后,与对比模型的差异便消失了 1。此外,经过短暂追加训练后,数学题准确率从101题(共224题)上升至170题,但由于192个测试句子中有96个已包含在训练数据中,因此暗示这可能仅是简单的句子记忆 1。在开发韩语模型时,为避免被基准测试的绝对数值所迷惑,必须预先过滤并净化测试集与训练语料库的交集,这一预处理工作至关重要。
转向对话模型时SFT特殊Token初始化遗漏
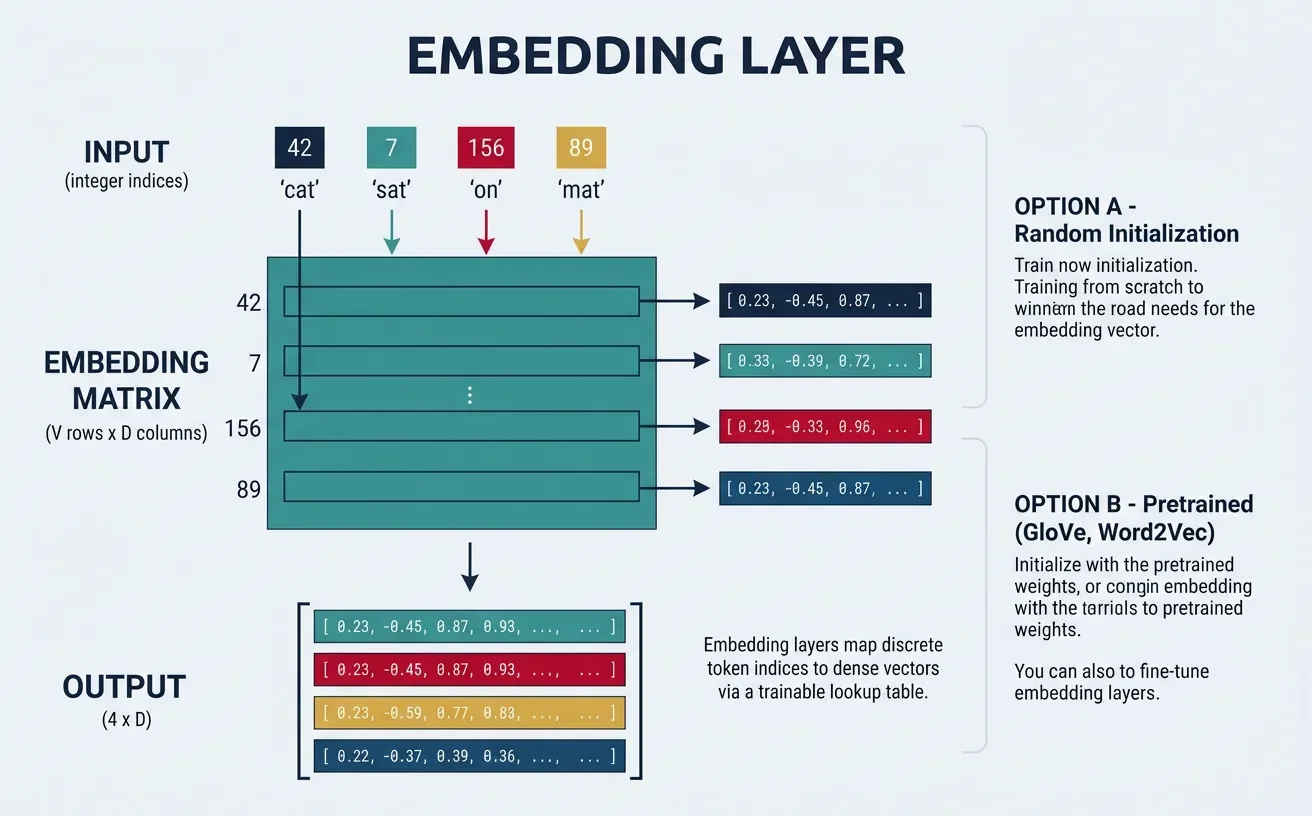
在将预训练模型转换为对话模型所需的监督微调(SFT, Supervised Fine-Tuning)阶段,反映韩语形态素特征的对话模板中的特殊token处理成为了主要陷阱之一。如果在预训练数据不包含特殊token的情况下完成训练,随后进入SFT阶段,即使模型的tokenizer中定义了用于对话的特殊token,也会出现其对应的嵌入向量(Embedding)未得到适当初始化的问题 1。
如果特殊token向量保持未训练状态,模型在生成回答时会出现无法正确结束句子的错误。实验结果显示,在未进行初始化的情况下执行SFT,50次尝试中0次能正确结束回答;而在将该特殊token向量单独进行适当初始化并投入训练流程后,50次尝试中49次能正常结束句子 1。由于韩语中根据句尾助词或词尾的不同,tokenizer分割token的方式较为复杂,因此必须在SFT初始阶段务必进行token向量一致性检查。
方向依赖性与推理能力的明暗面
小型模型在韩语生成能力与计算能力方面的局限性也得到了具体确认。scarlet-alpha-1.3b-preview在韩语专用基准测试分数上优于Gemma-3-1b-pt,但在像GSM8K-ko这样的应用题推理中,相较于同级模型并未显示出显著差异 1。以GSM8K-ko准确率为准,在贪婪解码(greedy decoding)下得分为0.198,与对比模型(gemma-3-1b-it)的0.214分相比并无差异;在IFEval-Ko中则表现出略低的性能(0.284 vs 0.342) 1。
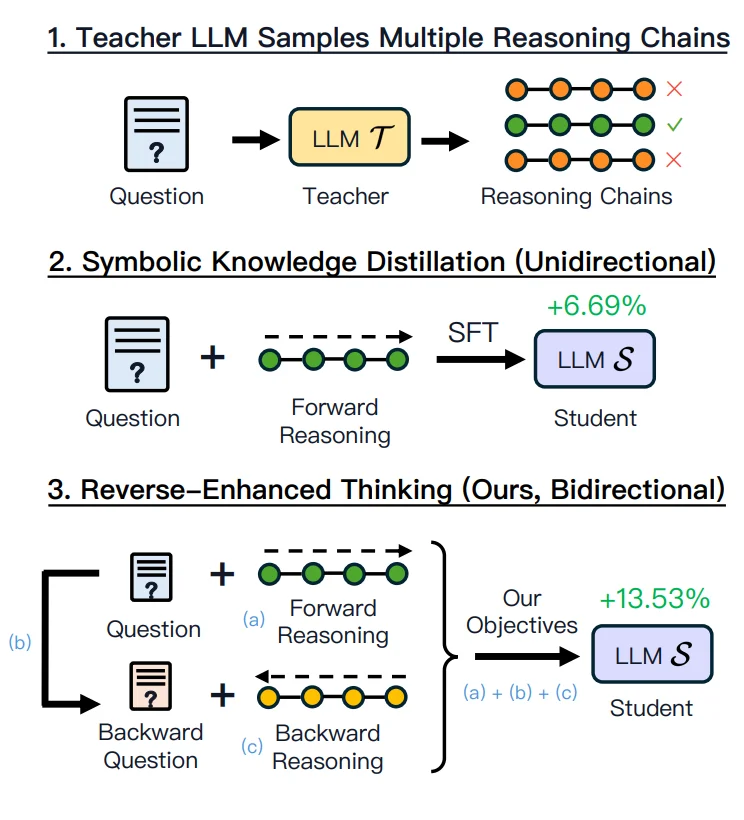
最值得关注的现象是,参数较小的模型其计算能力会随形式(form)的不同而产生较大波动。对于“A的首都是B”这一正向事实,模型显示出高达−1.42的平均正确答案对数概率;但当以反向方式提问(“B是哪个国家的首都”)时,平均正确答案对数概率降至−3.23,正确答案概率相差约6倍 1。这种方向性偏差表明,即使是相同的事实,也需根据方向分别学习,这被认定为导致应用题计算中追踪中间步骤运算或逻辑连接环节时出现错误的原因之一。
蒸馏损失函数的失败与输出控制调优技巧
为了进一步提升性能而引入的损失函数或调优技巧有时反而适得其反。为了蒸馏(Distillation)模型知识,在预训练中并行应用了遵循现有模型(Gemma 4 E2B)输出的蒸馏损失,结果发现所有领域的性能反而下降 1。因此,蒸馏损失函数被从最终训练流程中移除。
另一方面,随着句子生成变长出现的特定单词重复现象(Repetition)难以仅通过调整数据来解决,因此必须在解码阶段应用重复惩罚(Repetition Penalty)参数进行控制 1。虽然赋予重复惩罚可以解决这一现象,但重复产生的确切原因尚未查明 1。这一案例表明,相较于修改模型权重,调整推理阶段的参数可能是更实际且快速的解决方案。
参考资料
- 자작모델 1.35B 파라미터 한국어 중심 모델을 사전학습했습니다 · arca.live↩



