個人GPUのみで韓国語中心の1.35Bパラメータモデルを一から学習する実験が公開されました。scarlet-alpha-1.3b-previewプロジェクトは総額240ドルのコストで約22Bトークン規模の事前学習を完遂し、技術的な参入障壁を下げた一方で、小型モデルが直面するハードウェアとデータの限界を明確に示しました 1。学習中のVRAM限界に起因する精度選択の教訓から、ベンチマークスコアを過大評価させるデータ汚染問題、そして特殊トークン初期化の失敗による文の終了エラーに至るまで、小型韓国語モデルの設計を目指す実務者にとって必須の具体的なインサイトと落とし穴をまとめました。
240ドルで22Bトークンを処理するハードウェア制約の現実
個人GPUで1.35Bパラメータのモデルを学習する際に最初に直面する現実的な課題は、VRAMの物理的な限界です。scarlet-alpha-1.3b-previewの事前学習は、RTX 5090を4枚から8枚使用して約22Bトークン規模で実施され、総コストは約240ドルと集計されました 1。小さく見える1.35Bモデルでもオプティマイザの状態を含めると実際のVRAM使用量は25GBを超えるため、単一のRTX 5090環境ではモデルの読み込み自体が不可能な状態になります 1。こうした制約により、モデル並列化や複数GPUによる分散学習が必須の前提条件となります。
精度選択も、直感的な予想とは異なる結果を招く可能性があります。メモリ節約の観点から最新技術であるFP4精度を検討することも可能ですが、実験結果によるとFP4では行列積そのものは高速であったものの、各層に付随する追加のオーバーヘッドによりGPUがCPUを待たされる状態となり、メモリ効率もFP8より低いため学習速度が遅いことが確認されました 1。したがって、小型モデルであってもFP8混合精度学習が現実的な基準点であり、無闇な精度の縮小は性能とメモリの両方を損なう可能性があることに注意が必要です。
クラウドGPUレンタル時に発生するネットワークとストレージの障害
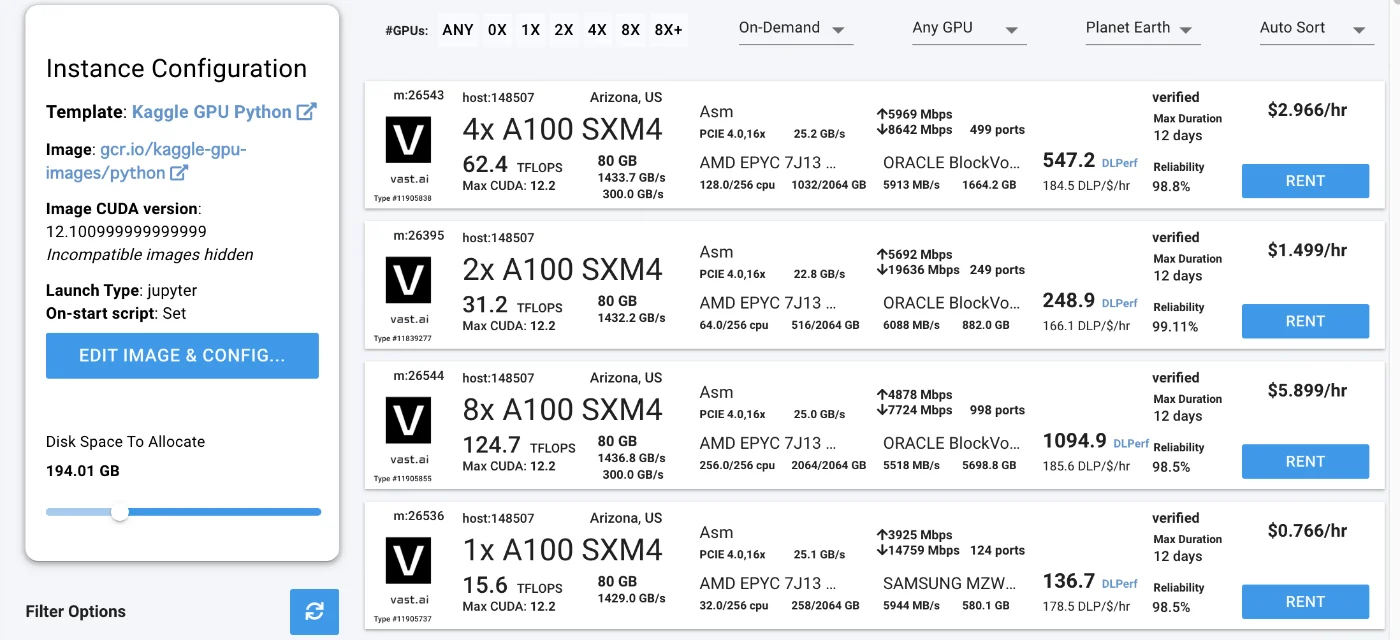
個人環境の限界を補うためにvast.aiなどのクラウドGPUレンタルプラットフォームを活用する場合、ホスト間ネットワーク帯域幅のばらつきが大きな変数として作用します。vast.aiを使用する場合、データセンター認証のないホストでは、4件中3件はネットワークの問題により学習を開始できさえしなかったとの報告があります 1。
さらに、学習が正常に進んでいる最中でも、ストレージ接続が不安定だとチェックポイントの保存が遅延し、その結果、既に蓄積された学習の進捗の一部が失われる事例が報告されています 1。GPUの計算能力そのものを確保するだけでは学習の成功は保証されず、学習データの読み込みやモデルの保存パスとして使用されるネットワーク帯域幅とストレージの安定性を事前検証し、遮断するインフラ管理の能力が求められます。
ベンチマークスコアを膨らませる韓国語データの汚染
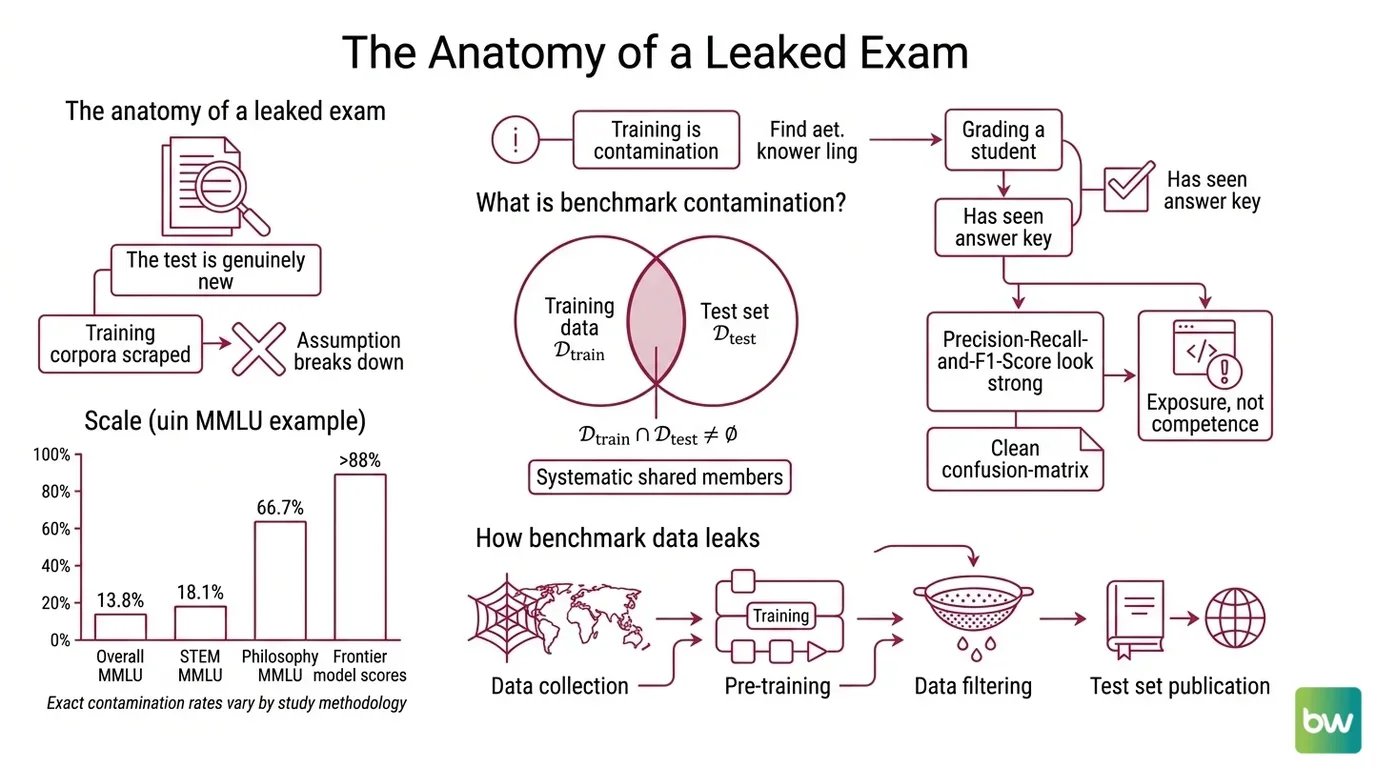
事前学習段階における学習データのソースは、評価指標の信頼性を決定づける核心的な要素です。scarlet-alpha-1.3b-previewは、事前学習チェックポイントベースでKoBEST COPAなどの複数の韓国語ベンチマークにおいて、gemma-3-1b-ptよりも有意に高いスコアを記録しましたが、この過程ではデータ汚染(Contamination)の現象が介在していました 1。
学習データとしてウィキペディアを重点的に使用する場合、ベンチマークテストセットとの重複傾向が急激に高まり、実際の言語理解能力よりもスコアが過大評価される結果を生みます 1。具体的には、KoBEST BoolQの場合、1,404問中1,025問が学習データと多く重複しており、評価から除外措置がとられ、重複した設問を除外すると比較モデルとの差は消失しました 1。また、短い追加学習の後、計算問題の正答率が101問(全224問)から170問に上昇しましたが、テスト文章192問のうち96問が既に学習データに含まれており、単純な文の暗記である可能性が示唆されました 1。韓国語モデルを開発する際にベンチマークの絶対的数値に惑わされないためには、事前にテストセットと学習コーパスの共通部分をフィルタリングして精製する前処理作業が必須です。
対話型モデルへの移行時のSFT特殊トークン初期化の欠如
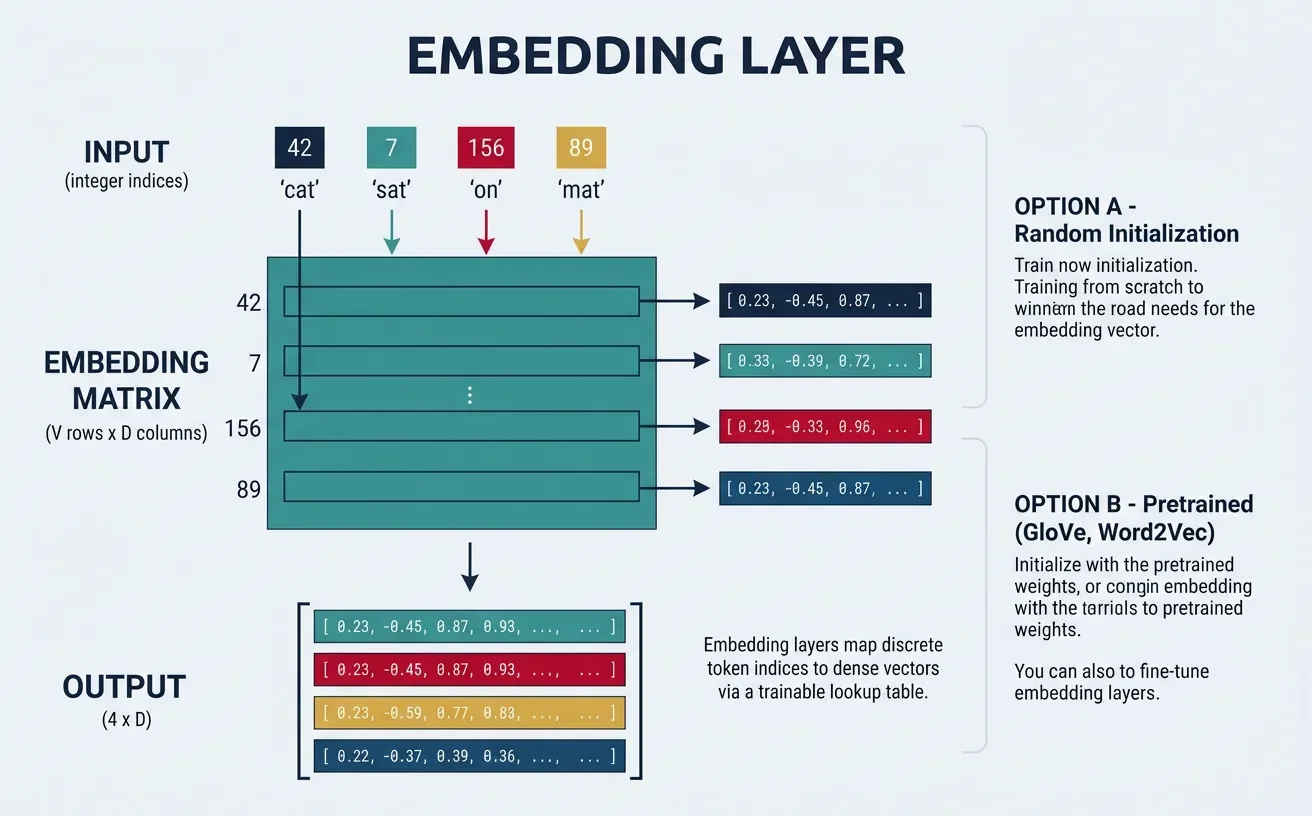
事前学習済みモデルを対話型へ変換するための教師あり学習(SFT、Supervised Fine-Tuning)段階では、韓国語の形態素特性を反映した対話テンプレートの特殊トークン処理が重要な落とし穴の一つとして作用しました。事前学習データには特殊トークンが含まれない状態で学習を進めており、SFT過程に入ると、モデルのトークナイザーに対話用の特殊トークンが定義されていても、対応するベクトル(Embedding)が適切に初期化されない問題が発生します 1。
特殊トークンのベクトルが学習されないまま残っている場合、学習済みモデルが回答を生成している最中に文を正しく終了できないエラーが発生します。実験の結果、初期化されない状態でSFTを実行した場合、回答を正しく終了したケースは50回中0回でしたが、該当する特殊トークンのベクトルを別途適切に初期化して学習プロセスに投入したところ、50回中49回で正常な終了が行われました 1。韓国語の文末終止詞や語尾に応じてトークナイザーがトークンを分割する方式は複雑であるため、トークンベクトルの整合性チェックはSFTの初期段階で必ず実行されなければなりません。
方向依存性と推論能力の明暗
小型モデルの韓国語生成能力および計算能力に関する限界も具体的に確認されました。scarlet-alpha-1.3b-previewは、韓国語専用ベンチマークのスコアではGemma-3-1b-ptより優位を示しましたが、GSM8K-koのような文章題ベースの推論問題では、同規模のモデルと比較して有意な差を見せませんでした 1。GSM8K-koの正答率基準でgreedyデコーディングを行った結果0.198を記録し、比較モデル(gemma-3-1b-it)の0.214と差がなく、IFEval-Koではやや低い性能(0.284 vs 0.342)を示しました 1。
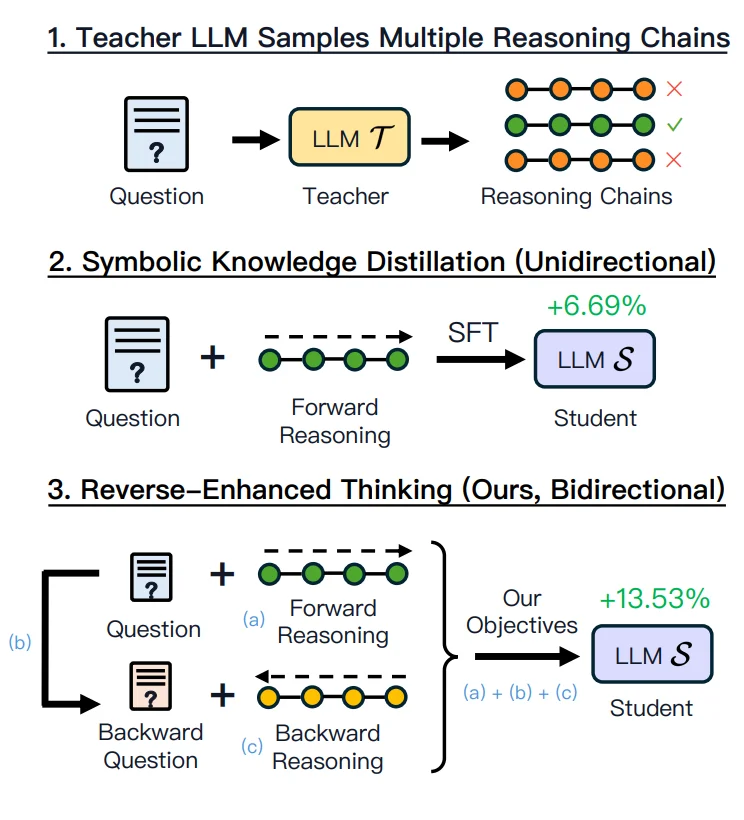
最も注目すべき現象は、パラメータの小さなモデルが形式(form)によって計算能力の変動幅が大きい点です。モデルは「Aの首都はB」という正方向の事実に対して、正解の対数確率平均−1.42という高い予測確率を示しましたが、これを逆方向(「Bが首都である国」)で質問した際には、正解の対数確率平均が−3.23に低下し、正解確率が約6倍の差となりました 1。こうした方向性バイアスは、同じ事実であっても方向ごとに個別に学習する必要があることを示唆しており、文章題の計算において中間ステップの演算や論理的なつながりを追跡する過程でエラーを引き起こす原因として指摘されています。
蒸留損失関数の失敗と出力制御チューニングのヒント
さらなる性能向上のために導入した損失関数やチューニング手法が、むしろ裏目に出るケースも発生しました。モデルの知識を蒸留(Distillation)するため、既存モデル(Gemma 4 E2B)の出力に追従させる蒸留損失を事前学習に並行適用した結果、すべてのドメインで性能がむしろ低下する現象が見られました 1。これにより、蒸留損失関数は最終的な学習プロセスから除外されました。
一方、文章生成が長くなると特定の単語を繰り返す反復現象(Repetition)は、データの調整だけでは容易に解消されないため、デコーディング段階で反復ペナルティ(Repetition Penalty)パラメータを適用して制御する必要がありました 1。反復ペナルティを付与するとこの現象は解決されますが、反復が発生する正確な原因は特定されていません 1。モデルの重みを修正するよりも、推論時のパラメータ調整の方が実際的かつ迅速な解決策となり得ることを示す事例です。
参考文献
- 자작모델 1.35B 파라미터 한국어 중심 모델을 사전학습했습니다 · arca.live↩



