Se ha publicado un experimento que entrena desde cero un modelo de 1,35 mil millones de parámetros centrado en el coreano utilizando únicamente GPUs personales. El proyecto scarlet-alpha-1.3b-preview completó un preentrenamiento de aproximadamente 22 mil millones de tokens con un costo total de 240 dólares, reduciendo así las barreras de entrada técnica, pero al mismo tiempo reveló con claridad las limitaciones de hardware y datos que enfrentan los modelos pequeños 1. Desde las lecciones sobre la elección de precisión debido a las limitaciones de VRAM durante el entrenamiento, hasta el problema de la contaminación de datos que sobreestima las puntuaciones de los benchmarks, y los errores en el cierre de oraciones causados por el fallo en la inicialización de tokens especiales, el informe recopila información concreta y trampas esenciales para los profesionales que diseñan modelos pequeños en coreano.
La realidad de las restricciones de hardware para procesar 22 mil millones de tokens con 240 dólares
Al entrenar un modelo de 1,35 mil millones de parámetros con una GPU personal, lo primero con lo que se tropieza es con el límite físico de la VRAM. El preentrenamiento de scarlet-alpha-1.3b-preview se realizó utilizando entre 4 y 8 RTX 5090 para alcanzar una escala de aproximadamente 22 mil millones de tokens, con un costo total estimado en 240 dólares 1. Incluso para un modelo de 1,35 mil millones que parece pequeño, el uso real de VRAM supera los 25 GB cuando se incluyen los estados del optimizador, lo que hace que sea imposible cargar el modelo en un entorno con una sola RTX 5090 1. Debido a estas restricciones, la paralelización del modelo o el entrenamiento distribuido en múltiples GPUs se convierten en condiciones previas indispensables.
La elección de la precisión también puede conducir a resultados contrarios a las intuiciones esperadas. En términos de ahorro de memoria, se podría considerar la precisión FP4 como tecnología de vanguardia; sin embargo, los resultados experimentales mostraron que, aunque la multiplicación de matrices en FP4 era rápida, el tiempo adicional asociado a cada capa provocaba que la GPU quedara a la espera de la CPU, y la eficiencia de memoria era inferior a la de FP8, resultando en una velocidad de entrenamiento más lenta 1. Por lo tanto, incluso para modelos pequeños, el entrenamiento en precisión mixta FP8 constituye el punto de referencia realista, y hay que tener en cuenta que la reducción indiscriminada de la precisión puede perjudicar tanto el rendimiento como la memoria.
Fallos de red y almacenamiento al alquilar GPUs en la nube
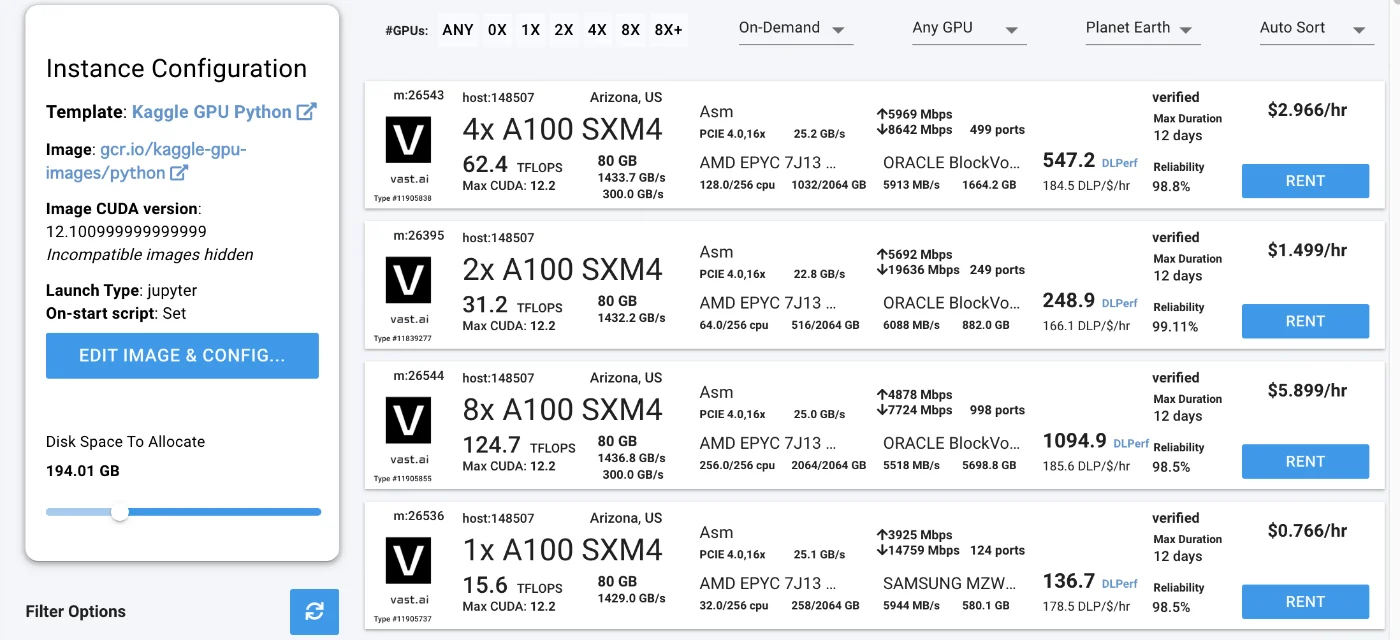
Para compensar las limitaciones de los entornos personales, si se utilizan plataformas de alquiler de GPUs en la nube como vast.ai, la variabilidad en el ancho de banda de red entre hosts actúa como una variable significativa. Al usar vast.ai, en el caso de hosts sin certificación de centro de datos, 3 de cada 4 no pudieron siquiera iniciar el entrenamiento debido a problemas de red 1.
Incluso durante un entrenamiento aparentemente normal, si la conexión de almacenamiento es inestable, se producen retrasos en el guardado de checkpoints, lo que ha llevado a informes de pérdida parcial del progreso del entrenamiento ya acumulado 1. El éxito del entrenamiento no depende únicamente de asegurar la capacidad de cómputo de la GPU; se requiere una capacidad de gestión de infraestructura capaz de verificar y mitigar de antemano el ancho de banda de red y la estabilidad del almacenamiento utilizados para la carga de datos de entrenamiento y las rutas de guardado del modelo.
Contaminación de datos coreanos que infla las puntuaciones de los benchmarks
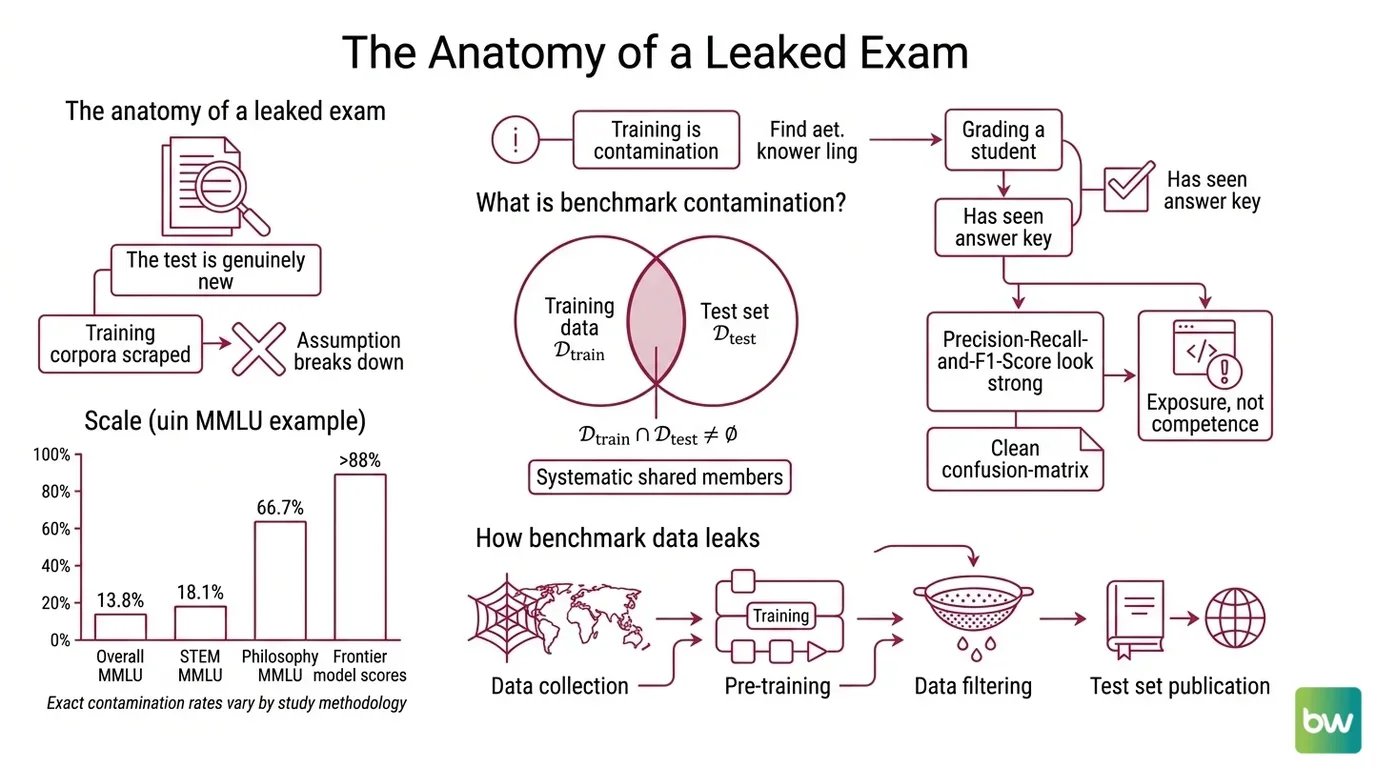
Durante la etapa de preentrenamiento, la fuente de los datos de entrenamiento es un factor clave que determina la fiabilidad de las métricas de evaluación. En los checkpoints de preentrenamiento, scarlet-alpha-1.3b-preview registró puntuaciones significativamente superiores a las de gemma-3-1b-pt en varios benchmarks coreanos como KoBEST y COPA, pero en este proceso intervino el fenómeno de contaminación de datos (Contamination) 1.
Si se utiliza Wikipedia de manera prioritaria como datos de entrenamiento, la tendencia a solaparse con los conjuntos de prueba de los benchmarks aumenta drásticamente, lo que conduce a puntuaciones sobreestimadas en comparación con la competencia lingüística real 1. Específicamente, en KoBEST BoolQ, 1,025 de las 1,404 preguntas coincidían sustancialmente con los datos de entrenamiento y fueron excluidas de la evaluación; al eliminar las preguntas solapadas, la diferencia con el modelo comparativo desapareció 1. Además, después de un breve aprendizaje adicional, la exactitud en problemas de cálculo aumentó de 101 aciertos (de un total de 224) a 170, pero dado que 96 de las 192 frases de prueba ya estaban incluidas en los datos de entrenamiento, se sugiere que podría tratarse de una simple memorización de frases 1. Para no dejarse seducir por las cifras absolutas de los benchmarks al desarrollar modelos en coreano, es imprescindible realizar una tarea de preprocesamiento que filtre y depure la intersección entre los conjuntos de prueba y el corpus de entrenamiento de antemano.
Omisión de la inicialización de tokens especiales en el SFT al convertir a modelo conversacional
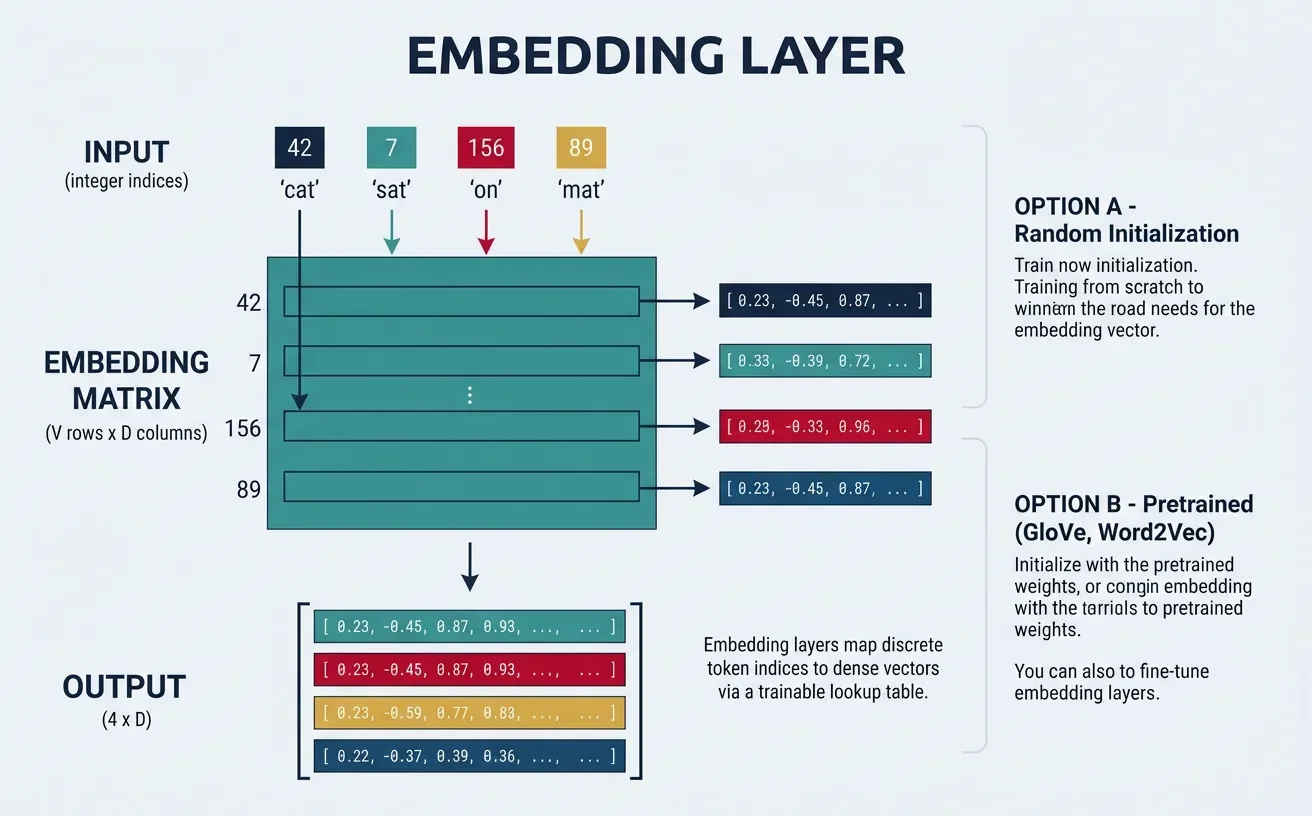
En la etapa de ajuste fino supervisado (SFT, Supervised Fine-Tuning) para convertir un modelo preentrenado en uno conversacional, el tratamiento de los tokens especiales en las plantillas de conversación que reflejan las características morfológicas del coreano se convirtió en una de las trampas importantes. Si el preentrenamiento se realiza sin incluir los tokens especiales en los datos, al entrar en el proceso de SFT surge el problema de que, aunque el tokenizador del modelo defina los tokens especiales para la conversación, sus vectores (Embeddings) no se inicializan correctamente 1.
Si los vectores de los tokens especiales permanecen sin entrenar, el modelo produce errores al no poder cerrar las oraciones mientras genera respuestas. Los resultados experimentales mostraron que, al ejecutar SFT sin una inicialización adecuada, el modelo logró cerrar las respuestas en 0 de 50 ocasiones; en cambio, al inicializar adecuadamente por separado los vectores de esos tokens especiales e incorporarlos al proceso de entrenamiento, los cierres correctos alcanzaron 49 de 50 casos 1. Dado que la forma en que el tokenizador divide los tokens es compleja según los terminadores de oración o los sufijos verbales del coreano, la verificación de la consistencia de los vectores de tokens debe realizarse obligatoriamente en las etapas iniciales del SFT.
Dependencia de la direccionalidad y luces y sombras de la capacidad de razonamiento
También se confirmaron de manera concreta las limitaciones en la capacidad de generación y cálculo en coreano de los modelos pequeños. Aunque scarlet-alpha-1.3b-preview superó a Gemma-3-1b-pt en las puntuaciones de benchmarks específicos para coreano, no mostró diferencias significativas frente a modelos de categoría similar en problemas de razonamiento verbales como GSM8K-ko 1. Según la exactitud en GSM8K-ko, los resultados de decodificación greedy registraron una puntuación de 0,198, sin diferencia con respecto a los 0,214 del modelo comparativo (gemma-3-1b-it), y en IFEval-Ko mostró un rendimiento ligeramente inferior (0,284 frente a 0,342) 1.
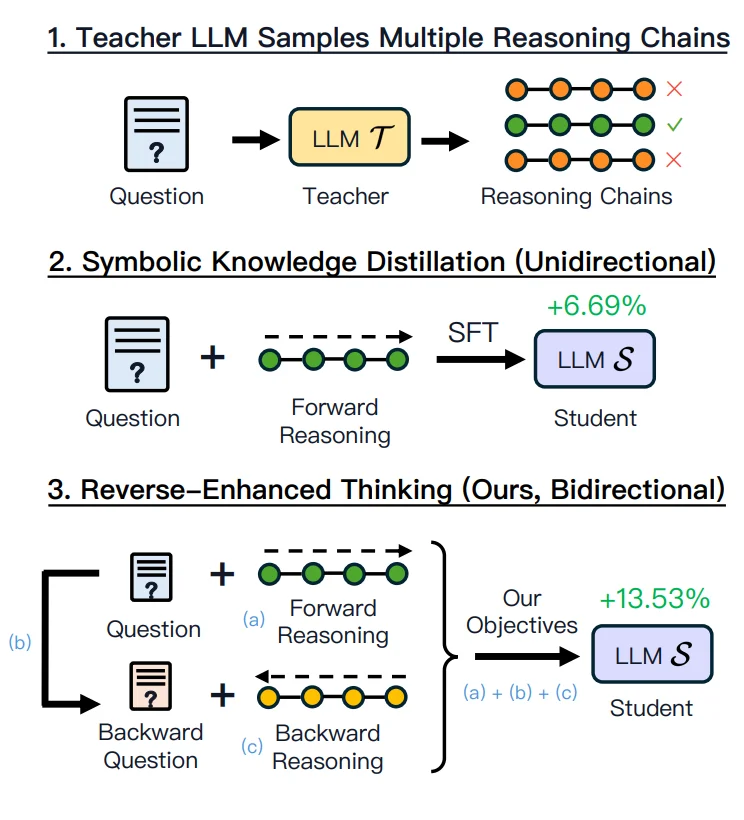
El fenómeno más destacado es que los modelos con menos parámetros experimentan una mayor variabilidad en su capacidad de cálculo según la forma (form) de la pregunta. El modelo mostró una alta probabilidad de predicción para el hecho directo "La capital de A es B", con una media de log-probabilidad de la respuesta correcta de −1,42; sin embargo, al plantear la pregunta inversa ("El país cuya capital es B"), la media de log-probabilidad de la respuesta correcta cayó a −3,23, lo que implicó una diferencia aproximada de 6 veces en la probabilidad de acierto 1. Este sesgo de direccionalidad sugiere que, incluso para el mismo hecho, el aprendizaje debe realizarse por separado según la dirección, y se señala como una causa de errores en el rastreo de operaciones intermedias o enlaces lógicos durante los cálculos verbales.
El fracaso de las funciones de pérdida por destilación y consejos de ajuste para el control de la salida
En ocasiones, las funciones de pérdida o técnicas de ajuste introducidas para mejorar el rendimiento resultaron contraproducentes. Cuando se aplicó paralelamente al preentrenamiento una pérdida por destilación (Distillation) que obligaba al modelo a imitar las salidas del modelo base (Gemma 4 E2B), el rendimiento se deterioró finalmente en todos los dominios 1. Como consecuencia, la función de pérdida por destilación se excluyó del proceso de entrenamiento final.
Por otra parte, dado que el fenómeno de repetición de palabras específicas cuando las oraciones generadas se alargan (Repetition) no se controla fácilmente solo con ajustes de datos, fue necesario aplicarlo mediante el parámetro de penalización de repetición (Repetition Penalty) en la etapa de decodificación 1. Si bien aplicar penalización de repetición soluciona este fenómeno, la causa exacta de la repetición no se ha identificado 1. Este caso demuestra que la ajuste de parámetros en la etapa de inferencia puede ser una solución más práctica y rápida que la modificación de los pesos del modelo.
Referencias
- 자작모델 1.35B 파라미터 한국어 중심 모델을 사전학습했습니다 · arca.live↩



