假设有一个3D模型和纹理处理完美无缺,光照处理也无可挑剔,从而呈现出极其简洁的CG渲染画面。然而,将其与真实拍摄的背景合成时,往往给人留下“不自然”的印象。问题并不在于分辨率或细节的不足。根据VFX合成专业工作室Animost的指南,合成过程的最后阶段,艺术家们会故意“添加”胶片颗粒(噪点)、镜头畸变、色差等元素1。也就是说,使其看起来像实拍视频的过程,与其说是消除缺陷,不如说更像是对仅存在于实拍视频中的物理痕迹进行人为重建。
动画或CG与实拍画面区分开来的核心原理,并不在于物体细节描绘的精度,而在于是否有由相机和光线物理性地留下的痕迹。通过实际镜头拍摄的画面中,会同时记录随物体移动产生的运动模糊、传感器细微的噪点以及光学系统的畸变。相比之下,从头开始用电脑绘制的CG则以没有这些缺陷的状态生成。因此,过于完美的清晰度反而成为暴露“非物理状态”的线索。
失去运动模糊的清晰画面
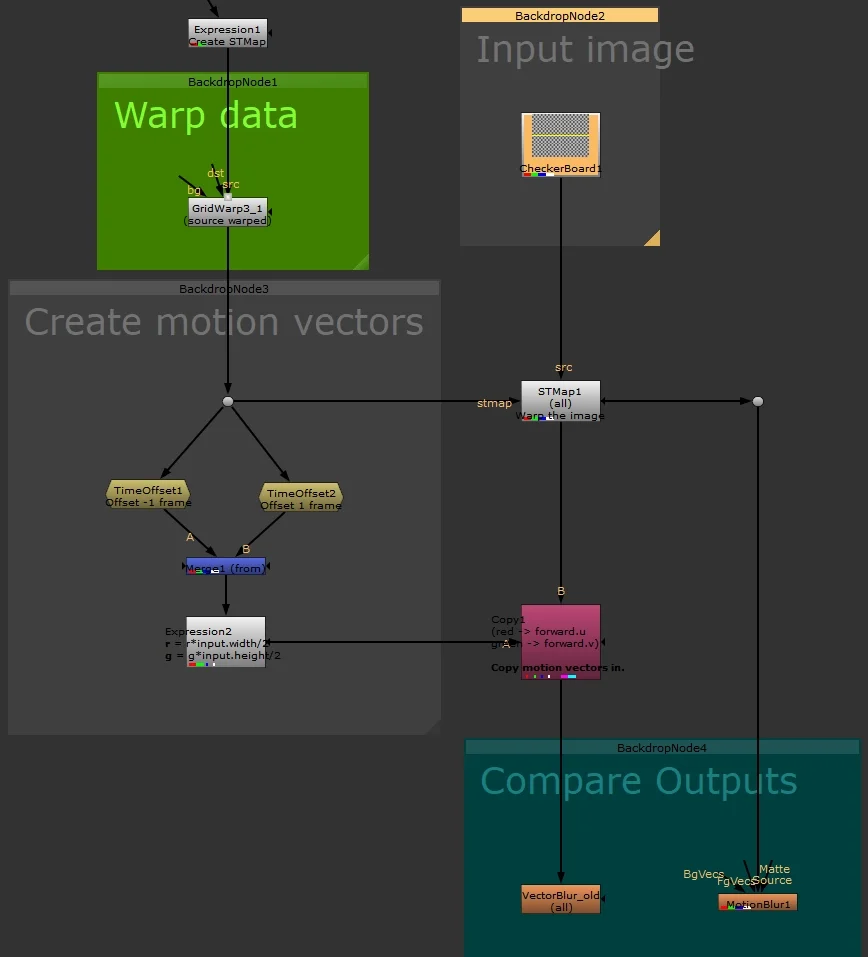
用真实相机拍摄移动的物体时,物体的边缘会产生残影。这被称为运动模糊(Motion Blur)。当物体在相机快门打开期间(例如1/50秒)移动时,光线接触传感器的位置不断变化,从而沿移动路径记录下类似污渍的痕迹。
CG渲染通过计算绘制每一帧的所有像素。此时,渲染引擎精确捕捉特定的“瞬间”,因此不会自动包含由实际相机快门速度引起的时域模糊。最终,所有物体的边缘都被绘制得像刀刃一样清晰。Animost明确指出,“Without motion blur, CGI looks fake(没有运动模糊,CG看起来就是假的)”1。当眼前的数字角色清晰得仿佛是用0秒超高速快门拍摄出来时,人类视觉系统会将其感知为与真实世界物理法则相悖的违和感。
在合成工作中处理运动模糊的方式,与简单应用模糊效果不同。根据Animost的工作流程,合成师利用Z-depth(深度信息)来营造景深(DOF)或雾效以体现空间感,同时利用独立的运动矢量(motion vectors)数据计算并应用基于矢量的运动模糊或3D相机模糊1。换言之,这是分别重建深度和运动,逐层重现实际相机移动时留下的时间与空间痕迹的工作。
色温与Light Wrap:让物体“生活在同一空气”中的措施
相机留下的痕迹不仅仅是运动模糊。为了将CG与实拍元素融合成一个世界,合成师必须确保多个阶段的物理一致性。
| 合成阶段 | 模仿的物理现象 | 主要技巧 |
|---|---|---|
| 色彩校正 | 现场光源的色温和曝光 | 色温匹配、分级调色 |
| 环境交互 | 主体周围产生的阴影和反射 | 接触阴影、Light Wrap |
| 景深表现 | 镜头的聚焦特性和景深 | 基于Z-depth的DOF |
| 最终收尾 | 胶片噪点及光学畸变 | 颗粒、光晕、色差 |
最容易察觉的线索是色温不匹配。Animost明确指出,“A warm 4000K light does not blend with a cool 6500K light(4000K的暖光无法与6500K的冷光融合)”1。想象一下,在一个混合了暖色白炽灯和冷色荧光灯的房间里,只有特定主体显得格外突出且颜色不同。我们的眼睛会从这种细微的不匹配中,产生“它并没有实际放置在同一空间”的印象。
此外,“Light Wrap(光线包裹)”这一技术将背景光线轻微地包裹并叠加在CG主体的边缘上,使CG元素自然地融入实拍底版中1。如果阴影、反射、大气效果等交互作用没有经过一致性计算,数字角色就会与背景分离,看起来像是叠加在画面上。
据Mimic Productions解释,CGI指的是计算机生成的图像元素本身,而VFX是指将其整合到拍摄的原始底版中,形成一个完整镜头的综合过程2。该工作室解释说,数字角色的最终可信度取决于从建模、纹理、光照到合成的全过程,特别是取决于物理上合理的光照、测量参考以及精心设计的变形(deformation)系统2。
物理交互的剩余差距
运动模糊或色差可以通过软件计算并应用。然而,实拍和特殊效果(SFX)依然被重视,原因在于再现更根本的物理属性的难度更高。Mimic Productions描述称,真实的碎片会“以不同的方式下落”,真实的烟雾会“以自然的复杂度散射光线”,尽管数字工作“试图模仿(often tries to emulate)”,但在重量、质感以及光线的行为上仍然存在差异2。
这里关键点在于“试图”这一表述。尽管CG模拟技术已经发展,但我们不能断言它已完全取代了实拍中真实物质的漫反射或细微的重力反应。特别是实地拍摄的特殊效果,因为包含了演员的自然反应,所以作为一种区别于数字合成的独特价值而保留了下来。
认知研究支持的判断原理
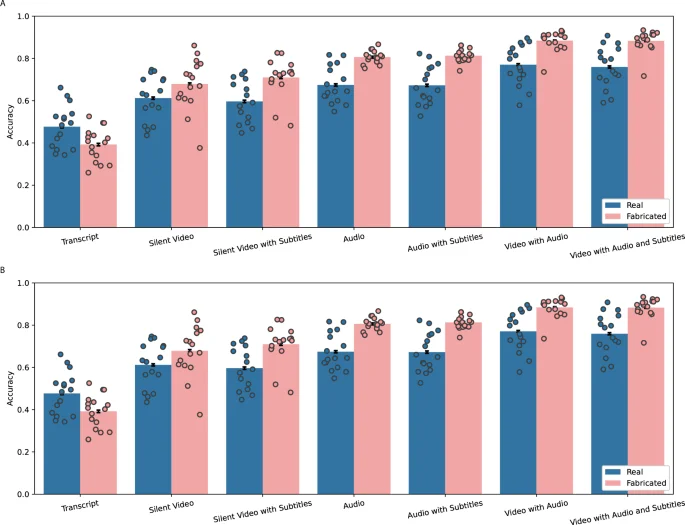
制作现场直观的判断在认知心理学研究中也得到了证实。发表于2024年9月《自然·通讯》的一项研究,针对2,215名参与者,验证了人类如何区分合成视频(深度伪造)3。在这项研究中,参与者更依赖言语的“表达方式”而非“内容”来辨别真伪。
"human discernment relies more on how something is said, the audio-visual cues, than what is said, the speech content(人类的辨别更依赖于“怎么说”(音视频线索),而非“说什么”(演讲内容))” 3
主实验的参与者在获得音视频信息时,比仅凭文本判断时能更准确地辨别操纵。根据论文引言中讨论的相关研究,受访者也曾将不自然的口型动作等表达方式的缺陷指定为“操纵”线索。虽然该研究的对象是政治演讲深度伪造,与CG动画并非完全相同的领域,但存在共同的轴线:人类的视觉系统在鉴别真伪时,依赖的是“承载信息的媒介的物理特性”,而非“画面中信息的内容”。正如深度伪造中不自然的口型动作会成为线索一样,CG中像静止帧一样清晰的边缘或色温不匹配,会作为“这不是拍摄”的信号发挥作用。
VFX合成师在最后阶段故意添加缺陷的工作,与人类通过缺陷的有无来辨别真伪的认知过程,确切地共享着同一原理。尽管技术的发展使渲染细节达到了欺骗人眼的水平,但真假之间的界限,依然取决于对光线和相机留下的物理缺陷一致性的还原,以及人眼对这种缺陷缺失的敏感程度。