3D 모델링과 텍스처링, 조명까지 완벽하게 처리해 화면상으로는 더없이 깔끔한 CG 렌더링이 있다고 가정해 보겠습니다. 그런데도 이를 실제 촬영된 배경에 합성하면 "부자연스럽다"는 인상을 남기는 경우가 많습니다. 문제는 해상도나 디테일의 부족함이 아닙니다. VFX 합성 전문 스튜디오 Animost의 가이드에 따르면, 합성 작업의 마지막 단계에서 아티스트들은 필름 그레인(잡음)과 렌즈 왜곡, 색수차 같은 요소를 의도적으로 다시 '더해 넣습니다'1. 즉, 실사처럼 보이게 하는 과정은 결점을 제거하는 것이 아니라, 촬영된 영상에만 존재하는 물리적 흔적을 인위적으로 복원하는 과정에 가깝습니다.
애니메이션이나 CG가 실사와 구별되는 핵심 원리는 물체의 세부 묘사 정밀도가 아니라, 카메라와 빛이 물리적으로 남기는 흔적의 유무에 있습니다. 실제 렌즈를 통과한 영상에는 피사체의 이동에 따른 잔상, 센서의 미세한 잡음, 광학계의 왜곡이 함께 기록됩니다. 반면 컴퓨터로 처음부터 그려낸 CG는 이러한 결함이 없는 상태로 생성됩니다. 따라서 지나치게 완벽한 선명함이 오히려 '비물리적 상태'임을 드러내는 단서가 됩니다.
모션 블러가 사라진 선명한 프레임
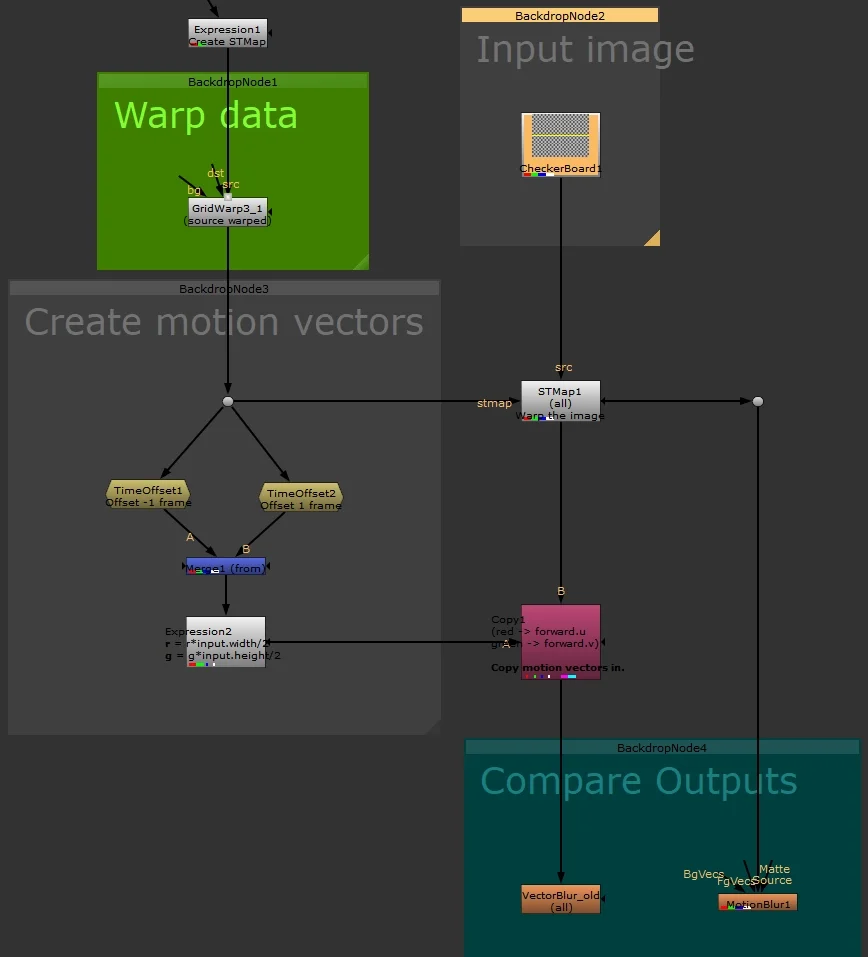
실제 카메라로 움직이는 물체를 찍으면 물체의 가장자리에 잔상이 생깁니다. 이를 모션 블러(Motion Blur)라고 부릅니다. 카메라 셔터가 열려 있는 동안(예를 들어 1/50초) 물체가 이동하면, 빛이 센서에 닿는 위치가 계속 변하면서 이동 경로를 따라 얼룩처럼 퍼진 흔적이 기록됩니다.
CG 렌더링은 한 프레임의 모든 픽셀을 계산으로 그립니다. 이때 렌더링 엔진은 특정 '순간'을 정밀하게 포착하는 것이므로, 실제 카메라의 셔터 속도에 따른 시간적 흐림은 자동으로 포함되지 않습니다. 결과적으로 모든 물체의 가장자리가 칼날처럼 선명하게 그려집니다. Animost는 이 지점을 "Without motion blur, CGI looks fake(모션 블러가 없으면 CG는 가짜로 보인다)"라고 명확히 지적합니다1. 눈앞의 디지털 캐릭터가 0초의 초고속 셔터로 촬영된 듯 선명할 때, 인간의 시각 체계는 이를 실세계의 물리 법칙과 충돌하는 이질감으로 감지합니다.
합성 작업에서 모션 블러를 처리하는 방식은 단순한 흐림 효과를 적용하는 것과 다릅니다. Animost의 워크플로에 따르면, 합성작가는 Z-depth(깊이 정보)를 이용해 피사계 심도(DOF)나 안개 효과를 만들어 공간감을 살리는 한편, 별도로 모션 벡터(motion vectors) 데이터를 활용해 벡터 기반 모션 블러나 3D 카메라 블러를 계산하여 적용합니다1. 즉, 깊이와 움직임을 각각 복원해 실제 카메라가 움직이며 남긴 시간과 공간의 흔적을 층층이 되살리는 작업인 셈입니다.
색온도와 라이트 랩: 같은 공기에 살게 하는 조처
카메라가 남기는 흔적은 모션 블러만이 아닙니다. 합성작가들은 CG와 실사 요소를 하나의 세계로 녹이기 위해 여러 단계의 물리적 정합성을 확보해야 합니다.
| 합성 단계 | 모방하는 물리적 현상 | 주요 기법 |
|---|---|---|
| 색 보정 | 현장 광원의 색온도 및 노출 | 색온도 정합, 그레이드 |
| 환경 상호작용 | 피사체 주변에 생기는 그림자와 반사 | 컨택트 섀도, 라이트 랩 |
| 심도 표현 | 렌즈의 초점 특성 및 피사계 심도 | Z-depth 기반 DOF |
| 최종 마무리 | 필름 잡음 및 광학 왜곡 | 그레인, 블룸, 색수차 |
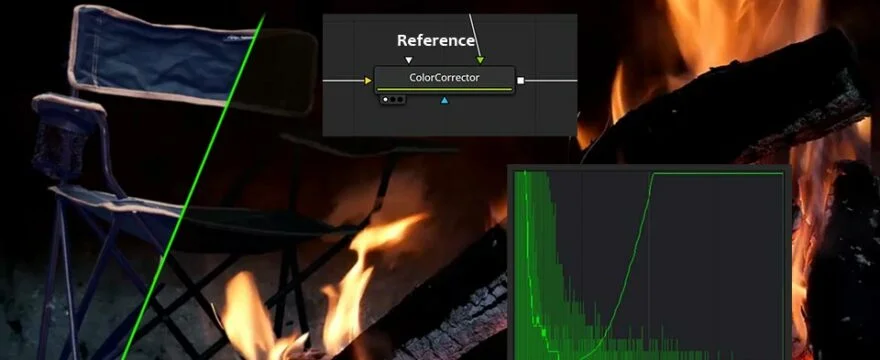
가장 일상적으로 느낄 수 있는 단서는 색온도 불일치입니다. Animost는 "A warm 4000K light does not blend with a cool 6500K light(따뜻한 4000K 조명은 차가운 6500K 조명과 섞이지 않는다)"고 명시합니다1. 따뜻한 백열등과 차가운 형광등이 섞인 방에서 특정 피사체만 유독 다른 색으로 떠 있는 느낌을 상상해 보세요. 우리 눈은 이런 미세한 불일치에서 '같은 공간에 실제로 놓여 있지 않다'는 인상을 얻습니다.
또한 '라이트 랩(light wrap)'이라는 기법은 배경의 빛을 CG 피사체 가장자리에 살짝 감싸 입혀, CG 요소가 실사 판에 자연스럽게 녹아들게 합니다1. 그림자, 반사, 대기 효과 같은 상호작용이 정합적으로 계산되지 않은 디지털 캐릭터는 배경과 분리되어 화면 위에 겹쳐 있는 것처럼 보입니다.
Mimic Productions의 설명에 따르면, CGI는 컴퓨터로 생성된 이미지 요소 자체를 뜻하고, VFX는 이를 촬영된 원본 영상판에 통합해 하나의 완성된 컷으로 만드는 포괄적 과정입니다2. 디지털 캐릭터의 최종 신뢰성은 모델링부터 텍스처링, 조명, 합성에 이르는 전 과정을 거치되, 특히 물리적으로 타당한 조명, 측정된 레퍼런스, 정교하게 설계된 변형(deformation) 시스템에서 결정된다고 이 스튜디오는 설명합니다2.
물리 상호작용의 잔여 격차
모션 블러나 색수차는 소프트웨어로 계산해 적용할 수 있습니다. 그러나 실제 촬영과 특수효과(SFX)가 여전히 중요하게 여겨지는 이유는 더 근본적인 물리성의 재현 난이도에 있습니다. Mimic Productions는 실제 파편이 "다른 방식으로 떨어지고", 실제 연기는 "자연스러운 복잡도로 빛을 산란시킨다"고 서술하며, 디지털 작업이 이를 "따라 하려고 시도하지만(often tries to emulate)" 무게와 질감, 빛의 거동에서는 여전히 차이가 난다고 설명합니다2.
여기서 중요한 점은 '시도한다'는 표현에 있습니다. CG 시뮬레이션 기술은 발전했지만, 현장 촬영된 실제 물질의 난반사나 미세한 중력 반응까지 완전히 대체했다고 단정할 수 없습니다. 특히 현장 촬영된 특수효과는 배우의 자연스러운 반응까지 담는다는 점에서 디지털 합성과 구별되는 고유한 가치로 남아 있습니다.
인지 연구가 뒷받침하는 판단 원리
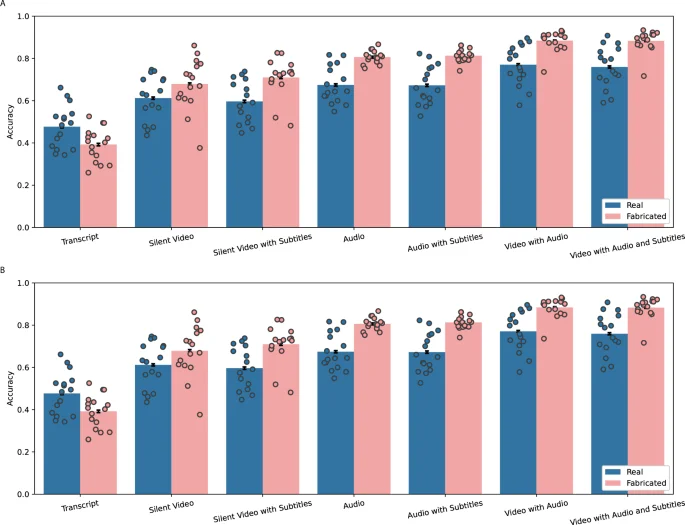
제작 현장의 직관적 판단은 인지심리학 연구로도 확인됩니다. Nature Communications에 2024년 9월 게재된 연구는 2,215명의 참가자를 대상으로 인간이 합성 영상(딥페이크)을 어떻게 구분하는지 검증했습니다3. 이 연구에서 참가자들은 말의 '내용'보다 '어떻게 전달되는가'에 더 의존해 진위를 판별했습니다.
"human discernment relies more on how something is said, the audio-visual cues, than what is said, the speech content (인간의 판별은 '무엇을 말하는가'(연설 내용)보다 '어떻게 말하는가'(음향·시각 단서)에 더 의존한다)" 3
주 실험의 참가자들은 텍스트만으로 판단할 때보다 음향·시각 정보가 주어졌을 때 조작을 더 정확히 판별했습니다. 논문 서론에서 함께 논의된 관련 연구에 따르면, 응답자들은 부자연스러운 입술 움직임 같은 전달 방식의 결함을 '조작' 단서로 지목하기도 했습니다. 이 연구의 대상은 정치 연설 딥페이크로 CG 애니메이션과 완전히 같은 영역은 아니지만, 공통된 축이 있습니다. 인간의 시각 체계는 '화면 속 정보의 내용'보다 '정보를 실어 나르는 매체의 물리적 특성'에서 진위를 판별한다는 점입니다. 딥페이크에서 부자연스러운 입술 움직임이 단서가 되듯, CG에서 정지 프레임처럼 선명한 모서리나 색온도 불일치는 '이건 촬영이 아니다'라는 신호로 작동합니다.
VFX 합성작가들이 마지막 단계에서 결함을 의도적으로 추가하는 작업과, 인간이 그 결함의 유무를 통해 진위를 가려내는 인지 과정은 정확히 같은 원리를 공유하고 있는 셈입니다. 기술이 발전해 렌더링 디테일이 인간의 눈을 속이는 수준에 이르렀지만, 진짜와 가짜의 경계는 여전히 빛과 카메라가 남기는 물리적 결함의 정합성 복원, 그리고 사람의 눈이 그 결함의 부재를 얼마나 민감하게 읽느냐에 달려 있습니다.