笔记本电脑插上电源的瞬间,GPU速度降至五分之一,而拔掉电缆后反而恢复正常速度,这究竟是什么原因所致?这是在MSI Prestige RTX Spark等最新AI笔记本电脑上使用Linux时实际报告的一种反常现象。MindStudio.ai在同一设备上进行多操作系统直接对比后发现,原生Linux在充电状态下的推理性能仅为13.9 tokens/秒(即每秒生成的token数量。token是将文本切分为便于分析的微小文字单位),而Windows和WSL(Windows Subsystem for Linux)分别录得65.4和65.1 tokens/秒,两者速度几乎一致 1。温度处于40至47°C的较低区间,因此并非因过热导致的降频现象(即节流) 1。问题不在于硬件热量,而在于软件如何根据不同供电方式作出反应。
为何选择Linux运行AI笔记本电脑,以及RTX Spark这一存在
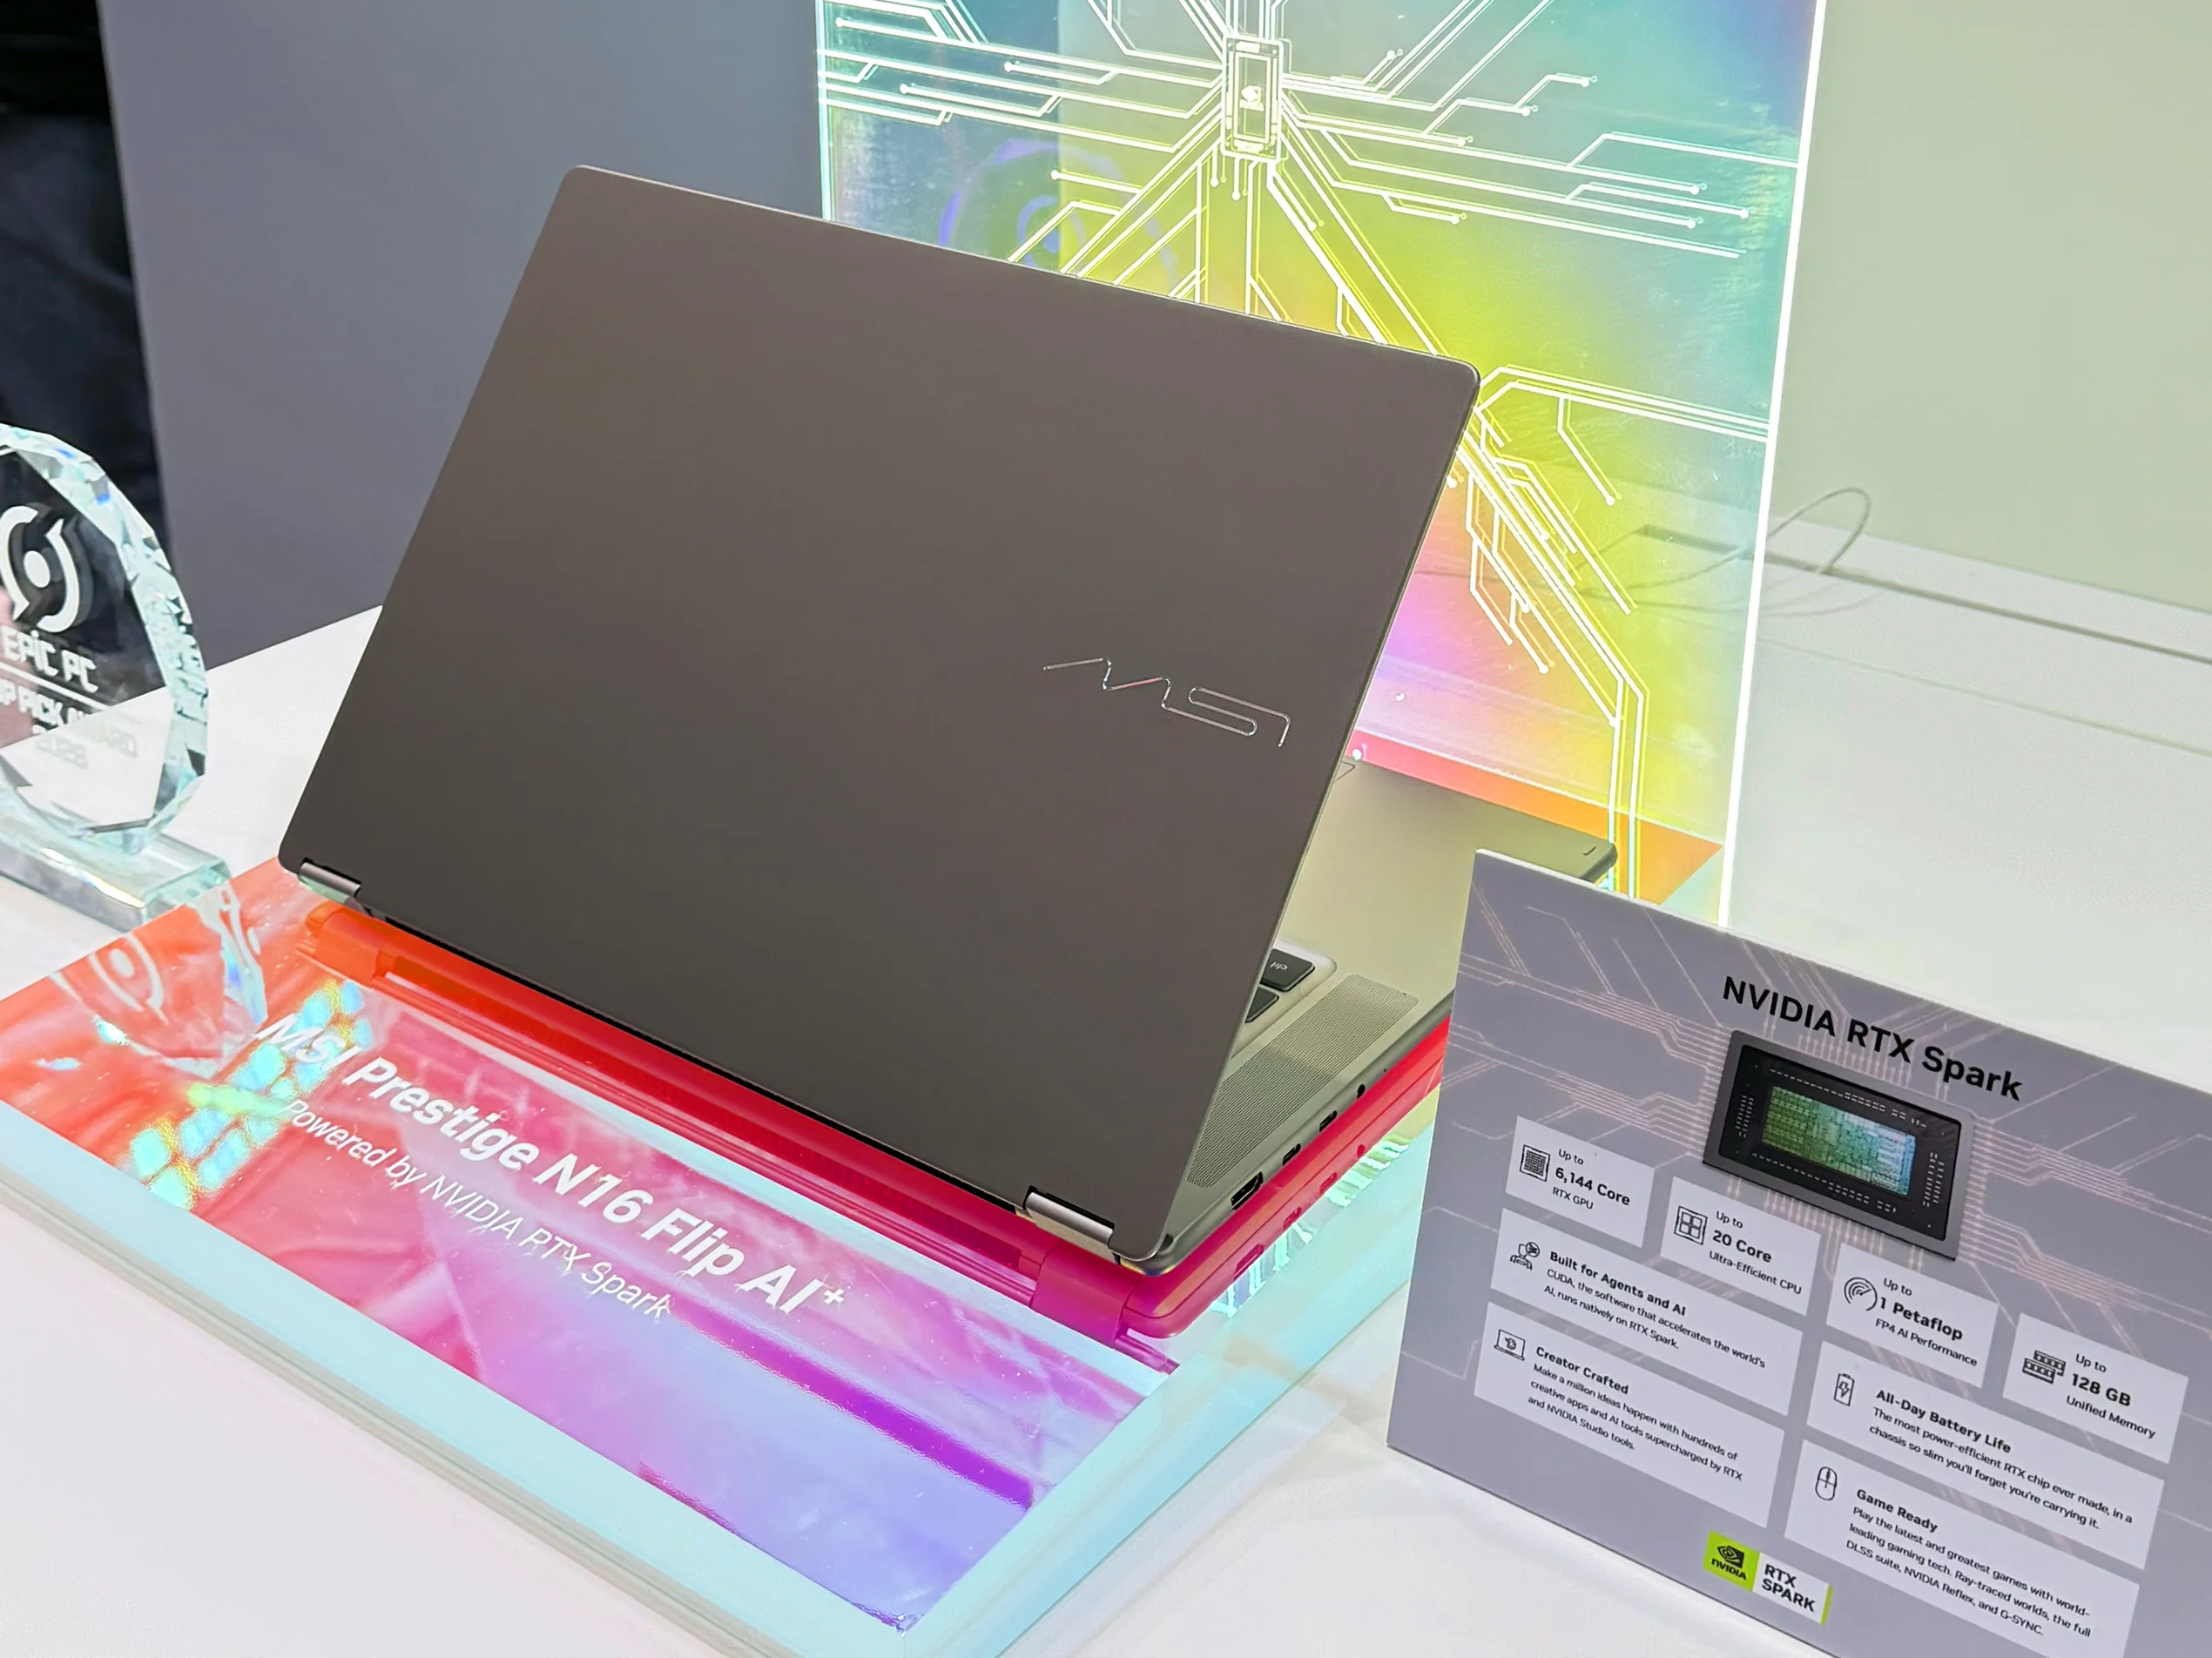
RTX Spark是将用于DGX Spark台式机设备的GB10 GPU设计移植到笔记本电脑的硬件平台。它搭载于MSI Prestige、Asus ProArt、Dell XPS等产品系列中,具备CPU与GPU最高共享128GB内存的统一内存架构 1。由于能够像使用单一整体一样利用如此大的内存,希望在本地运行千亿参数级等大语言模型的开发人员对该设备尤为关注。然而,这些设备出厂时预装的是基于ARM的Windows操作系统 1。
问题出在AI工具生态上。像vLLM或SGLang这类在实际AI推理中广泛使用的工具,通常优先针对Linux进行开发。在Linux上进行推理,是指用户提出问题后,语言模型逐个生成token的计算过程。为了毫不迟延地处理这项任务,GPU需要以高速(时钟频率)持续进行计算。因此,这些笔记本电脑用户在保留Windows的同时,尝试安装Linux,实施双系统启动(即在一台设备上可同时选择两个操作系统的方式) 1。MindStudio.ai的实验正是由此展开。
同一台笔记本电脑上显现的四种环境温度
MindStudio.ai在MSI Prestige RTX Spark上运行千亿参数模型(GPT-OSS-120B),测量了Windows、WSL和原生Linux这三种环境,并单独将Nvidia DGX Spark台式机对同一模型的推理速度作为比较基准列出。将结果整理成表格后,差异一目了然。
| 运行环境 | GPT-OSS-120B推理速度 | GPU时钟频率(充电状态) |
|---|---|---|
| Windows(笔记本电脑) | 65.4 tokens/秒 | 约2.2 GHz |
| WSL(笔记本电脑) | 65.1 tokens/秒 | — |
| DGX Spark(台式机) | 61 tokens/秒 | — |
| 原生Linux(笔记本电脑) | 13.9 tokens/秒 | 约780~790 MHz |
[表格来源:1]
在同一台笔记本电脑的原生Linux环境中,速度唯独降至13.9 tokens/秒,比其他环境慢约5倍 1。这种差距也可以通过其他方式重现。在使用vLLM同时处理8个请求的实验中,WSL录得127 tokens/秒,而原生Linux仅录得39.5 tokens/秒 1。从耗时来看,Windows约需8分钟,而Linux需要37分钟,在此期间GPU在Windows中维持在约2.2 GHz,在Linux中仅维持在约790 MHz 1。
最引人注目的是,情况在此处发生了逆转。当拔掉笔记本电脑的电源插头改用电池供电时,Linux环境中的GPU时钟频率升至约1,800 MHz,恢复到接近Windows的速度 1。使用LM Studio程序确认,电池状态下的推理速度为61至67 tokens/秒,而在接通电源的情况下进行相同测试,速度则骤降至15 tokens/秒附近 1。换言之,充电器本身并非性能的“敌人”,而是只有在连接充电器这一特定条件下,问题才会显现出来。
原因是分配“电力预算”的Windows专用组件
解开这一悖论的线索,可以在Windows设备管理器中确认为“Nvidia Platform Controllers and Framework”这一软件组件。台式机DGX Spark只需向GPU单独供电即可,但笔记本电脑不同。由于集成在同一机身内的CPU和GPU必须共享固定的电力预算,因此需要一个协调者,实时调整向哪一侧输送多少电力 1。Platform Controllers and Framework(硬件ID为ACPI\NVDA0820)正是这一协调者 2。
MindStudio.ai在Windows上对该协调者进行了关闭的对照实验。结果推理速度从83 tokens/秒降至约31,时钟频率从2 GHz跌至786 MHz,完美复现了Linux充电状态下的瓶颈。重新开启后,速度立即恢复正常 1。也就是说,原因既不是内核,也不是发行版,更不是GPU驱动程序本身,而确实就是这个单一组件。
为什么在Linux中这一协调者表现得如同故障一般?协调者要分配电力,必须读取固件(嵌入硬件中的底层程序)提供的“电力配置表”。然而,这张表是加密的。Windows拥有解密这张表的钥匙(解密密钥),但当前的Linux驱动并不具备该钥匙,因此无法解析这张表 1。由于缺乏钥匙,在必须重新计算电力分配的充电状态下,系统无法发出指令让GPU以全速运行,导致时钟频率被限制在约780 MHz。在实验过程中,尝试了多种软件层面的规避方法,但均以失败告终,其中一次尝试甚至引发了内核崩溃(操作系统停止响应的现象) 1。此外,关于Nvidia为何加密该表,社区中同时存在“保护知识产权”的解释与“刻意绑定Windows”的批评,究竟哪一方属实,目前尚未经由实验证实 3。
目前最现实可用的答案是WSL
在Nvidia将此电源管理逻辑移植到Linux驱动,或公布解密密钥之前,WSL(Windows Subsystem for Linux)实际上是唯一的替代方案 1, 3。WSL是在Windows内部叠加运行Linux环境的方式,因此可以直接继承Windows原本拥有的GPU加速(提升时钟频率的行为)。正因如此,无论是接通电源还是使用电池供电,都可在不降频的情况下运行vLLM等优先针对Linux优化的AI工具 1。
不过,ArchWiki单独警告称,GSP固件在部分搭载Ampere GPU的笔记本电脑上可能导致完全失败,因此驱动配置需要根据各自的硬件进行个别确认 4。
综上所述,在RTX Spark笔记本电脑上Linux推理速度骤降的现象,并非由“热量”或“硬件缺陷”所致,而是源于缺乏解密密钥来解析加密电力配置表的Linux驱动的局限性 1。并非充电电缆本身削减了性能,而是只有在接通电源、必须重新计算CPU与GPU之间电力分配的特定时刻,这一缺失才会显现出来。此结论是在MSI Prestige RTX Spark上运行GPT-OSS-120B的原生Linux组合中验证得出的,在Nvidia将相同的电源管理逻辑添加到Linux驱动之前,通过WSL在Windows驱动栈上获取完整速度,是目前最为稳妥的选择。
参考资料
- Linux on the Nvidia RTX Spark Laptop: What Actually Works · mindstudio.ai↩
- ↩
- Nvidia RTX Spark encrypted firmware slows inference speed to 35% on Linux | Hacker News · news.ycombinator.com↩
- NVIDIA - ArchWiki · wiki.archlinux.org↩



