重写遗留系统风险重重,但放任不管则会付出更高昂的代价。马丁·福勒(Martin Fowler)提出的“绞杀者模式(Strangler Pattern)”已成为解决这一两难困境的标准策略。该模式灵感源自2001年在澳大利亚昆士兰热带雨林中观察到的绞杀榕缠绕宿主树生长的现象,作为一种逐步替换现有系统的方法论,其修订版已于2024年8月发布123。
截至2026年,该模式已超越纯粹的理论范畴,演变为在大规模企业环境中实现零停机过渡,并与AI自动化工具相结合的技术方案。本文将探讨绞杀者模式的核心机制及实际案例,分析数据一致性、临时基础设施永久化、分布式单体等可能导致项目失败的主要陷阱,并提供规避这些陷阱的实战策略。
核心机制:通过门面(Facade)进行流量路由
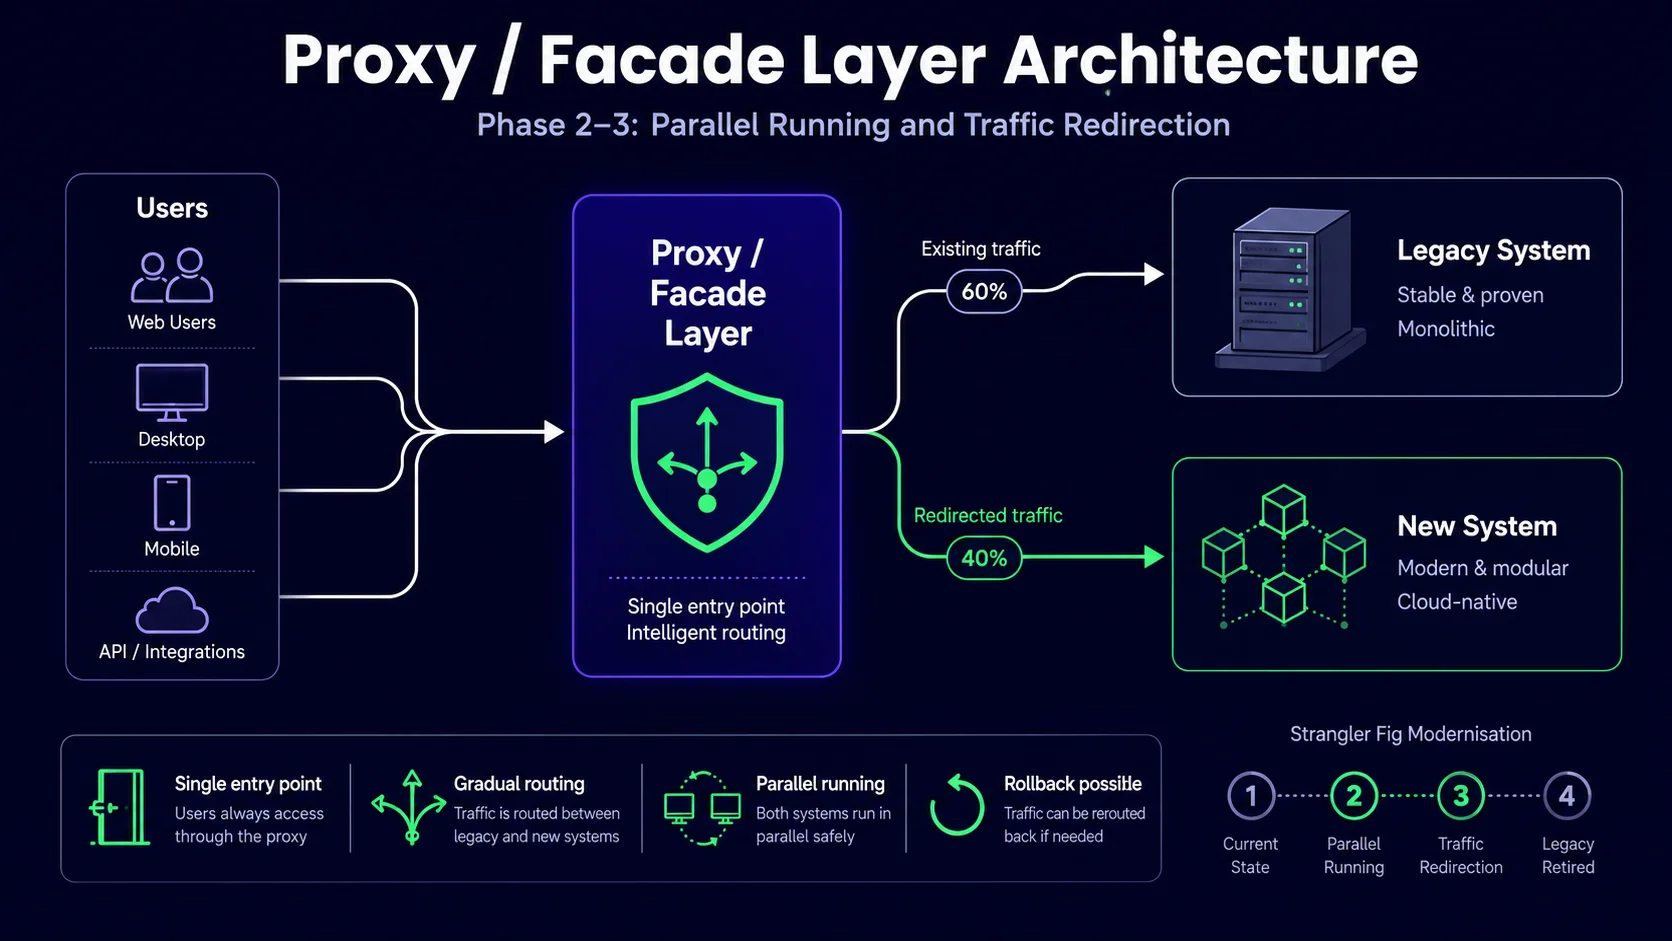
绞杀者模式的运作原理在于在遗留系统与新系统之间部署“门面(Facade)或代理”,以智能方式路由请求145。初始阶段,将100%的流量发送给遗留系统,但将新开发的功能发送至新系统。
典型执行步骤包括利用NGINX或AWS API Gateway等代理拦截流量,按领域提取新的微服务以逐步替代遗留系统5。当新服务能够稳定处理流量后,采用金丝雀(Canary)路由方式,从5%开始逐步提高流量比例进行验证5。同时,建议采用防腐层(anti-corruption layer)以确保新系统不会继承遗留系统的结构性缺陷4。
若该过程顺利实施,遗留系统将逐渐失去功能,如同一棵被掏空的“宿主树”。最终,当遗留系统的所有功能迁移完毕后,移除原系统及门面本身,从而完成现代化改造4。
大规模迁移案例与组织连续性
在实际应用中,组织的持续所有权(Continuous Ownership)与技术实现同等重要。英国政府数字服务局(GDS)利用名为“Bouncer”的路由门面,在约15个月内将300多个机构网站整合到一个平台(GOV.UK)上2。该项目得以成功完成的关键在于,其设计确保各部门始终承担并负责自身的职责直至结束2。
往往决定成败的并非技术难题,而是组织能力。若迁移开始三个月后负责人被调往其他项目,这是项目可能无法完结的危险信号;若门面正在路由超过50%的生产流量,则表明其已固化为“第二个遗留系统”2。
eBay在架构重构时,首先从高盈利领域开始进行试点项目,以最小化风险,从而实现了单体系统的渐进式解耦和松散耦合3。eBay保留现有服务的API,同时将新功能实现在新架构中,从而在持续利用已部署系统的同时,确保了迁移过程可随时暂停的灵活性3。
零停机过渡的技术架构:28个月的记录
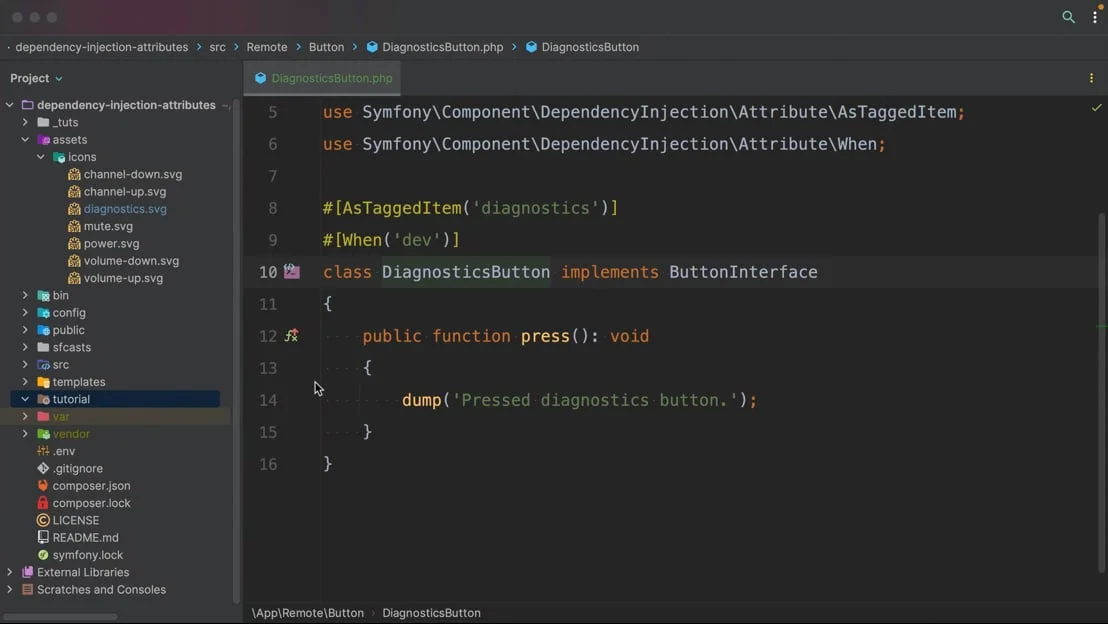
2025年12月报告的一个电商平台案例展示了渐进式替换的具体技术策略。在从Magento 1迁移到Sylius的过程中,开发团队应用了基于Symfony接口的抽象层,在28个月内零停机地替换了7个后端API6。关键在于将控制器设计为仅依赖接口而非具体实现,从而只需修改依赖注入配置即可实现后端替换及即时回滚6。
在必须仅替换后端而无需修改前端的情况下,结合使用BFF(Backend-for-Frontend,前端专用后端)模式与绞杀者模式是有效策略7。BFF负责吸收客户端与实际服务之间复杂的“适配器地狱(Adapter Hell)”,从而允许在不修改前端代码的情况下,将后端内部转换为微服务7。
在性能优化方面,也有案例显示,通过实施与令牌过期时间(60分钟)匹配的59分钟缓存,将会话期间原本每数百次发生一次的认证开销大幅降低至每小时约一次6。该架构遵循渐进增强的原则,使得即使禁用JavaScript也能完成购买6。
陷阱1:数据一致性及双写的陷阱
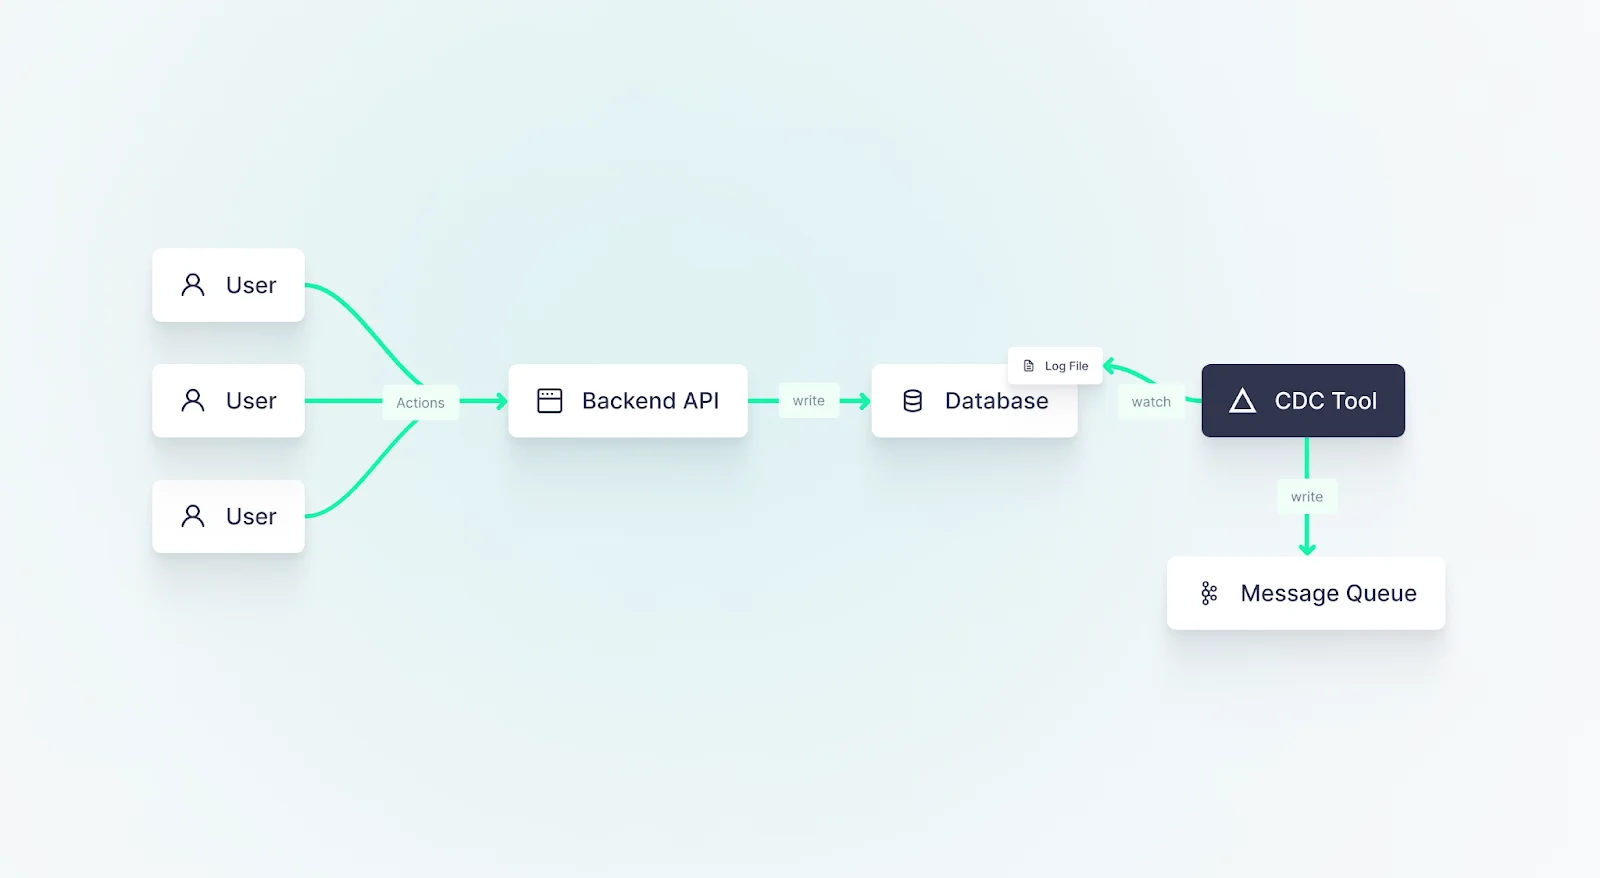
最致命的失败因素之一,是当遗留系统与新系统各自拥有独立数据库时引发的数据一致性问题258。尽管Debezium或基于Kafka的CDC(变更数据捕获)技术被广泛使用,但AWS将其定义为“战术性解决方案”,指出其无法保证完全同步,并可能导致最终一致性(Eventual Consistency)状态258。
Accesto的实践案例很好地说明了这一问题。在一个耗时3年的SaaS应用程序现代化过程中,为了快速验证,新系统遗留系统共享单一数据库,但这几乎是一种反模式8。这是因为数据模型边界变得模糊,引发了不必要的依赖,且原有表结构阻碍了新系统的优化8。在进行大规模数据迁移时,应利用功能标志(Feature Flag)构建可立即回滚的环境,以避免直接读取遗留数据库表5。
陷阱2:临时基础设施的永久化
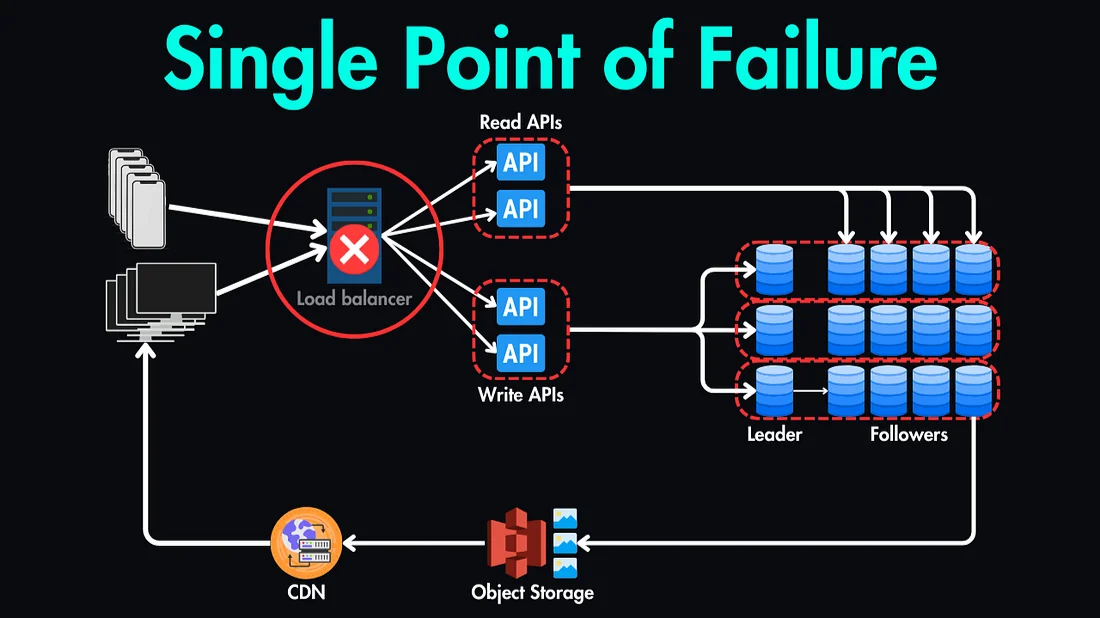
迁移过程中使用的临时基础设施(Transitional Architecture)发生永久化,也是常见的陷阱24。门面和代理层起初作为系统的接缝(seam),不可或缺,但它们不应成为性能瓶颈或单点故障(SPOF)24。若迁移完成后不拆除了门面,最终将面临需要同时维护两个系统的最糟糕场景4。
为防止此类现象,从一开始进行系统设计时就应考虑到让门面具备分布式处理能力,以避免其成为单点故障,并需要有明确的终止计划24。此外,在大规模环境中,还应对网络隔离和延迟采取应对措施,配套设置断路器及速率限制5。
陷阱3:领域边界划分失败与分布式单体
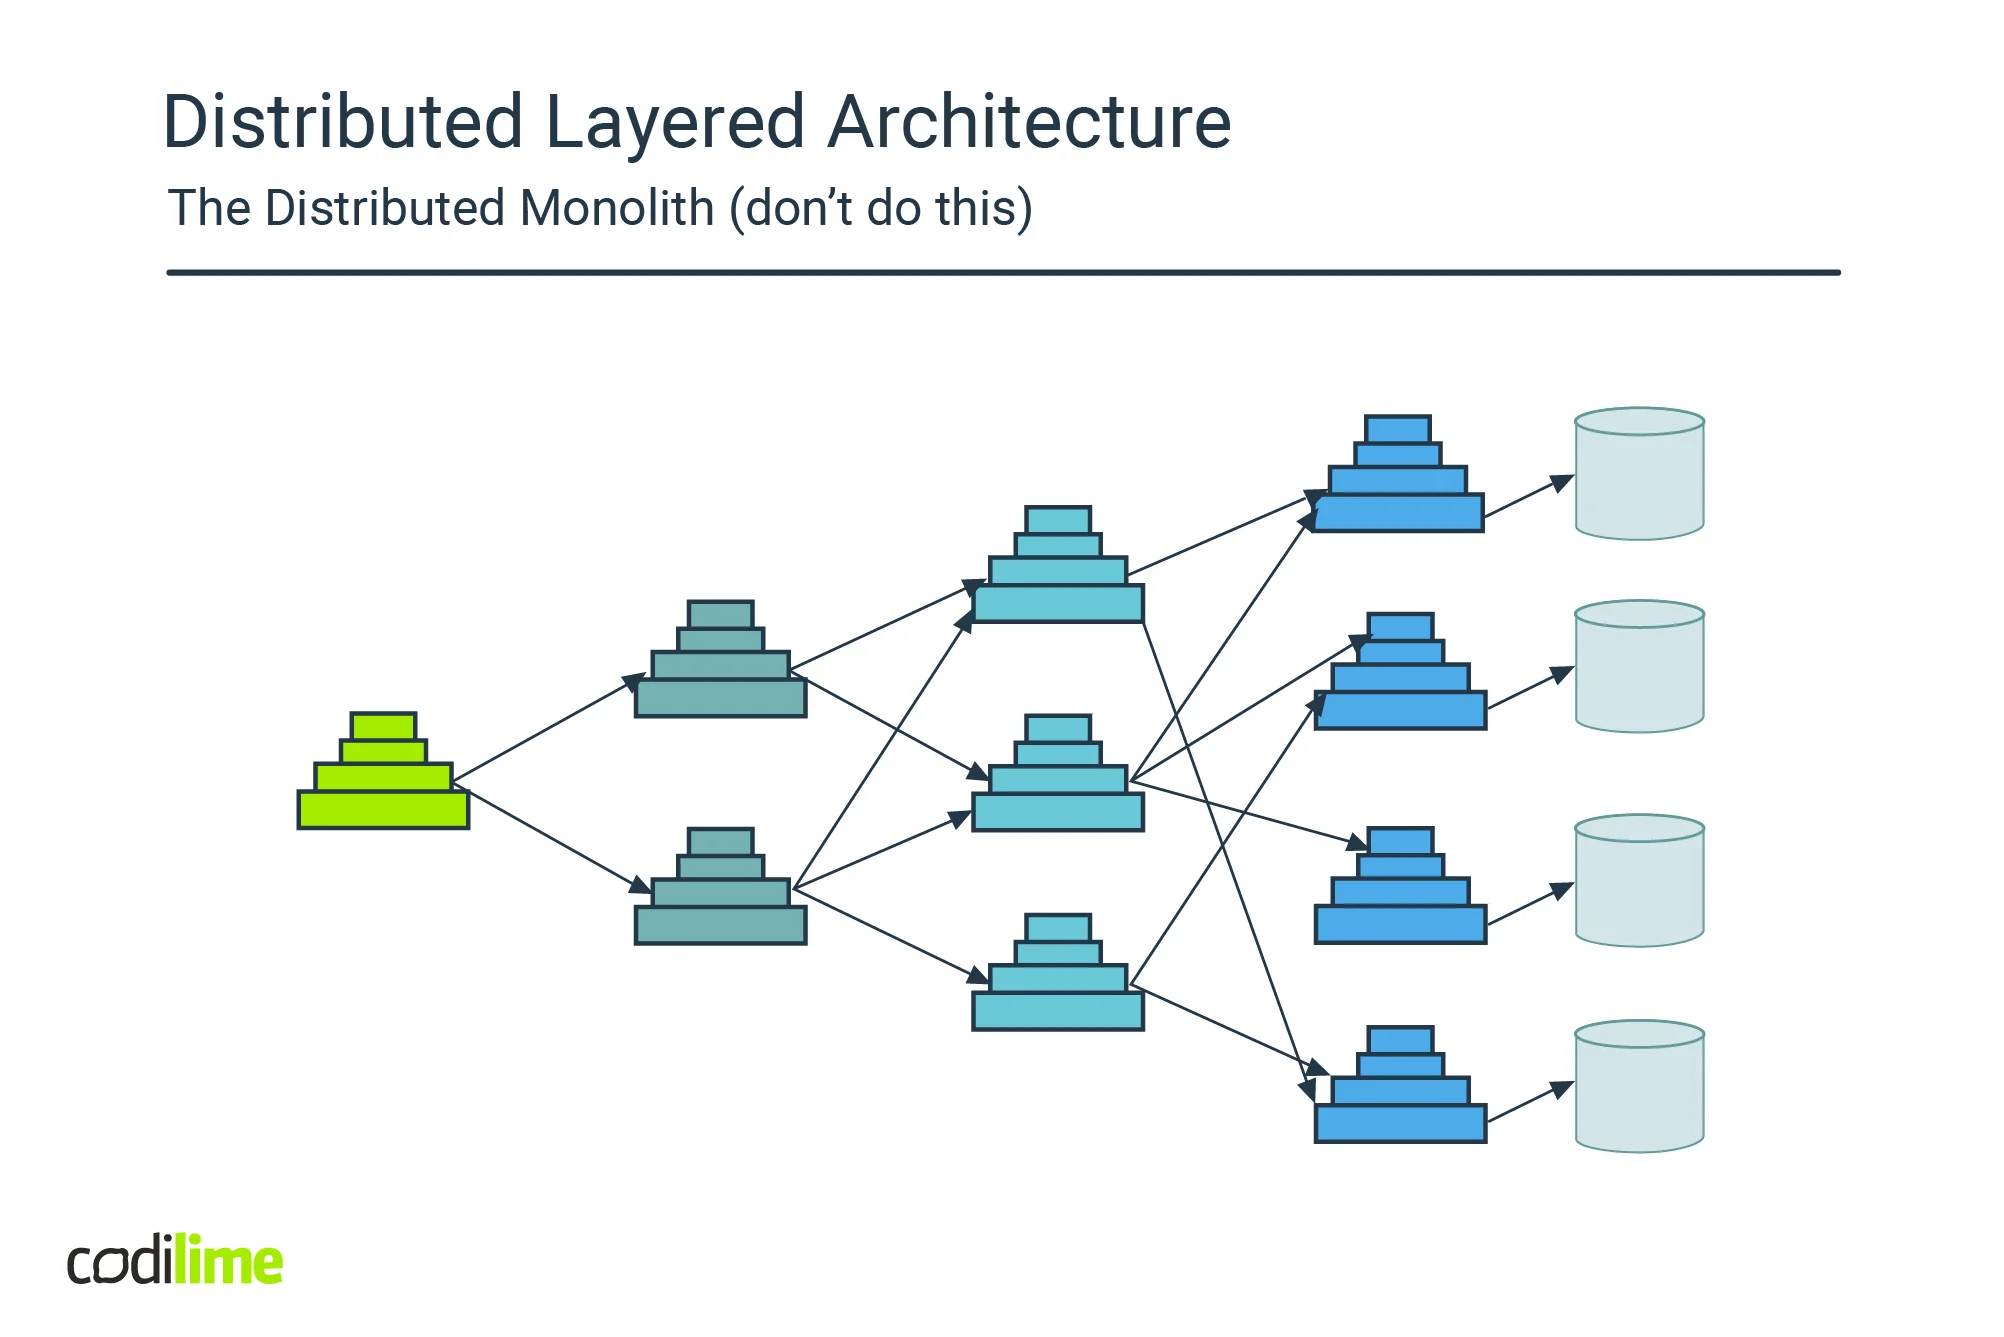
错误的领域边界划分会导致“分布式单体”的产生。多个微服务必须不断相互通信才能正常工作的状态,意味着物理上分布式、但逻辑上仍是单体的结构2。为避免这种情况,AWS建议通过领域驱动设计(DDD)和事件风暴(Event Storming)提前识别真正的边界2。
若无法明确界定边界,将导致数据管道不一致和级联延迟,进而迫使采取扩展前端副本并阻断下游调用等应对策略5。利用死信队列(DLQ)隔离错误载荷,也已确立为一种管理分布式系统复杂性副作用的实战技术5。
2026年的变数:AI代理与量化优先级
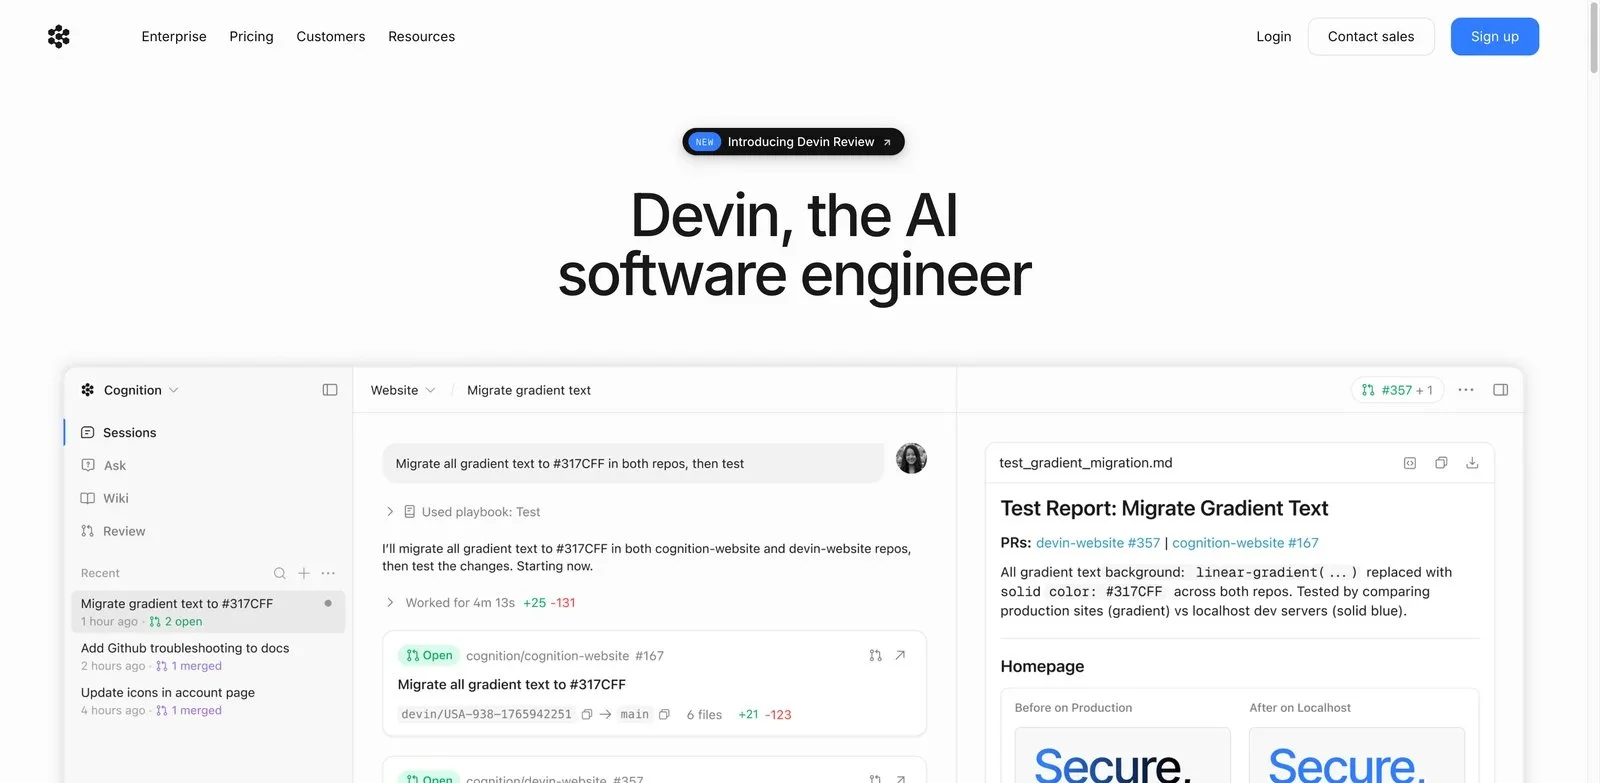
2026年迁移环境中最大的变化之一,是引入AI自主编码代理。梅赛德斯-奔驰利用AI将原本需8个月的遗留代码库迁移工作缩短至8天,Nubank则使规模达610万行代码的迁移成本降低了20倍9。在解决重复性技术债务或更新依赖项方面,AI在假定有人工判断和PR审查的前提下,展现出高度专业化的能力9。
在确定迁移优先级时,基于量化指标而非“技术偏好”才能最大化ROI10。优先处理bug率高(Bug Rate)、代码质量差、变更频率高(Churn Rate)的模块是最具效率的策略10。在从Angular迁移到React的案例中,实施了严格的质量门控,先编写E2E测试以确保功能等效性,然后再进行部署10。
2026年的绞杀者模式,是在过去渐进式替换原理的基础上,结合AI的自动化处理能力以及基于量化数据的战略性路由,呈现出一种高度进化的形态109。最终目标是新系统能够独立生存,而为了实现这一目标,需要具备关于数据一致性的冷静设计,以及移除临时基础设施的勇气34。
参考资料
- Strangler Fig · martinfowler.com↩
- Strangler Fig: 6 Signals It's Not Finishing - Growin · growin.com↩
- 교살자 패턴, 스트랭글러 패턴 (strangler pattern) - 기계인간 John Grib · johngrib.github.io↩
- Strangler Fig (pattern) - Tech Dictionary | Nextsoft Corp · nextsoftcorp.com↩
- ↩
- Strangler Pattern Symfony Migration Case Study · edmondscommerce.co.uk↩
- Refactoring Monoliths to Microservices with the BFF and Strangler... · wundergraph.com↩
- Strangler Pattern in practice | Accesto Blog · accesto.com↩
- 8개월 레거시 마이그레이션을 AI가 8일에 끝낸다 — Devin, 자율 AI... · working-ref.com↩
- Angular 1에서 React로 — Strangler 패턴으로 1년간 점진적... · tera-log.pages.dev↩