La reescritura completa de los sistemas legacy es arriesgada, pero su abandono exige costes aún mayores. El 'Patrón Strangler (Strangler Pattern)', propuesto por Martin Fowler, se ha consolidado como la estrategia estándar para resolver este dilema. Inspirado en la observación de la higuera estranguladora envolver y crecer alrededor de un árbol anfitrión en la selva tropical de Queensland (Australia) en 2001, este patrón, que ofrece una metodología para sustituir progresivamente los sistemas existentes, publicó una versión revisada en agosto de 2024123.
A día de 2026, este patrón evoluciona más allá de una simple teoría, integrando la migración sin interrupciones en entornos empresariales a gran escala y su combinación con herramientas de automatización basadas en IA. En este artículo, analizaremos los mecanismos centrales del Patrón Strangler y sus casos de aplicación reales, examinando las principales trampas que pueden llevar al fracaso del proyecto —como la consistencia de datos, la perpetuación de la infraestructura temporal y los monolitos distribuidos—, así como las estrategias prácticas para evitarlas.
Mecanismo clave: el enrutamiento de tráfico a través de una fachada (Facade)
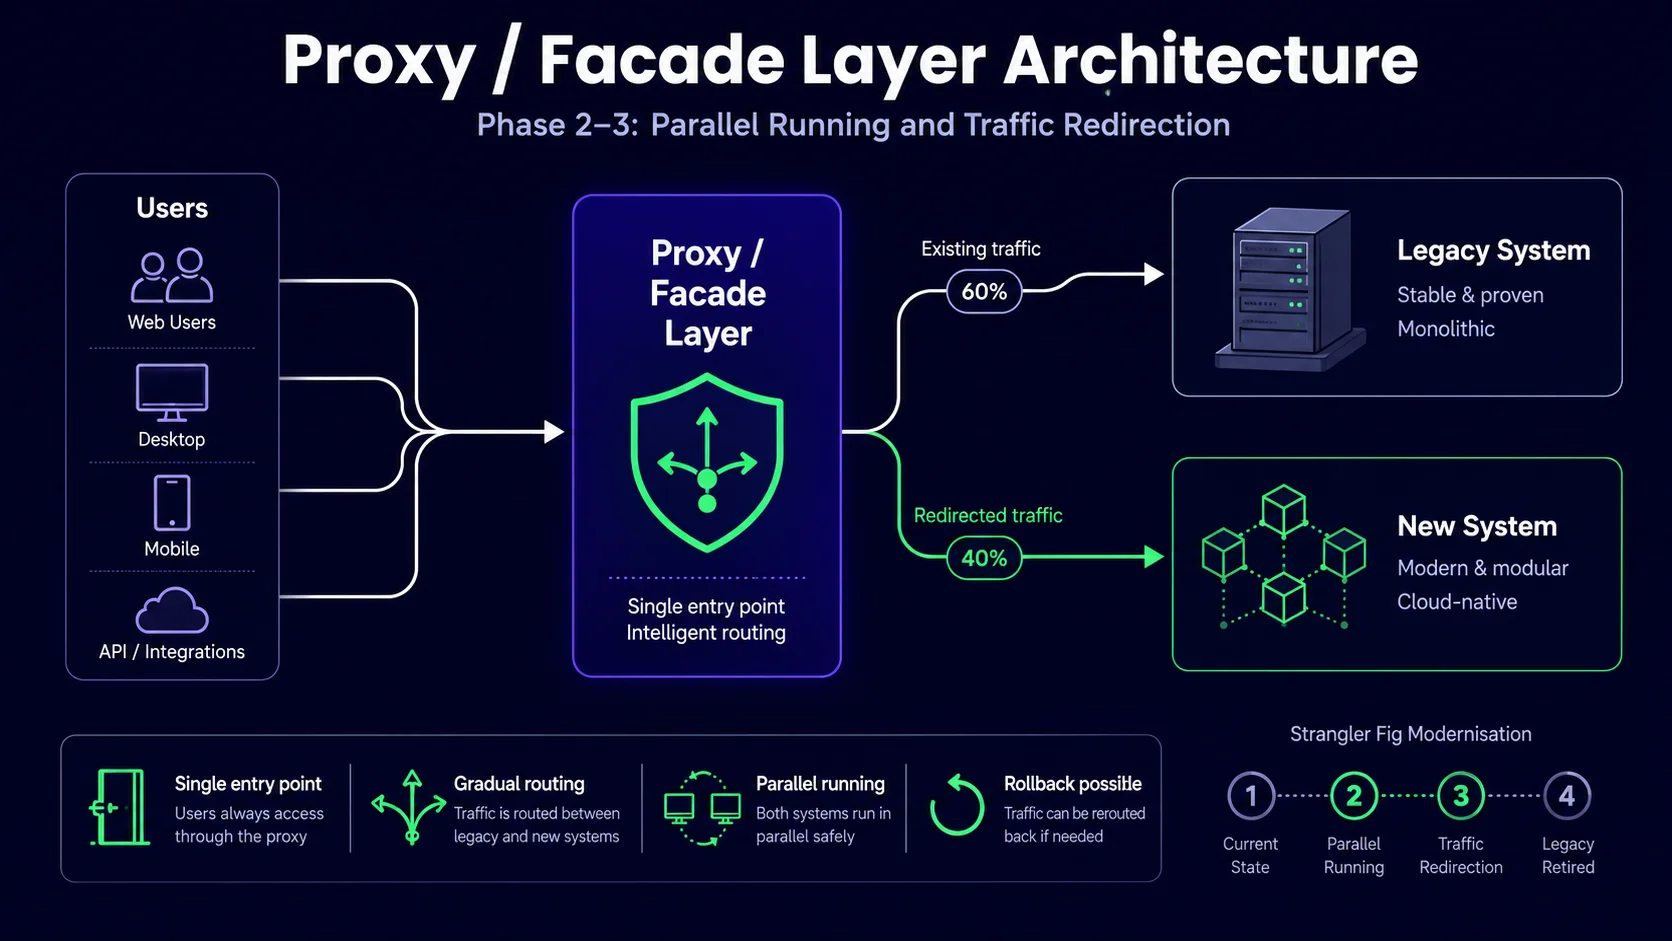
El funcionamiento del Patrón Strangler se basa en desplegar una 'Fachada (Facade) o proxy' entre el sistema legacy y el nuevo sistema para enrutar las solicitudes de manera inteligente145. En las primeras etapas, el proceso comienza enviando el 100 % del tráfico al sistema legacy, mientras que las nuevas funcionalidades desarrolladas se envían al nuevo sistema.
Los pasos típicos de ejecución incluyen interceptar el tráfico utilizando proxies como NGINX o AWS API Gateway, extraer nuevos microservicios por dominio y sustituir gradualmente el sistema legacy5. Una vez que el nuevo servicio procesa el tráfico de manera estable, se valida incrementando progresivamente su porcentaje de tráfico, comenzando por un 5 %, mediante enrutamiento canario (Canary routing)5. También se recomienda aplicar una capa anti-corrupción (anti-corruption layer) para evitar que el nuevo sistema herede las deficiencias estructurales del legacy4.
Si este proceso se lleva a cabo con éxito, el sistema legacy se vacía gradualmente, perdiendo funcionalidades, al igual que el 'árbol anfitrión'. Finalmente, cuando todas las funciones del sistema legacy han sido migradas, se elimina tanto el sistema antiguo como la propia fachada, completando así la modernización4.
Casos de migración a gran escala y continuidad organizativa
En la aplicación práctica, la propiedad continua (Continuous Ownership) por parte de la organización es tan importante como la implementación técnica. Government Digital Service (GDS) del Reino Unido logró integrar más de 300 sitios web institucionales en una única plataforma (GOV.UK) en aproximadamente 15 meses, utilizando una fachada de enrutamiento denominada 'Bouncer'2. La clave del éxito de este proyecto radicó en un diseño que aseguraba que cada departamento mantuviera la responsabilidad de sus servicios hasta el final2.
Frecuentemente, la capacidad organizativa, más que los desafíos técnicos, es lo que determina el éxito o el fracaso. Si tres meses después de iniciar la migración el responsable es reasignado a otro proyecto, esto constituye una señal de alerta de que el proyecto podría no completarse nunca; asimismo, si la fachada está enrutando más de la mitad del tráfico de producción, es un indicador de que se ha consolidado como un 'segundo sistema legacy'2.
eBay minimizó los riesgos durante el rediseño de su arquitectura ejecutando proyectos piloto en las áreas más rentables, logrando así una separación progresiva del sistema monolítico y un acoplamiento débil3. En el caso de eBay, se mantuvieron las API de los servicios existentes mientras que las nuevas funcionalidades se implementaban en la nueva arquitectura, lo que permitió seguir utilizando los sistemas desplegados y asegurar la flexibilidad para pausar la migración si fuera necesario3.
Arquitectura técnica para la migración sin interrupciones: el registro de 28 meses
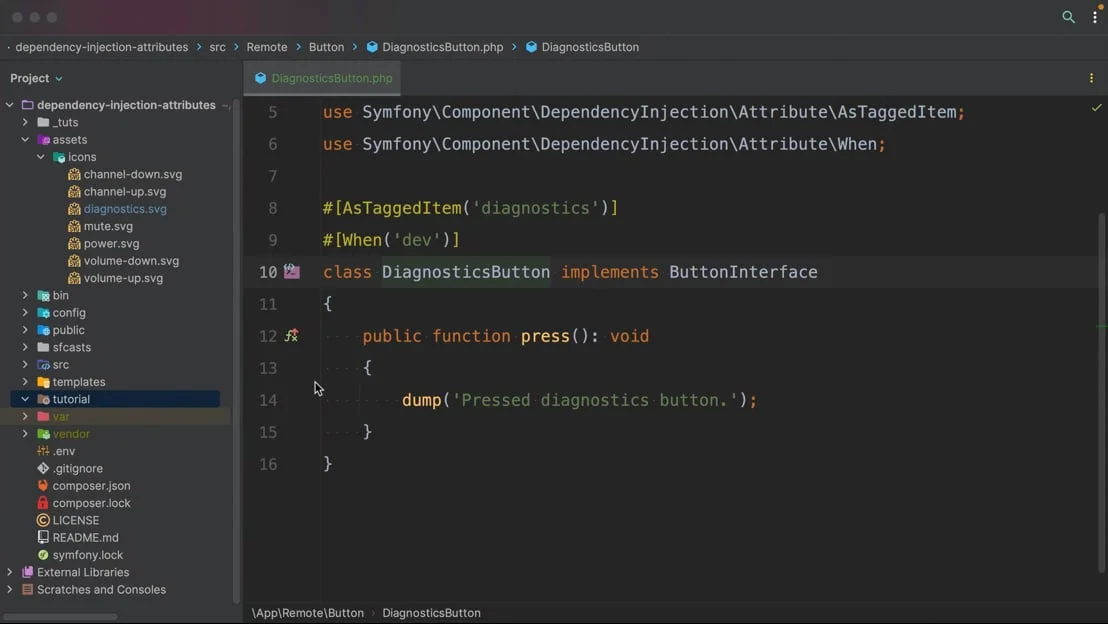
Un caso de una plataforma de comercio electrónico reportado en diciembre de 2025 ilustra las estrategias técnicas concretas de la sustitución gradual. Durante la migración de Magento 1 a Sylius, el equipo de desarrollo aplicó una abstracción basada en interfaces de Symfony para sustituir sin interrupciones 7 APIs de backend durante 28 meses6. El factor crucial fue diseñar los controladores para que dependieran únicamente de interfaces y no de implementaciones, permitiendo así la sustitución del backend y el rollback inmediato mediante meros cambios en la configuración de la inyección de dependencias6.
En situaciones donde es necesario sustituir únicamente el backend sin modificar el frontend, la combinación de los patrones BFF (Backend-for-Frontend) y Strangler resulta efectiva7. Al absorber el 'infierno de adaptadores' (Adapter Hell) entre el cliente y los servicios reales, la capa BFF permite transformar el interior del backend a microservicios sin requerir cambios en el código del frontend7.
En cuanto a la optimización del rendimiento, se identificó un caso en el que la sobrecarga de autenticación, que se producía cientos de veces por sesión, se redujo drásticamente a una vez por hora mediante un caché de 59 minutos ajustado al tiempo de expiración de los tokens (60 minutos)6. Esta arquitectura siguió el principio de mejora progresiva (progressive enhancement), permitiendo la realización de compras incluso con JavaScript desactivado6.
Trampa 1: trampas de la consistencia de datos y la doble escritura
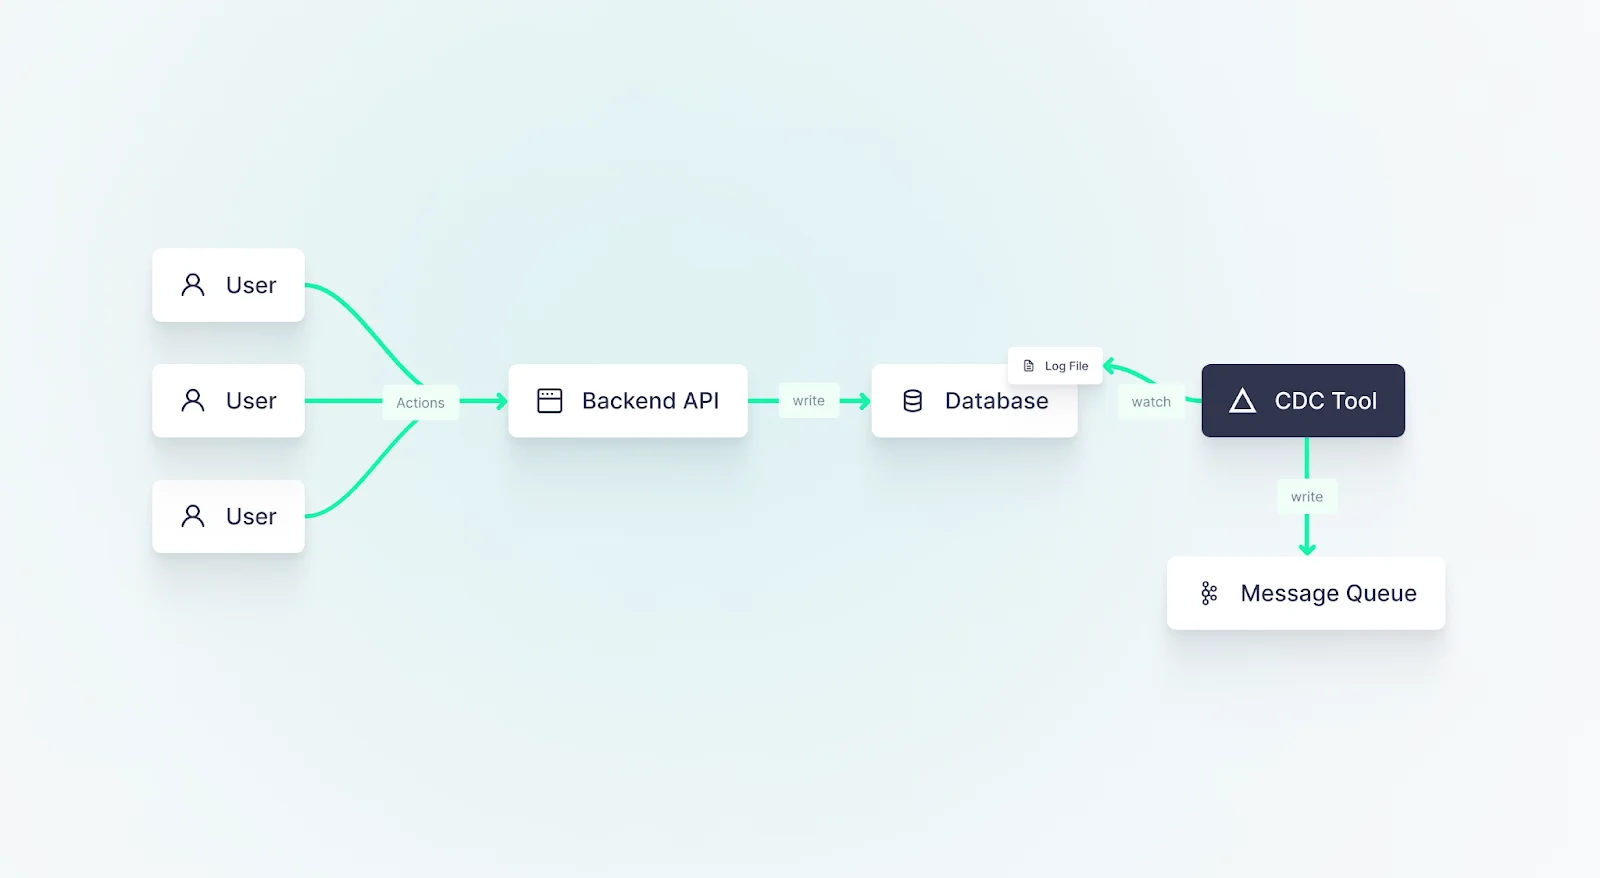
Uno de los factores de fallo más críticos es el problema de la consistencia de datos que surge cuando los sistemas legacy y los nuevos poseen bases de datos independientes258. Aunque tecnologías de CDC (Change Data Capture) basadas en Debezium o Kafka están ampliamente extendidas, AWS las define como una 'solución táctica', advirtiendo que no garantizan una sincronización completa y pueden derivar en un estado de consistencia eventual (Eventual Consistency)258.
El caso práctico de Accesto ilustra bien esta problemática. Durante tres años de modernización de una aplicación SaaS, la nueva aplicación y la legacy compartían una base de datos única para agilizar la validación, lo cual rozaba el antipatrón. Ello provocó fronteras difusas en el modelo de datos, generando dependencias innecesarias, y la estructura de las tablas existentes obstaculizó las nuevas optimizaciones88. Durante las migraciones de datos a gran escala, se deben utilizar feature flags para establecer un entorno con rollback inmediato que evite lecturas directas de las tablas de la base de datos legacy5.
Trampa 2: la perpetuación de la infraestructura temporal
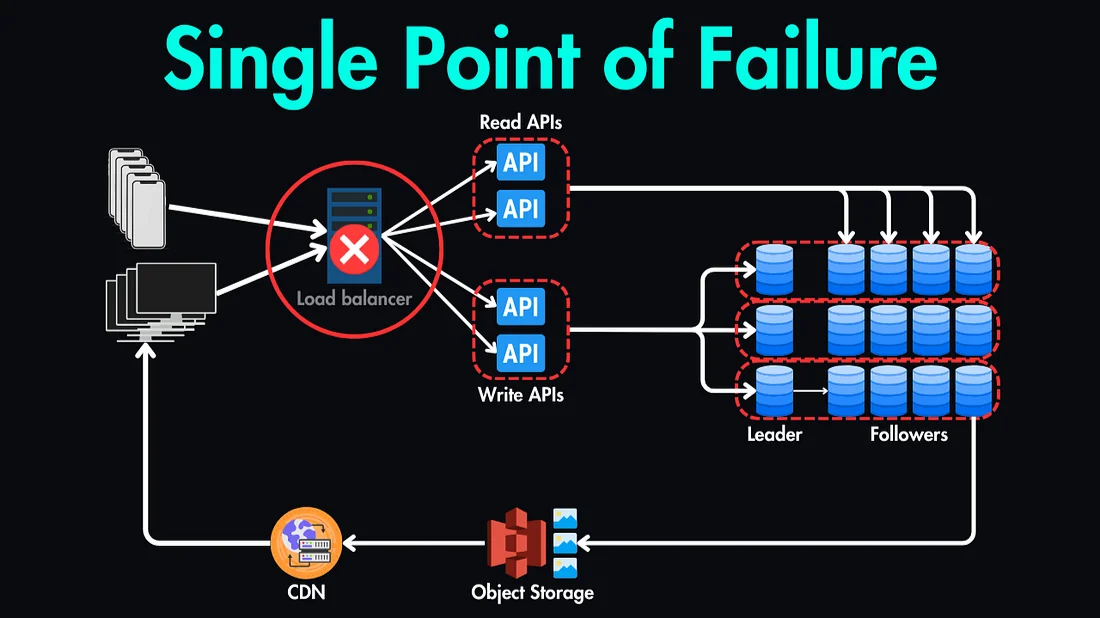
La perpetuación de la infraestructura temporal (Transitional Architecture) empleada durante la migración es otra trampa frecuente24. Las capas de fachada y proxy desempeñan inicialmente una función esencial como costuras del sistema, pero nunca deben convertirse en cuellos de botella de rendimiento ni en puntos únicos de fallo (SPOF)24. Si no se elimina la fachada al concluir la migración, se termina en el peor de los escenarios: un sistema compuesto por dos componentes que deben mantenerse simultáneamente4.
Para evitar esta situación, desde el diseño inicial del sistema se debe contemplar la capacidad de procesamiento distribuido para garantizar que la fachada no se convierta en un punto único de fallo, y es imprescindible contar con un plan claro de punto final24. Asimismo, en entornos a gran escala, es necesario configurar interruptores de circuito (circuit breakers) y limitadores de tasa (rate limiters) para anticipar fallos de red y latencias5.
Trampa 3: el fracaso en la definición de límites de dominio y los monolitos distribuidos
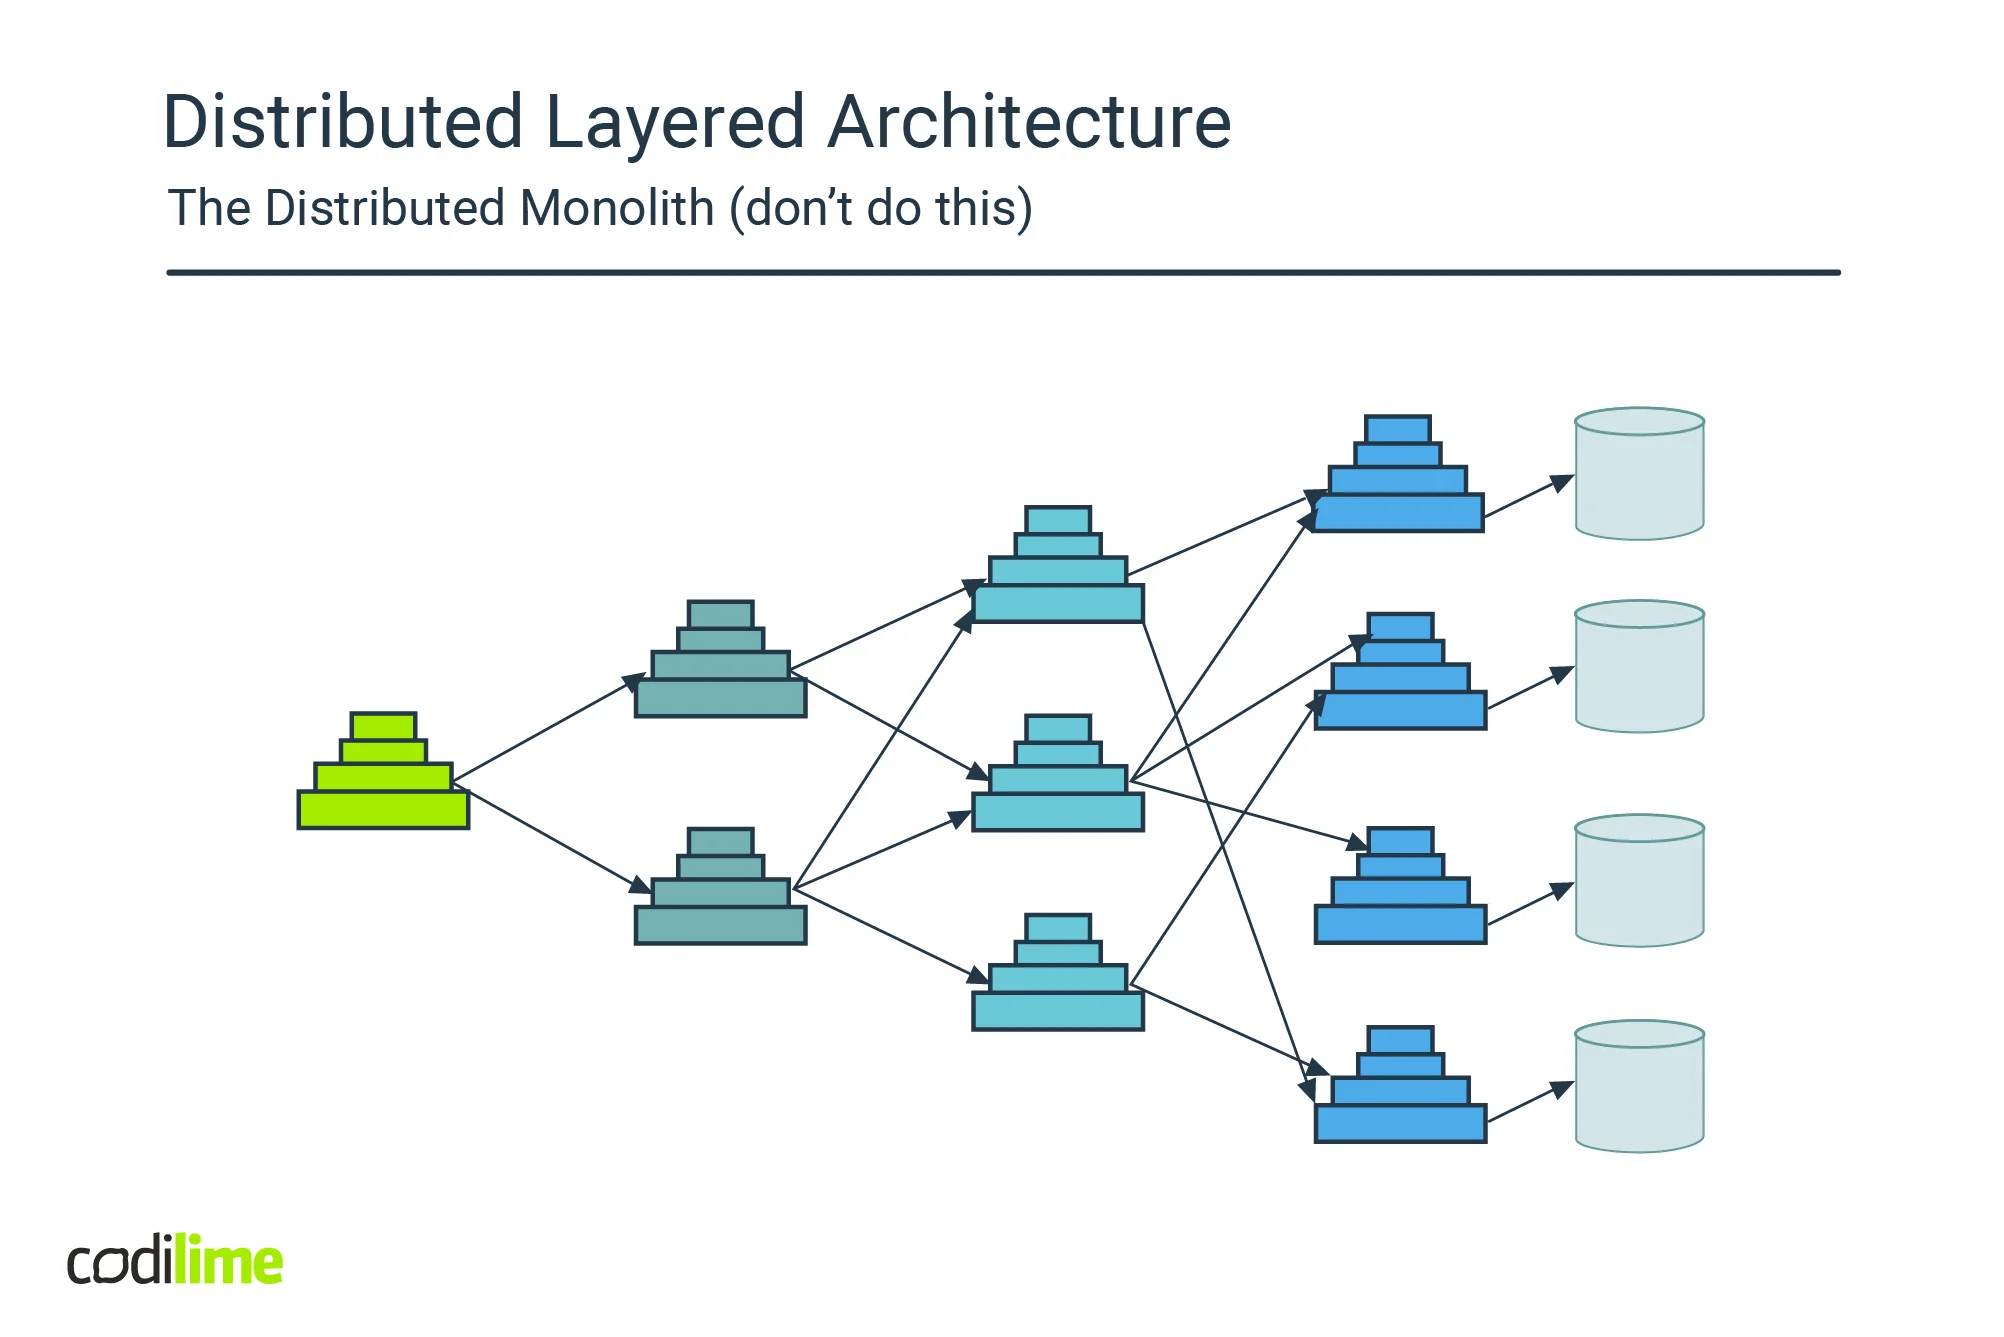
Una definición errónea de los límites de dominio da origen a 'monolitos distribuidos'. Se trata de una situación en la que varios microservicios solo funcionan correctamente si comunican constantemente entre sí, generando una estructura físicamente distribuida pero lógicamente monolítica2. Para prevenir esto, AWS recomienda identificar de antemano los límites reales mediante Domain-Driven Design (DDD) y Event Storming2.
Si los límites no se definen con claridad, surgen inconsistencias en los pipelines de datos y retardos en cascada (cascading delays), lo que obliga a aplicar medidas paliativas como la escalado de réplicas de frontend y el bloqueo de llamadas downstream5. El aislamiento de cargas útiles (payloads) defectuosas en colas de mensajes muertos (DLQ, Dead Letter Queue) se ha convertido también en una técnica práctica para gestionar los efectos secundarios derivados de la complejidad de los sistemas distribuidos5.
Los cambios de 2026: agentes de IA y priorización cuantitativa
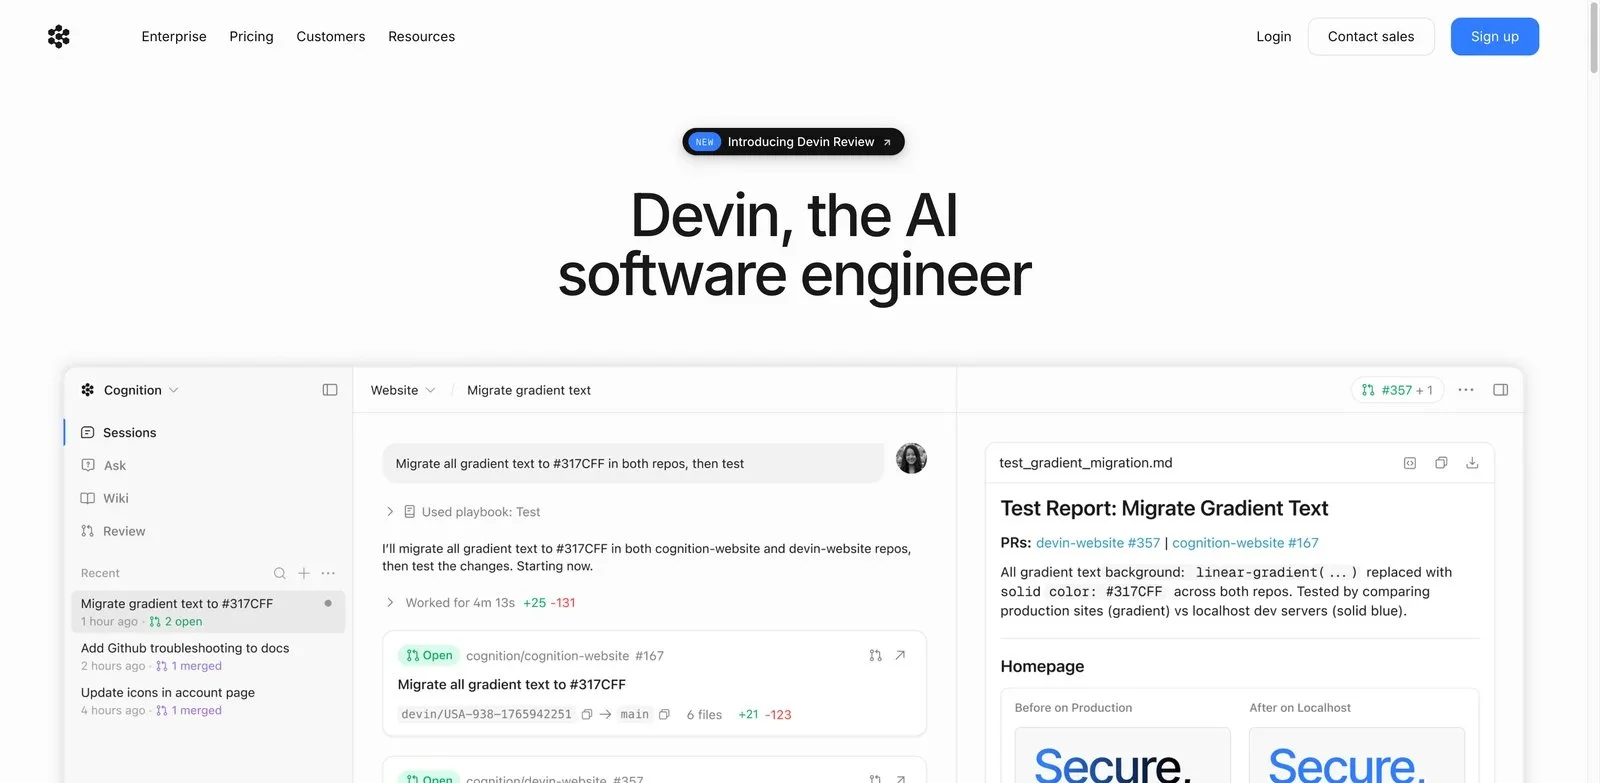
Uno de los cambios más significativos en el entorno de migraciones de 2026 es la adopción de agentes de codificación autónoma mediante IA. Mercedes-Benz redujo de 8 meses a 8 días la migración de su base de código legacy mediante IA, mientras que Nubank disminuyó en 20 veces el coste de migrar una base de código de 6,1 millones de líneas9. En la resolución de deuda técnica repetitiva o la actualización de dependencias, la IA demuestra capacidades muy especializadas, siempre asumiendo la intervención humana en la toma de decisiones y la revisión de PR (pull requests)9.
Al definir las prioridades de una migración, la maximización del ROI exige basarse en métricas cuantitativas por encima de las 'preferencias técnicas'10. La estrategia más eficiente consiste en procesar secuencialmente los módulos con tasas elevadas de bugs (Bug Rate), baja calidad de código y alta tasa de cambios (Churn Rate)10. En casos de transición de Angular a React, se aplicaron estrictos gates de calidad que garantizan la equivalencia funcional mediante la redacción anticipada de pruebas E2E antes del despliegue10.
En 2026, el Patrón Strangler adopta una forma avanzada que combina los principios históricos de sustitución gradual con la capacidad de procesamiento automatizado de la IA y un enrutamiento estratégico basado en datos cuantitativos109. La meta final es que el nuevo sistema sea la única plataforma operativa, lo cual requiere tanto un diseño riguroso de la integridad de los datos como la valentía para retirar la infraestructura temporal34.
Referencias
- Strangler Fig · martinfowler.com↩
- Strangler Fig: 6 Signals It's Not Finishing - Growin · growin.com↩
- 교살자 패턴, 스트랭글러 패턴 (strangler pattern) - 기계인간 John Grib · johngrib.github.io↩
- Strangler Fig (pattern) - Tech Dictionary | Nextsoft Corp · nextsoftcorp.com↩
- ↩
- Strangler Pattern Symfony Migration Case Study · edmondscommerce.co.uk↩
- Refactoring Monoliths to Microservices with the BFF and Strangler... · wundergraph.com↩
- Strangler Pattern in practice | Accesto Blog · accesto.com↩
- 8개월 레거시 마이그레이션을 AI가 8일에 끝낸다 — Devin, 자율 AI... · working-ref.com↩
- Angular 1에서 React로 — Strangler 패턴으로 1년간 점진적... · tera-log.pages.dev↩