在进行数据工程或 AI 项目时,你是否知道首先会遇到的墙是什么?那就是“非结构化数据”这座巨大的障碍。
PDF、Word、Excel,甚至是图像和音频……我们拥有的信息形式极其多样。然而,我们所处理的大语言模型(LLM)最“爱吃”的数据,正是整理得整整齐齐的“文本”。
为了填补这一鸿沟,无数开发者曾彻夜编写解析(Parsing)代码。但在 2026 年的今天,微软推出的 MarkItDown 这一个工具,就直接解决了这项枯燥的重复劳动。
2 周内获得 25,000 个 Star,为什么全世界的开发者都为之疯狂?
最近开源生态圈发生了一件轰动的事情。微软公开的基于 Python 的工具 MarkItDown,在发布短短 2 周内 GitHub Star 数便突破了 25,000 个,引发了爆发性的热度。
仅仅是因为“出了一个文件转换器”的消息吗?并不是。这个工具的核心在于超越了简单的转换,在于实现“AI 友好的数据结构化”。
我们通常为了让 AI 读取 PDF 或 Word 文档,需要经过复杂的预处理过程。经常会出现表格(Table)结构崩溃、图像中的文字模糊、或者目录(Heading)信息丢失等问题。MarkItDown 正是为了解决这些问题而设计的。
该工具不仅是提取文字,它还能将文档的**标题(Headings)、列表(Lists)、表格(Tables)、链接(Links)**等结构化元素以 Markdown 格式保留下来。为什么要特意使用 Markdown 呢?
原因很明确:像 GPT-4o 这样的最新 LLM,在训练时就已经非常自然地理解了 Markdown 格式。Markdown 具有极高的 Token 效率,在节省成本的同时,能最准确地传递文档的上下文(Context),可以说是一种“AI 专用语言”。
MarkItDown 支持的惊人光谱
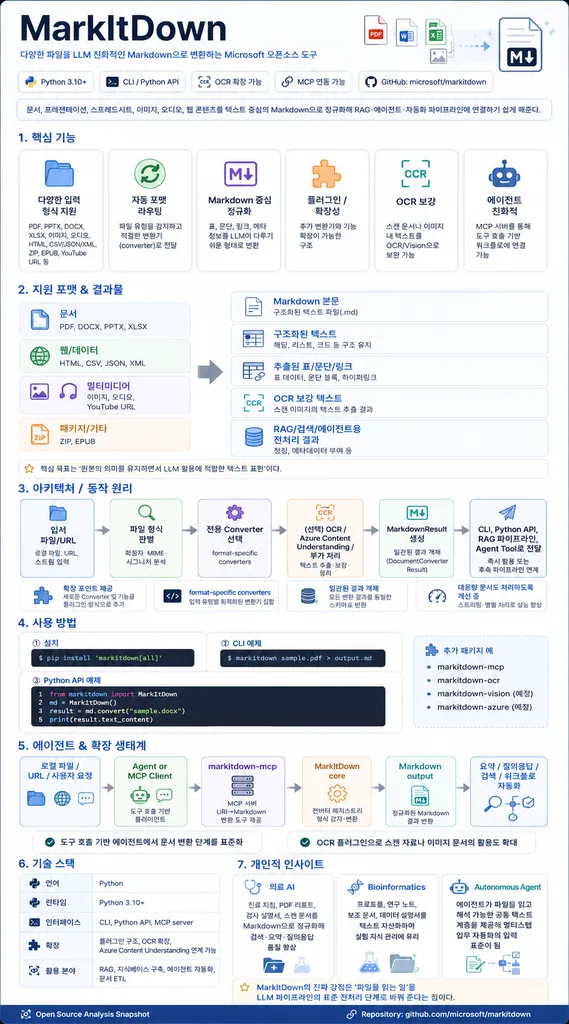
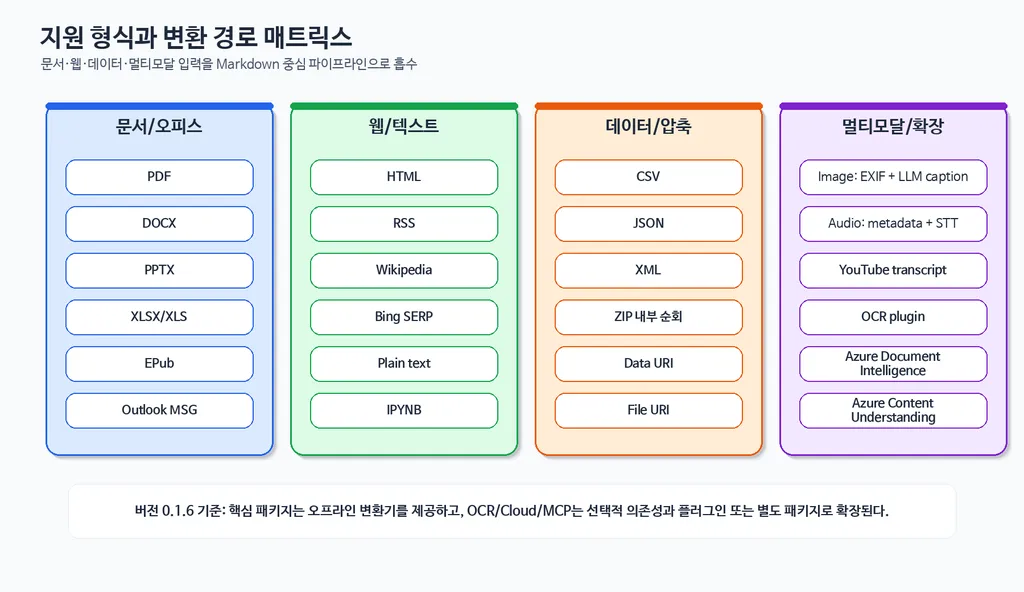
MarkItDown 真正的强大之处在于其“通用性”。它就像一个精通所有语言的全能翻译官,几乎能将所有类型的数据“翻译”成 Markdown。
其支持的文件格式之广令人咋舌:
- 文档及 Office:支持 PDF、Word (DOCX)、PowerPoint (PPTX)、Excel (XLSX)、EPubs 甚至 HTML。
- 媒体数据:对于图像文件,它不仅能提取 EXIF 元数据,还能利用 LLM 的视觉(Vision)功能来描述图像内容。音频文件则具备语音转文本(STT)的功能。
- 其他数据:支持结构化数据 CSV、JSON、XML,甚至能递归处理 ZIP 压缩包内的内容。甚至输入 YouTube URL,它还能提供获取视频内容的功能。
这里有一个有趣的细节:整个过程采用了高度模块化的设计。例如,音频转换利用了 Google API,而 Office 文档则通过 Mammoth 或 Pandas 等库转换为 Markdown。得益于这种灵活的架构,开发者可以只选择所需的功能,或者添加自定义插件来扩展工具。
当然,它并非完美无缺。正如所有的 OCR(光学字符识别)解决方案一样,在处理像复杂的学术论文那样表格、脚注、插图交织的文档时,完美还原布局可能会存在局限性。但就构建通用数据流水线(Data Pipeline)而言,MarkItDown 比使用传统的单个解析器要高效得多。
实战应用:用 4 行代码构建 AI 数据流水线
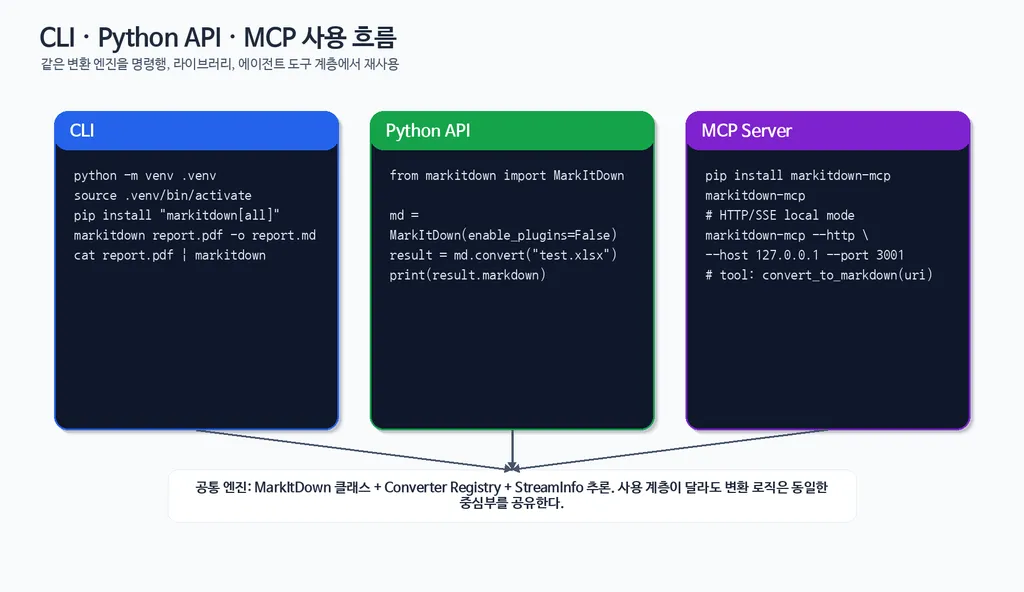
虽然知道“工具很好”,但你一定好奇实际怎么用吧?MarkItDown 最大的魅力在于“压倒性的简洁”。无需复杂的配置,只需 4 行 Python 代码即可完成文件转换。
首先,安装非常简单。打开终端,输入以下命令:
pip install 'markitdown[all]'如果担心占用空间,也可以选择性安装所需功能。例如,如果只需要 PDF 和 Word,可以执行 pip install 'markitdown[pdf, docx]'。
在实际 Python 代码中,可以这样使用:
from markitdown import MarkItDown

md = MarkItDown()
result = md.convert("your_document.pdf")
print(result.text)
这段简短的代码在内部会调用无数个库,分析复杂的 PDF 结构并将其转换为 Markdown,堪称魔法。
此外,该工具还支持 CLI(命令行界面),你甚至不需要编写 Python 代码。直接在终端输入命令即可:
markitdown path-to-file.pdf -o document.md如果你正在构建 RAG(检索增强生成)系统,这个工具将成为你最好的助手。通过将非结构化数据转换为结构化的 Markdown,它能减少 AI 在检索(Retrieval)时的噪声,从而帮助 AI 提供更准确的回答。
进一步说,如果结合 FastAPI 构建一个简单的 API 服务,并与 Zapier 或 n8n 等自动化工具联动,你甚至可以构建出“文件上传后自动转换为 Markdown 并传给 AI”的自动化工作流。
安全性、扩展性以及注意事项
不能仅仅因为是微软的工具就盲目相信它“绝对安全”。作为专业人士,我必须指出一个安全注意事项。
MarkItDown 使用的是当前运行进程的权限。也就是说,就像使用 open() 函数或 requests.get() 一样,它能够访问进程所能触及的所有文件和资源。如果你是在处理来自不可信来源文件的环境中运行,务必经过输入值验证(Sanitize)的过程。为了降低风险,明智的做法是使用限制范围的 convert_stream() 或 convert_local() 函数。
此外,在处理基于图像的 PDF 时需要注意。在默认设置下,可能无法完美读取图像中的文字。这种情况下,需要连接 OpenAI 的 gpt-4o 等多模态模型来激活视觉(Vision)功能。这样,AI 就能通过“看”图像内容来提供高水平的 OCR 功能。
但在这个过程中产生的 API 成本和速度问题,需要根据你的项目情况进行适当权衡。
总结:AI 时代的新标准
到目前为止,我们深入探讨了微软的创新工具 MarkItDown。
这个工具不仅仅是一个文件转换器,它更是将非结构化数据的价值提取并传递给 AI 的“数据门户”。
- 通用性:从 PDF 到音频,再到 YouTube,几乎可以将所有格式转换为 Markdown。
- 高效性:通过 Markdown 格式提高 LLM 的理解力,并优化 Token 使用量。
- 扩展性:通过 Python 库、CLI 和插件架构,可根据开发者的需求无限扩展。
在 2026 年的今天,如果你正在思考基于 AI 的知识检索或文档自动化系统,MarkItDown 正在从一个选项转变为一项必备的基础设施。不要再把时间浪费在复杂的数据预处理上了,把精力投入到更有价值的模型设计和服务逻辑开发中去吧。
你现在想要让 AI 学习哪些数据呢?或者你打算如何将 MarkItDown 应用到你的项目中?
欢迎在评论区分享你的想法或疑问!
参考资料
- What is Microsoft MarkItDown and Why It Matters? - Xeynergy Blog · blog.xeynergy.com
- MarkItDown: Microsoft의 전천후 마크다운 변환 및 RAG 전처리 도구 · wikidocs.net
- MarkItDown : MS 의 문서 파일 변환 도구 (to Markdown) - AI 탐구노트 · 42morrow.tistory.com
- 복잡한 학술 문서(이미지, 표, 각주 포함...)에 대해 7개의 OCR ... · reddit.com
- MarkItDown - Visual Studio Marketplace · marketplace.visualstudio.com