¿Sabes cuál es el primer muro con el que te encuentras al llevar a cabo un proyecto de ingeniería de datos o de IA? Es la enorme barrera de los "datos no estructurados".
PDF, Word, Excel, e incluso imágenes y audio... La información que poseemos tiene formas sumamente diversas. Sin embargo, el tipo de datos que los Modelos de Lenguaje de Gran Escala (LLM) procesan con mayor facilidad es el "texto" bien organizado.
Para cerrar esta brecha, innumerables desarrolladores han pasado noches en vela escribiendo códigos de parsing. Pero en este 2026, una herramienta lanzada por Microsoft llamada MarkItDown está resolviendo esta tediosa tarea repetitiva de una sola vez.
25,000 estrellas en solo 2 semanas, ¿por qué los desarrolladores de todo el mundo están entusiasmados?
Recientemente, hubo un evento que ha encendido el ecosistema del código abierto. MarkItDown, una utilidad basada en Python publicada por Microsoft, ha ganado una popularidad explosiva, superando las 25,000 estrellas en GitHub tras solo dos semanas de su lanzamiento.
¿Se debe esto simplemente a la noticia de que "ha salido un convertidor de archivos"? No. El núcleo de esta herramienta reside en que va más allá de una simple conversión: se trata de la "estructuración de datos amigable para la IA".
A menudo, para que una IA pueda leer documentos PDF o Word, debemos pasar por complejos procesos de preprocesamiento. Con frecuencia surgen problemas como la pérdida de la estructura de las tablas, el desenfoque del texto en las imágenes o la desaparición de la información de los encabezados (headings). MarkItDown ha sido diseñado precisamente para resolver estos problemas.
Esta herramienta no solo extrae texto, sino que preserva los elementos estructurales del documento, como encabezados (Headings), listas (Lists), tablas (Tables) y enlaces (Links), en formato Markdown. ¿Por qué precisamente Markdown?
La razón es clara. Los LLM más avanzados, como GPT-4o, han sido entrenados para comprender el formato Markdown de una manera muy natural. El Markdown posee una excelente eficiencia de tokens, lo que permite ahorrar costes mientras transmite con la mayor precisión posible el contexto del documento; se podría decir que es un "lenguaje exclusivo para IA".
El sorprendente espectro que soporta MarkItDown
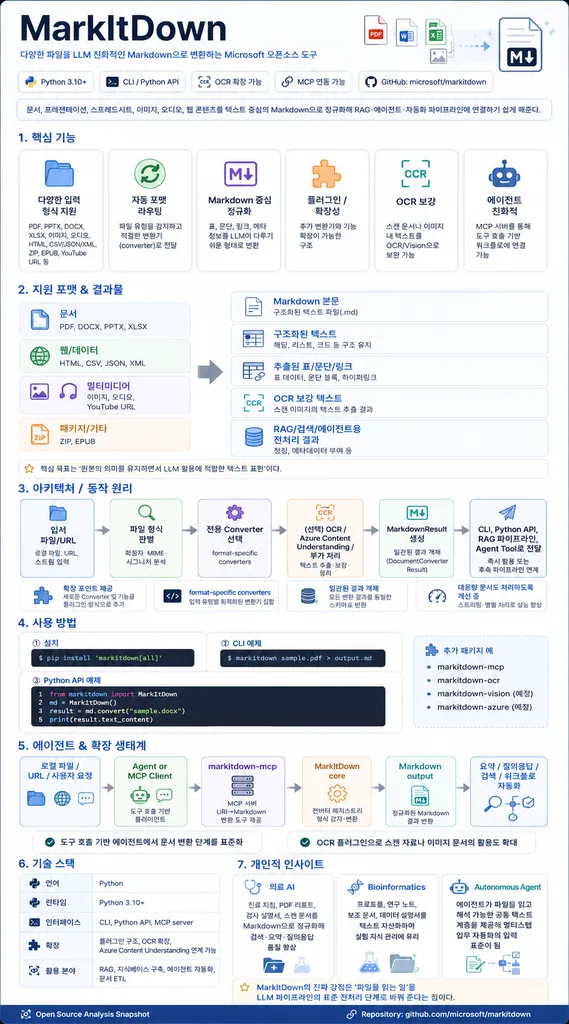
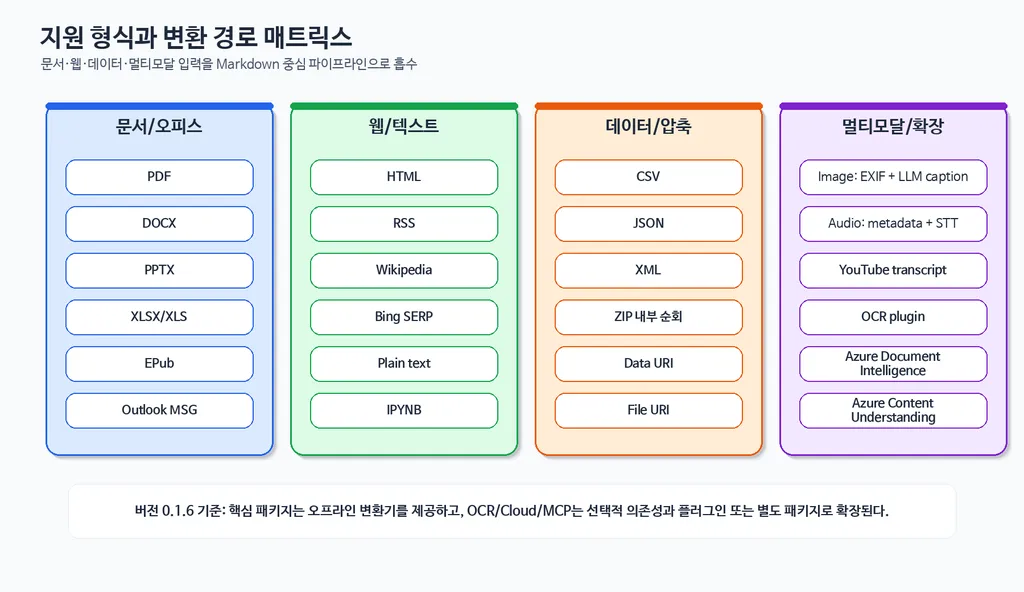
El verdadero poder de MarkItDown reside en su "versatilidad". Como un intérprete universal que habla todos los idiomas, traduce casi cualquier tipo de datos a Markdown.
Si observamos los formatos de archivo compatibles, es impresionante:
- Documentos y Office: Soporta PDF, Word (DOCX), PowerPoint (PPTX), Excel (XLSX), ePubs e incluso HTML.
- Datos multimedia: En el caso de archivos de imagen, no solo extrae metadatos EXIF, sino que también puede describir el contenido de la imagen utilizando las funciones de visión de los LLM. Los archivos de audio cuentan incluso con la función de conversión de voz a texto (STT).
- Otros datos: Además de datos estructurados como CSV, JSON y XML, puede procesar recursivamente el contenido dentro de archivos comprimidos ZIP. Incluso ofrece la función de obtener el contenido de un video si se proporciona una URL de YouTube.
Un punto interesante es que todo este proceso está diseñado de forma muy modular. Por ejemplo, la conversión de audio utiliza la API de Google, mientras que los documentos de Office pasan por librerías como Mammoth o Pandas antes de convertirse a Markdown. Gracias a esta arquitectura flexible, los desarrolladores pueden elegir solo las funciones que necesitan o extender la herramienta añadiendo sus propios plugins personalizados.
Por supuesto, no es perfecto. Como ocurre con todas las soluciones de OCR (Reconocimiento Óptico de Caracteres), puede haber limitaciones para reproducir perfectamente el diseño en documentos complejos, como artículos académicos donde se mezclan tablas, notas al pie e imágenes. Sin embargo, en términos de construcción de pipelines de datos versátiles, MarkItDown muestra una eficiencia mucho mayor que el uso de parsers individuales existentes.
Uso práctico: Construyendo un pipeline de datos de IA con solo 4 líneas de código
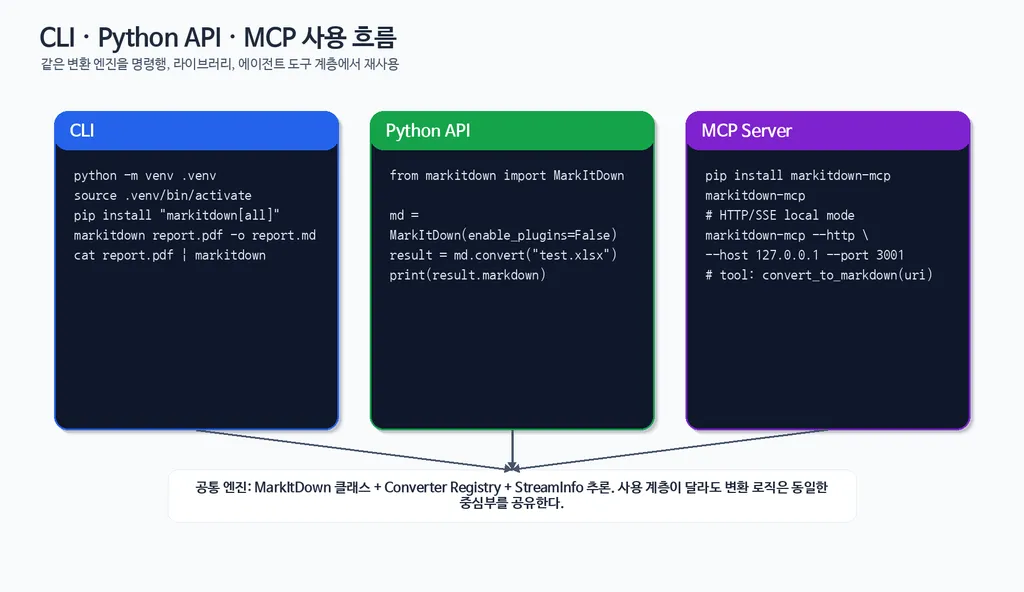
Entiendo que sabemos que "la herramienta es buena", pero ¿cómo se usa en realidad? El mayor atractivo de MarkItDown es su "simplicidad abrumadora". Se pueden convertir archivos con solo 4 líneas de código Python, sin configuraciones complejas.
Primero, la instalación es muy sencilla. Abre la terminal y escribe el siguiente comando:
pip install 'markitdown[all]'Si te preocupa el espacio en disco, puedes elegir instalar solo las funciones necesarias. Por ejemplo, si solo necesitas PDF y Word, puedes realizar una instalación selectiva como pip install 'markitdown[pdf, docx]'.
En un código Python real, se utiliza de la siguiente manera:
from markitdown import MarkItDown

md = MarkItDown()
result = md.convert("your_document.pdf")
print(result.text)
Este breve código, internamente, invoca numerosas librerías para analizar la compleja estructura del PDF y realizar la magia de convertirlo a Markdown.
Además, como esta herramienta soporta CLI (Interfaz de Línea de Comandos), ni siquiera necesitas escribir código Python. Puedes ejecutar el comando directamente en la terminal:
markitdown path-to-file.pdf -o document.mdSi estás construyendo un sistema RAG (Generación Aumentada por Recuperación), esta herramienta será tu mejor aliada. Al convertir datos no estructurados en Markdown estructurado, ayuda a que la IA reduzca el ruido durante la recuperación (Retrieval) y proporcione respuestas mucho más precisas.
Más aún, si combinas esto con FastAPI para crear un servidor API sencillo, podrías integrarlo con herramientas de automatización como Zapier o n8n para construir un flujo de trabajo automático que "convierta automáticamente a Markdown y lo entregue a la IA cuando se suba un archivo".
Seguridad, escalabilidad y puntos de precaución
No debemos creer ciegamente que solo por ser una herramienta de Microsoft es "segura". Como profesional, hay una advertencia de seguridad que debo mencionar.
MarkItDown utiliza los mismos permisos del proceso que se está ejecutando. Es decir, al igual que al usar la función open() o requests.get(), puede acceder a todos los archivos y recursos a los que el proceso tenga acceso. Si trabajas en un entorno donde conviertes archivos de fuentes no confiables, debes pasar obligatoriamente por un proceso de validación (Sanitize) de las entradas. Para reducir riesgos, es prudente utilizar las funciones convert_stream() o convert_local(), que limitan el alcance.
Además, se debe tener cuidado al procesar PDFs basados en imágenes. Con la configuración por defecto, es posible que no lea perfectamente el texto dentro de la imagen. En ese caso, se debe conectar un modelo multimodal como gpt-4o de OpenAI para activar la función de visión (Vision). Esto proporciona una función de OCR de alto nivel donde la IA puede ver y describir el contenido de la imagen o extraer el texto.
Sin embargo, los problemas de coste de API y velocidad que surjan en este proceso son responsabilidad de cada uno, debiendo ajustarlos según la situación de su proyecto.
Resumen: Un nuevo estándar para la era de la IA
Hasta ahora, hemos explorado en profundidad la innovadora herramienta de Microsoft, MarkItDown.
Esta herramienta va más allá de ser un simple convertidor de archivos; actúa como la "puerta de entrada de los datos", extrayendo el valor de los datos no estructurados para entregárselo a la IA.
- Versatilidad: Convierte casi cualquier formato, desde PDF hasta audio y YouTube, a Markdown.
- Eficiencia: Aumenta la comprensión de los LLM y optimiza el uso de tokens mediante el formato Markdown.
- Escalabilidad: Es infinitamente extensible para satisfacer las necesidades de los desarrolladores a través de su librería Python, CLI y arquitectura de plugins.
En este 2026, si estás considerando sistemas de búsqueda de conocimiento basados en IA o automatización de documentos, MarkItDown se está posicionando no como una opción, sino como una infraestructura esencial. Dedica el tiempo que antes pasabas en el complejo preprocesamiento de datos a tareas más valiosas como el diseño de modelos y el desarrollo de la lógica de servicio.
¿Qué tipo de datos quieres entrenar para la IA ahora? ¿O cómo te gustaría aplicar MarkItDown en tu proyecto?
¡Cuéntanos tus pensamientos o dudas en los comentarios!
Referencias
- What is Microsoft MarkItDown and Why It Matters? - Xeynergy Blog · blog.xeynergy.com
- MarkItDown: Microsoft의 전천후 마크다운 변환 및 RAG 전처리 도구 · wikidocs.net
- MarkItDown : MS 의 문서 파일 변환 도구 (to Markdown) - AI 탐구노트 · 42morrow.tistory.com
- 복잡한 학술 문서(이미지, 표, 각주 포함...)에 대해 7개의 OCR ... · reddit.com
- MarkItDown - Visual Studio Marketplace · marketplace.visualstudio.com