当你读完一篇新的世界模型(World Model)论文并尝试运行代码时,有没有遇到过比起模型本身,反而把大量时间耗费在数据加载代码或环境配置上的情况?
明明实现了同样的算法,却在苦恼“为什么我的结果和论文不一样”,这种为了复现结果而彻夜不眠的情况,已成为研究者们的日常痛苦。
今天,我们将深入探讨一款能够终结这种重复性“科研苦力”、让你能够专注于模型核心逻辑的创新平台——Stable World Model (SWM)。
重复的科研轮回:为什么世界模型研究如此痛苦?
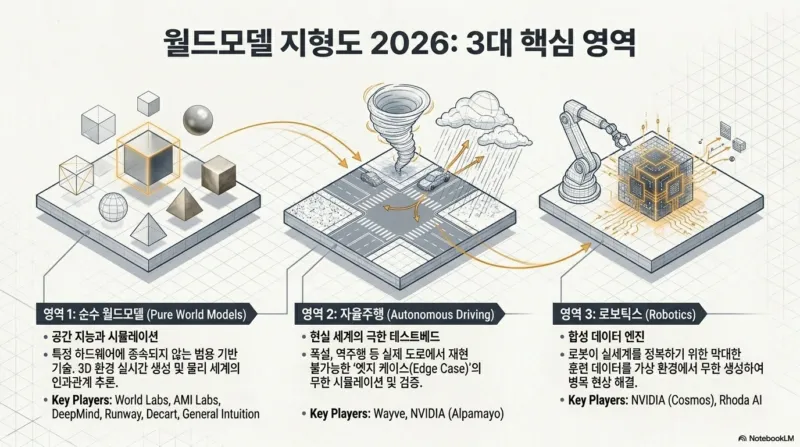
AI 研究,特别是预测和想象未来的“世界模型”领域,目前正处于爆发式增长期。然而,在这一辉煌增长的背后,隐藏着研究者们沉重的叹息。
最大的问题在于缺乏可复现性(Reproducibility)。每当新的世界模型论文发布时,研究者们都必须每次从头开始完成以下任务:
- 构建数据流水线:如何收集数据,以及以什么格式存储数据?
- 实现标准环境:如何确保模型测试的环境(如 Gymnasium, DeepMind Control Suite 等)与论文完全一致?
- 设计评估协议:如何实现用于衡量模型智能程度的规划求解器(Planning Solver)和评估逻辑?
在这个过程中产生的 Bug 或细微的环境差异,都会降低研究结果的可信度。有人因为数据加载速度慢导致 GPU 处于闲置状态,有人则在浪费精力确认环境的物理定律是否与论文微小不同,导致模型无法正常工作。
最终,研究者们会面临一个本质性的难题:“我做出的模型是真的好,还是仅仅因为我把数据加载代码写得好才表现得好?”
救星登场:Stable World Model 提供的集成接口
由 GalilAI Group 公开的 Stable World Model (SWM) 正是直面这一顽疾的解决方案。该平台将世界模型研究的核心三阶段——数据收集、模型训练、以及通过模型预测控制 (MPC) 进行评估——整合进了一个统一的接口中。
它就像是将复杂的烹饪过程整合在一起的“全能预制菜包(All-in-one Meal Kit)”。研究者不再需要花费时间处理食材和设置厨具,而是可以全身心地投入到“如何做出更美味的料理(设计模型架构)”之中。
1. 最大化科研效率的强大功能
SWM 之所以能超越简单的库,成为研究的标准,是因为它具备以下具体优势:
- 标准化的基准测试(Baseline)与求解器:内置了经过验证的基准模型和规划求解器(如 CEMSolver 等)。现在,你不再需要为了证明“我的模型比现有模型更好”而从零开始编写代码。
- 灵活的环境支持:从 DeepMind Control Suite 到 Gymnasium, OGBench, Arcade Learning Environment,它支持目前世界模型研究中几乎所有的环境。
- 可控的变化因子 (Controllable factors of variation):这是真正的杀手锏。你可以自由调节环境的颜色、纹理和物理特性。通过这种方式,可以非常精确地测试模型在陌生环境下的表现(零样本泛化 Zero-shot Generalization)以及对变化环境的适应能力(持续学习 Continual Learning)。
2. 数据管理的革命:LanceDB 的压倒性性能
在数据处理方式上,SWM 也展现出了显著的进步。研究者常因数据存储格式而头疼,而 SWM 在支持多种格式的同时,还祭出了 LanceDB 这一强力武器。
从实际的基准测试结果(基于 2026 年数据)来看,差异非常明显。
| 格式 | 本地样本处理速度 (samples/s) | 存储容量 (GB) | 备注 |
|---|---|---|---|
| LanceDB | 4,814.8 | 13.31 | 压倒性的速度与效率 |
| HDF5 | 相对较慢 | 43.12 | 容量非常大 |
| Video | 非常慢 | 约 0.5 (容量较小) | 易于视觉确认 |
特别是在云环境(S3)中的性能差异令人惊叹。当 HDF5 还在以每秒 9.1 个样本的速度艰难爬行时,LanceDB 能够以每秒 3,183.7 个样本的速度飞速运行。这完美解决了数据加载速度拖累训练速度的瓶颈问题。
实战应用:使用 SWM 构建研究工作流
那么,实际应该如何使用这个工具呢?从安装到评估的过程直观得令人惊讶。
第一步:构建环境
首先需要进行安装。如果只需要基本功能,使用 pip install stable-worldmodel 就足够了;但为了在研究中包含所有必要的环境和训练工具,建议加上 [all] 选项,这对你的“心理健康”大有裨益。
# 包含所有依赖项的安装
pip install stable-worldmodel[all]
如果你想在最新的 Python 环境中处理 LeRobot 数据集,可以在 Python 3.12 以上的环境中使用 [lerabit] 选项。
第二步:数据收集 (Data Collection)
通过创建 swm.World 对象来初始化环境,然后设置专家策略(Expert Policy)来收集数据。例如,在 'PushT' 环境中收集 100 个 episode 的过程只需几行代码。
import stable_worldmodel as swm

# 环境初始化 (并行运行 8 个环境)
world = swm.World('swm/PushT-v1', num_envs=8, image_shape=(64, 64))
world.set_policy(your_expert_policy)

# 数据收集 (100 个 episode)
world.collect('data/pusht_demo.h5', episodes=100, seed=0)
第三步:模型训练与评估 (Training & Evaluation)
加载收集到的数据并使用所需的模型架构进行训练后,通过 模型预测控制 (MPC) 来验证性能。将 CEMSolver 与 WorldModelPolicy 结合使用,可以立即查看模型是如何预测未来并制定计划的。
# 加载数据集并设置求解器
dataset = swm.data.HDF5Dataset('data/pusht_demo.h5', ...)
solver = swm.solver.CEMSolver(model=your_trained_model, num_samples=300, device='cuda')
policy = swm.policy.WorldModelPolicy(solver=solver, config=swm.policy.PlanConfig(horizon=10))

# 执行评估
world.set_policy(policy)
results = world.evaluate(episodes=50, seed=0)
print(f"Success Rate: {results['success_rate']:.1f}%")
当然,工具不可能完美。SWM 目前仍处于活跃开发阶段,API 会持续更新,使用时可能需要适应一些变化。但这正是开源项目走向成熟过程中必经的生长痛。
结论:迈向世界模型研究的新标准
Stable World Model 不仅仅是一个代码集合。它是为了解决世界模型研究者所面临的碎片化环境和可复现性问题而设计的研究基础设施。
从数据收集到高速数据处理 (LanceDB),再到精细的评估,这一完整的集成流让研究者能够将更多时间分配给“想法”而非“工具”。在 2026 年的今天,该平台正扮演着将世界模型研究水平提升一个档次的重要角色。
现在,何不从重复的环境配置和数据加载的泥潭中解脱出来,专注于更具创造性和挑战性的模型设计呢?
如果你正在从事世界模型研究,你最想解决的顽疾问题是什么?请在评论区分享你的困惑!
参考资料
- galilai-group/stable-worldmodel - GitHub · github.com
- Stable World-Model - GalilAI Group · galilai-group.github.io
- stable-worldmodel-v1: Reproducible World Modeling Research and ... · huggingface.co
- Activity · galilai-group/stable-worldmodel - GitHub · github.com



