새로운 월드 모델(World Model) 논문을 읽고 코드를 돌려보려 할 때, 모델 자체보다 데이터 로딩 코드나 환경 설정에서 시간을 다 허비해 본 적 있으신가요?
분명히 같은 알고리즘을 구현했는데, 왜 내 결과는 논문과 다를까 고민하며 밤을 지새우는 일은 이제 연구자들에게 일상적인 고통이 되었습니다.
오늘은 이런 반복적인 '연구 삽질'을 끝내고, 오직 모델의 핵심 로직에만 집중할 수 있게 도와줄 혁신적인 플랫폼, Stable World Model(SWM)에 대해 깊이 있게 파헤쳐 보겠습니다.
반복되는 연구의 굴레: 왜 월드 모델 연구는 고통스러운가?
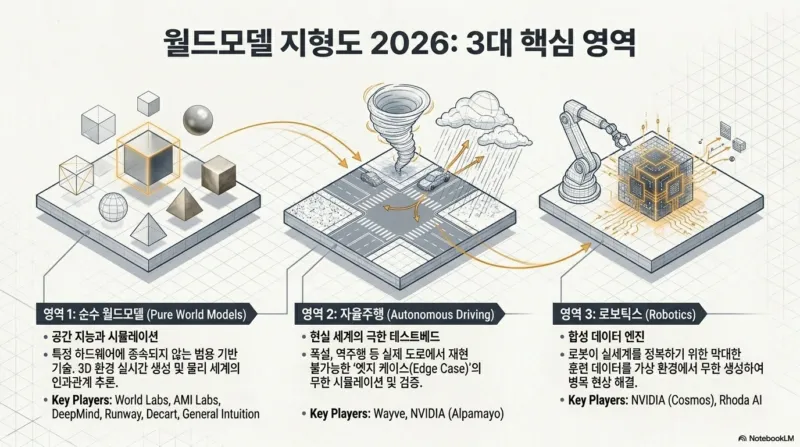
AI 연구, 특히 미래를 예측하고 상상하는 '월드 모델' 분야는 현재 폭발적인 성장기에 있습니다. 하지만 이 화려한 성장 뒤에는 연구자들의 깊은 한숨이 숨어 있습니다.
가장 큰 문제는 재현성(Reproducibility)의 부재입니다. 새로운 월드 모델 논문이 발표될 때마다 연구자들은 다음과 같은 과제를 매번 처음부터 다시 수행해야 합니다.
- 데이터 파이프라인 구축: 데이터를 어떻게 수집하고, 어떤 포맷으로 저장할 것인가?
- 표준 환경 구현: 모델이 테스트할 환경(Gymnasium, DeepMind Control Suite 등)을 어떻게 똑같이 맞출 것인가?
- 평가 프로토콜 설계: 모델이 얼마나 똑똑한지 측정하기 위한 계획 솔버(Planning Solver)와 평가 로직을 어떻게 구현할 것인가?
이 과정에서 발생하는 버그나 미묘한 환경 차이는 연구 결과의 신뢰성을 떨어뜨립니다. 누군가는 데이터 로딩 속도 때문에 GPU를 놀리고 있고, 누군가는 환경의 물리 법칙이 미세하게 달라 모델이 제대로 작동하지 않는지 확인하느라 에너지를 쏟고 있습니다.
결국, "내가 만든 모델이 진짜 좋은 건지, 아니면 그냥 데이터 로딩 코드를 잘 짜서 잘 나오는 건지" 알 수 없는 본질적인 문제에 직면하게 되는 것이죠.
해결사의 등장: Stable World Model이 제시하는 통합 인터페이스
GalilAI Group에서 공개한 Stable World Model(SWM)은 바로 이 고질적인 문제를 정면으로 돌파합니다. 이 플랫폼은 월드 모델 연구의 핵심 3단계인 데이터 수집, 모델 훈련, 그리고 모델 예측 제어(MPC)를 통한 평가를 하나의 통합된 인터페이스로 묶었습니다.
마치 복잡한 요리 과정을 하나로 합친 '올인원 밀키트'와 같습니다. 연구자는 재료를 손질하고 도구를 세팅하는 데 시간을 쓰는 대신, 오로지 '어떻게 더 맛있는 요리를 만들 것인가(모델 아키텍처 설계)'에만 집중할 수 있게 설계되었습니다.
1. 연구의 효율을 극대화하는 강력한 기능들
SWM이 단순한 라이브러리를 넘어 연구의 표준이 될 수 있는 이유는 다음과 같은 구체적인 강점 때문입니다.
- 표준화된 베이스라인과 솔버: 이미 검증된 베이스라인 모델과 계획 솔버(CEMSolver 등)가 내장되어 있습니다. 이제 "내 모델이 기존 모델보다 나은가?"를 증명하기 위해 밑바닥부터 코드를 짤 필요가 없습니다.
- 유연한 환경 지원: DeepMind Control Suite부터 Gymnasium, OGBench, Arcade Learning Environment까지, 현재 월드 모델 연구에서 쓰이는 거의 모든 환경을 지원합니다.
- 조절 가능한 변인(Controllable factors of variation): 이게 정말 물건입니다. 환경의 색상, 텍스처, 물리적 특성을 자유롭게 조절할 수 있습니다. 이를 통해 모델이 낯선 환경에서도 잘 작동하는지(Zero-shot Generalization)나, 변화하는 환경에 얼마나 잘 적응하는지(Continual Learning)를 아주 정밀하게 테스트할 수 있습니다.
2. 데이터 관리의 혁명: LanceDB의 압도적 성능
데이터 처리 방식에서도 SWM은 눈에 띄는 진보를 보여줍니다. 연구자들은 데이터 저장 포맷 때문에 골머리를 앓곤 하는데, SWM은 다양한 포맷을 지원하면서도 LanceDB라는 강력한 무기를 전면에 내세웠습니다.
실제 벤치마크 결과(2026년 데이터 기준)를 보면 그 차이가 극명합니다.
| 포맷 | 로컬 샘플 처리 속도 (samples/s) | 저장 용량 (GB) | 비고 |
|---|---|---|---|
| LanceDB | 4,814.8 | 13.31 | 압도적 속도와 효율성 |
| HDF5 | 상대적으로 느림 | 43.12 | 용량이 매우 큼 |
| Video | 매우 느림 | 약 0.5 (용량은 작음) | 시각적 확인 용이 |
특히 클라우드 환경(S3)에서의 성능 차이는 경이롭습니다. HDF5가 초당 9.1개의 샘플을 처리하며 헉헉거릴 때, LanceDB는 초당 3,183.7개의 샘플을 처리하며 시원하게 달립니다. 데이터 로딩 속도가 학습 속도를 잡아먹는 병목 현상을 완벽하게 해결한 셈입니다.
실전 적용: SWM으로 연구 워크플로우 구축하기
그렇다면 실제로 이 도구를 어떻게 사용할 수 있을까요? 설치부터 평가까지의 과정은 놀라울 정도로 직관적입니다.
단계 1: 환경 구축하기
가장 먼저 필요한 것은 설치입니다. 기본 기능만 필요하다면 pip install stable-worldmodel로 충분하지만, 연구에 필요한 모든 환경과 학습 도구를 포함하려면 [all] 옵션을 붙여주는 것이 정신 건강에 이롭습니다.
# 모든 의존성을 포함한 설치
pip install stable-worldmodel[all]
만약 최신 Python 환경에서 LeRobot 데이터셋까지 다루고 싶다면 Python 3.12 이상 환경에서 [lerabit] 옵션을 추가하면 됩니다.
단계 2: 데이터 수집 (Data Collection)
swm.World 객체를 생성하여 환경을 초기화한 뒤, 전문가 정책(Expert Policy)을 설정해 데이터를 모읍니다. 예를 들어 'PushT' 환경에서 100개의 에피소드를 수집하는 과정은 단 몇 줄로 끝납니다.
import stable_worldmodel as swm

# 환경 초기화 (8개의 환경을 병렬로 실행)
world = swm.World('swm/PushT-v1', num_envs=8, image_shape=(64, 64))
world.set_policy(your_expert_policy)

# 데이터 수집 (100개 에피소드)
world.collect('data/pusht_demo.h5', episodes=100, seed=0)
단계 3: 모델 훈련 및 평가 (Training & Evaluation)
수집된 데이터를 로드하여 원하는 모델 아키텍처로 학습시킨 후,에는 모델 예측 제어(MPC)를 통해 성능을 검증합니다. CEMSolver와 WorldModelPolicy를 결합하면, 모델이 미래를 어떻게 예측하고 계획을 세우는지 바로 확인할 수 있습니다.
# 데이터셋 로드 및 솔버 설정
dataset = swm.data.HDF5Dataset('data/pusht_demo.h5', ...)
solver = swm.solver.CEMSolver(model=your_trained_model, num_samples=300, device='cuda')
policy = swm.policy.WorldModelPolicy(solver=solver, config=swm.policy.PlanConfig(horizon=10))

# 평가 실행
world.set_policy(policy)
results = world.evaluate(episodes=50, seed=0)
print(f"Success Rate: {results['success_rate']:.1f}%")
물론, 모든 도구가 완벽할 수는 없습니다. SWM은 현재 활발히 개발 중인 단계이며, API가 지속적으로 업데이트되고 있어 사용 중 약간의 변화에 적응해야 할 수도 있습니다. 하지만 이는 오픈소스 프로젝트가 성숙해지는 과정에서 겪는 자연스러운 성장통입니다.
결론: 월드 모델 연구의 새로운 표준을 향하여
Stable World Model은 단순한 코드 모음집이 아닙니다. 이는 월드 모델 연구자들이 겪어온 파편화된 환경과 재현성 문제를 해결하기 위해 설계된 연구의 기반 인프라입니다.
데이터 수집부터 고속 데이터 처리(LanceDB), 그리고 정교한 평가까지 이어지는 이 통합된 흐름은 연구자가 '도구'가 아닌 '아이디어'에 더 많은 시간을 할애할 수 있게 해줍니다. 2026년 현재, 이 플랫폼은 월드 모델 연구의 지표를 한 단계 끌어올리는 중요한 역할을 수행하고 있습니다.
이제 반복되는 환경 설정과 데이터 로딩의 늪에서 벗어나, 더 창의적이고 도전적인 모델 설계에 집중해 보시는 건 어떨까요?
여러분이 월드 모델 연구를 한다면, 가장 해결하고 싶은 고질적인 문제는 무엇인가요? 댓글로 여러분의 고민을 공유해 주세요!
참고자료
- galilai-group/stable-worldmodel - GitHub · github.com
- Stable World-Model - GalilAI Group · galilai-group.github.io
- stable-worldmodel-v1: Reproducible World Modeling Research and ... · huggingface.co
- Activity · galilai-group/stable-worldmodel - GitHub · github.com