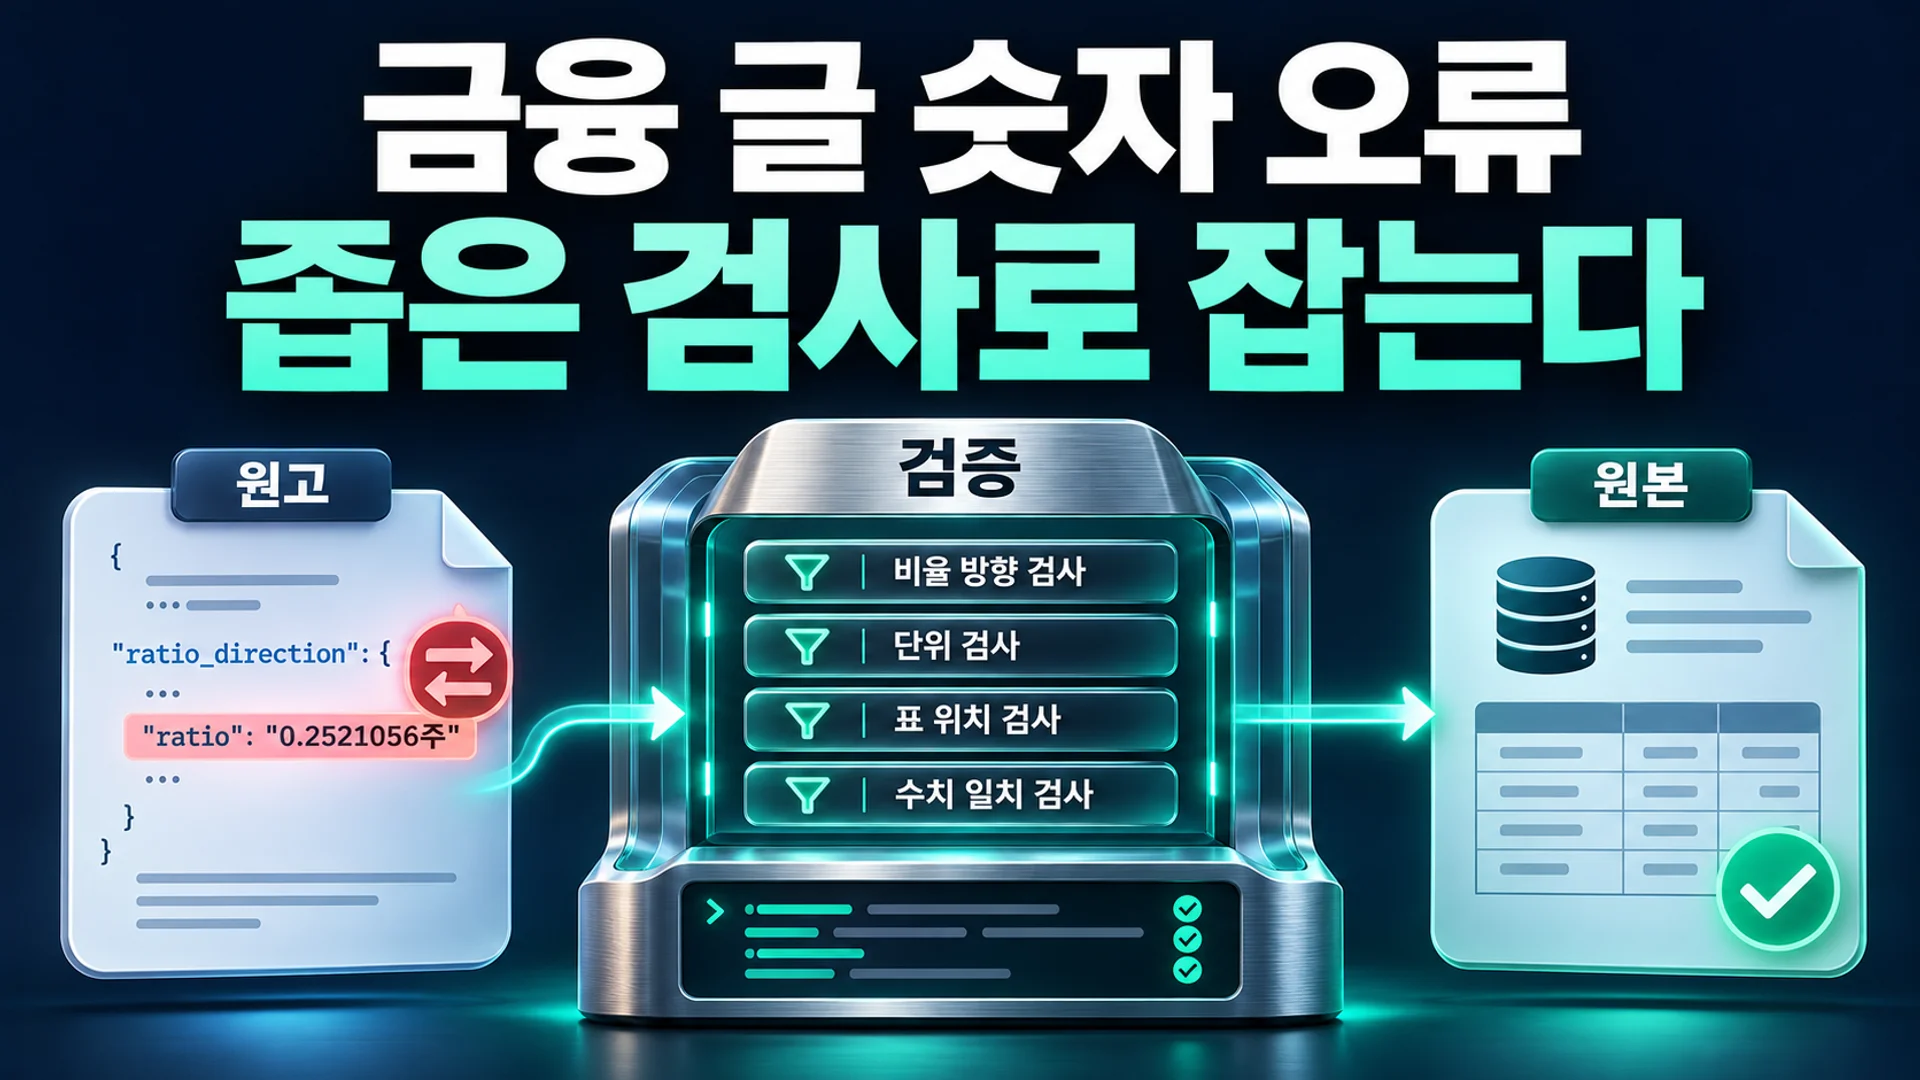
AI가 초안을 쓴 금융 글을 다듬을 때, 실무자는 문장 구조와 어조에 집중하기 쉽습니다. 그런데 공시 해설 블로그 macromalt.com을 운영하는 hs85-newbie는 프롬프트에 ‘정확히 확인하라’고 지시한 뒤 퇴고 단계에서 문장만 점검하다가 핵심 수치 검수를 건너뛰어, 실제 공시와 다른 금액이 그대로 공개된 일을 겪었다고 회고합니다1. 문장은 매끄러운데 숫자만 틀린 글은, 쓴 사람도 읽는 사람도 눈치채기 어렵습니다.
AI와 원본 데이터 사이에서 숫자 검증을 자동으로 수행하는 ‘팩트체크 MCP 서버’는 어떻게 구성해야 할까요? 공개된 korea-finance-factcheck 서버의 구조가 그 질문에 답을 제시합니다. 핵심은 “무엇이든 검증해 주는 거대한 엔진”이 아니라, 실제로 발생한 오류 유형별로 범위를 좁힌 검사 함수를 정의하는 것입니다. 각 함수가 공식 API를 직접 호출해 AI 출력과 원본의 불일치를 찾아내게 하고, 검증할 수 없는 항목은 ‘미검증’으로 명확히 처리해야 합니다. 경계를 좁혀 경고 피로를 줄이는 설계가 작동의 전제입니다.
왜 문장이 아닌 ‘숫자’를 검수해야 하는가
금융 리포팅에서 숫자 오류는 오타와 달리 사실 자체를 왜곡합니다. hs85-newbie는 AI와 협업해 글을 쓰다 세 가지 유형의 오류를 실제로 마주했습니다2.
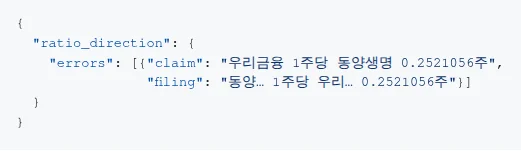
첫째는 비율의 방향 반전입니다. 공시에는 “동양생명 1주당 우리금융 0.2521056주”라고 기재되어 있는데, AI는 “우리금융 1주당 동양생명 0.2521056주”로 분모와 분자를 뒤바꿔 적었습니다. 둘째는 단위 혼용입니다. 원 단위로 기재된 금액에 ‘백만원’ 꼬리표가 붙으면서 매출과 영업이익이 10배, 100배로 부풀려졌고, 이 실수는 공개된 글 여덟 편에 그대로 실렸습니다. 셋째는 오프셋 오독입니다. 미국 재무부 금리표를 읽다가 행·열 위치가 밀려, 10년물 금리 자리에 7년물 금리를 옮겨 적었습니다2.
눈여겨볼 점은 이 오류가 모델의 언어적 한계 때문에 발생하지 않았다는 사실입니다. hs85-newbie는 “세 번 모두 모델은 받은 대로 썼다”라고 적었습니다2. 비율을 반대로 읽고 단위 꼬리표를 붙인 것은 사람 쪽 오독과 퇴고 공백이 원인이었고, 모델은 그 입력을 충실히 옮겼을 뿐입니다. 프롬프트에서 정확성을 강조해도, 원본 대조가 파이프라인에 구조적으로 포함되지 않으면 오류는 남습니다. AI 리포팅의 품질은 모델 성능만의 문제가 아니라, 검증 인프라가 얼마나 잘 연결되어 있는지의 문제입니다.
MCP 서버는 AI와 원본 데이터 사이에 어떻게 놓이는가
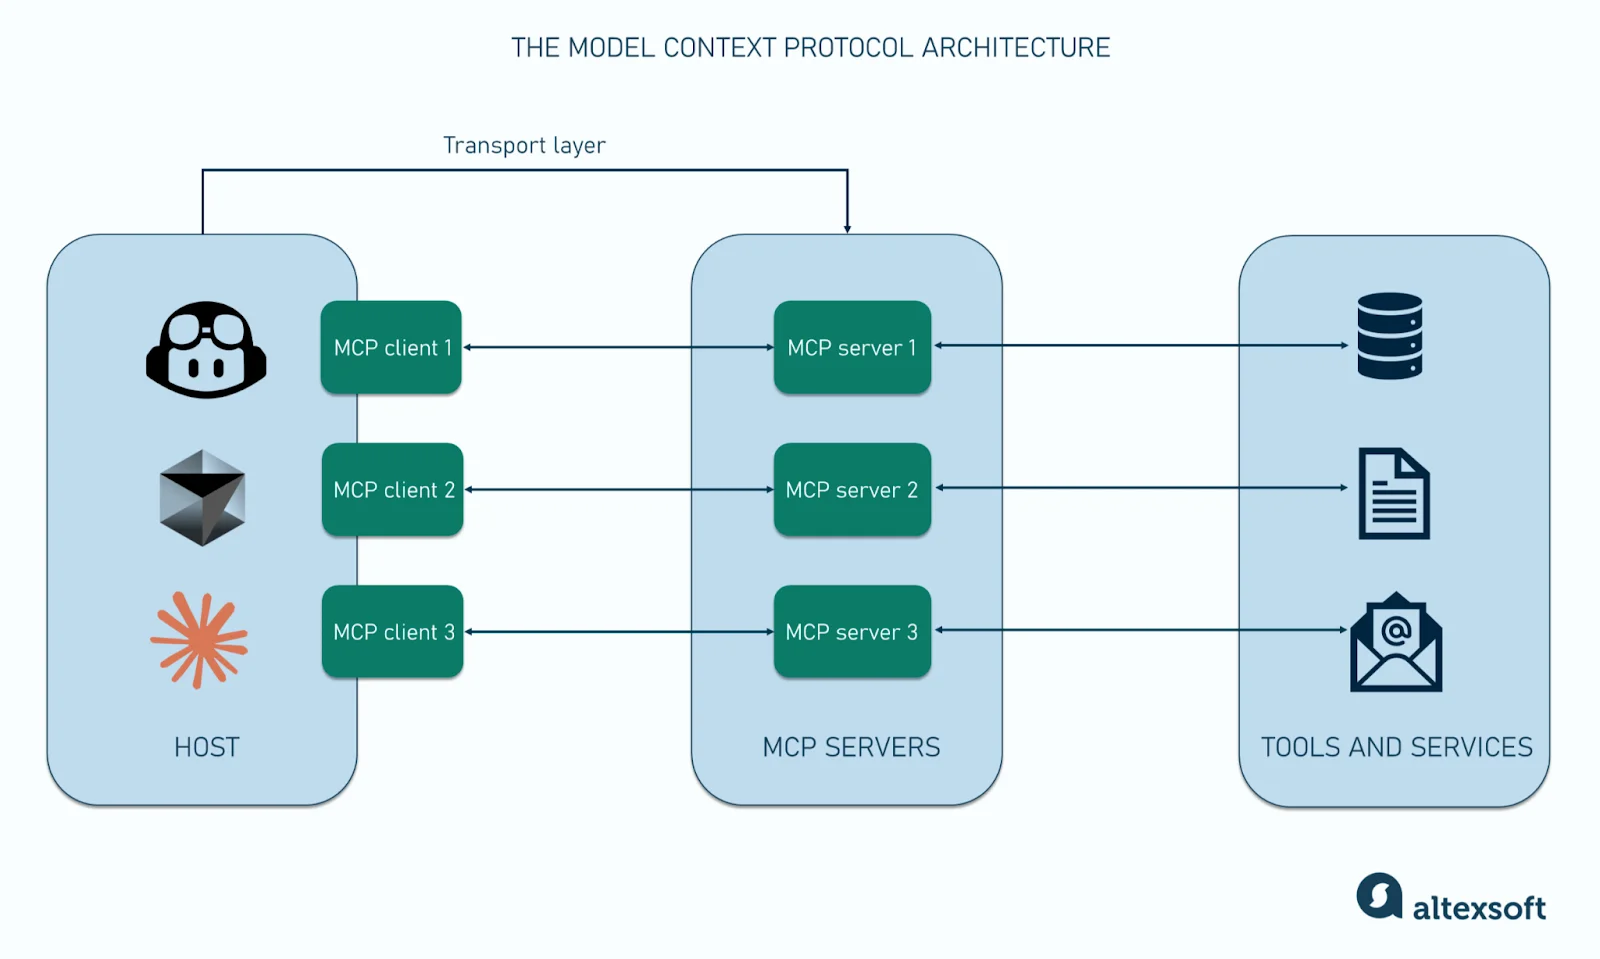
팩트체크를 자동화하려면 AI가 원본 데이터를 호출할 표준화된 통로가 필요합니다. 여기서 MCP(Model Context Protocol)가 활용됩니다.
MCP는 AI 애플리케이션이 외부 데이터 소스나 도구와 연결되는 방식을 표준화합니다. 기본 구조는 호스트(AI 애플리케이션) → 클라이언트(커넥터) → 서버(기능 노출 프로그램)로 이어지는 3자 구조이며, 서버는 도구(tools), 리소스(resources), 프롬프트(prompts)를 노출합니다3. 기업 내부 AI 앱이 N개이고 데이터 소스가 M개라면 표준 없이 개별 커넥터를 만들었을 때 N×M개의 연결이 필요합니다. MCP는 이를 표준 프로토콜 하나로 줄여줍니다3.
korea-finance-factcheck 서버는 이 구조의 ‘tools’ 프리미티브를 활용해 LLM에게 “원고의 숫자를 공식 데이터와 대조하는 기능”을 제공합니다. Claude나 내부 AI 에이전트가 원고를 전달하면, 서버는 도구 호출(tools/call)을 받아 DART 공시, 한국은행 ECOS, 미국 재무부, 한국거래소(KRX) 등을 직접 조회하고 비교 결과를 JSON으로 반환합니다. 참고로 2026년 7월 28일 개정된 MCP 사양에서는 프로토콜 계층이 스테이트리스(stateless)로 전환되었습니다. 각 요청이 자체 버전과 메타데이터를 포함하도록 바뀌면서, 서버 인스턴스 간 상태 공유 없이 라운드 로빈 로드 밸런싱으로 수평 확장할 수 있게 되었습니다3.
스코프를 좁힌 4가지 검사 함수 설계
korea-finance-factcheck가 주목할 만한 이유는 “모든 숫자를 다 검사한다”고 주장하지 않기 때문입니다. hs85-newbie는 검사 범위를 의도적으로 좁혀 경고 피로를 방지했습니다2.
1. check_ratio_direction: 방향 오류
합병·주식교환 비율 문장을 공시 원문과 비교합니다. 본문에 “X 1주당 Y n주”가 있으면, 공시에 기재된 지급·수취 주체가 뒤바뀐 문장을 잡아냅니다2. 본문에 접수번호가 있으면 DART에서 공시를 불러오고, 없으면 본문에 옮겨 적힌 표기와 대조합니다.
2. check_unit_errors: 단위 오류
종목코드(예: 삼성전자 005930)와 함께 기재된 매출, 영업이익, 순이익을 DART 사업보고서와 대조합니다. 다만 10배, 100배, 1000배 단위로 어긋난 숫자만 선별 보고합니다. hs85-newbie는 증권사 전망치처럼 원래 공시와 다른 숫자까지 잡으면 경고가 과다해져 일부러 범위를 좁혔다고 명시했습니다2.
3. check_market_numbers: 시장 지표 오프셋 오류
미 재무부 자료의 2·5·10·30년물 국채 금리와 한국은행 ECOS의 코스피 종가·기준금리·환율을 조회합니다. 특히 환율 검증에서는 주간 종가와 ECOS의 매매기준율이라는 구조적 차이를 고려해, 15원 이상 차이 날 때만 경고를 울립니다2. 이는 사소한 표기 차이를 오류로 잡지 않으려는 장치입니다.
4. check_stock_closes: 종가 오독
‘종가’나 ‘마감’이 명시된 원 단위 숫자를 KRX 공식 종가와 비교합니다. 목표주가를 종가로 오독하지 않도록 ‘종가’라는 단어 조건을 단단히 걸었습니다. 눈여겨볼 점은 등락률 검증에서 제외했다는 것입니다. hs85-newbie는 “‘9월 30일 이후 18.8% 하락’ 같은 기간 수익률을 하루 등락으로 잘못 읽은 적이 있어서” 등락률은 보지 않는다고 적었습니다2.
이 네 가지 검사의 공통점은 오류의 원인 자체가 좁게 정의된 함수라는 점입니다. hs85-newbie는 “손으로 지어낸 숫자만 보는 테스트는 실제 실수를 잡지 못했기” 때문에, 테스트에 실제로 틀렸던 문장을 그대로 넣었다고 설명합니다2.
파이프라인 배치와 예외 처리 워크플로
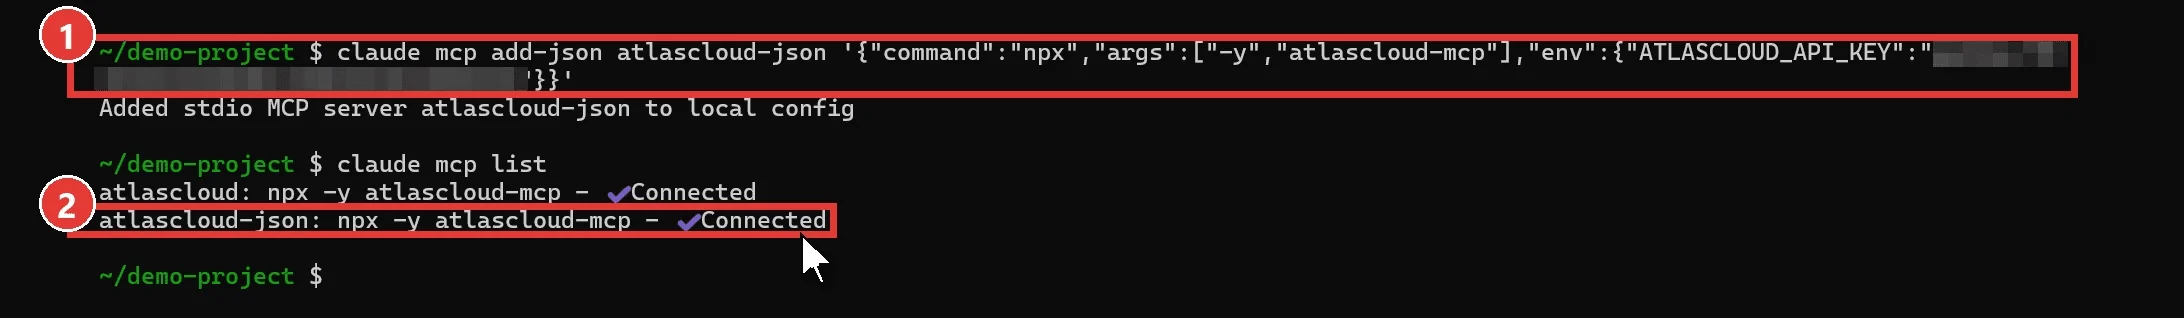
설치는 간단합니다. uv가 있는 환경이라면 Claude Code에서 다음 명령어로 등록합니다2.
claude mcp add korea-finance-factcheck \
  -e DART_API_KEY=발급받은_키 \
  -e ECOS_API_KEY=발급받은_키 \
  -e KRX_API_KEY=발급받은_키 \
  -- uvx korea-finance-factcheck
Claude Desktop에서는 claude_desktop_config.json에 mcpServers 설정을 넣습니다2.
{
  "mcpServers": {
    "korea-finance-factcheck": {
      "command": "uvx",
      "args": ["korea-finance-factcheck"],
      "env": {
        "DART_API_KEY": "발급받은_키",
        "ECOS_API_KEY": "발급받은_키",
        "KRX_API_KEY": "발급받은_키"
      }
    }
  }
}
주의할 점은 세 기관(DART, ECOS, KRX)의 인증키를 모두 각자 발급받아 넣어야 한다는 것입니다. 기관 약관상 인증키를 남과 나눠 쓸 수 없어, 서버가 사용자의 키를 중앙 프록시처럼 대신 보관하지 않습니다2. KRX Open API는 비상업 용도로만 허용되며, 결과 표기 시 ‘KRX 통계정보’라고 출처를 명시해야 합니다2.
파이프라인 배치 시 중요한 것은 예외 처리 워크플로입니다.
- 조회 실패를 알립니다. API 키가 없거나 조회 자체가 실패하면
skipped필드에 이유를 명시합니다2. - 부분 실패를 허용합니다.
check_all을 돌릴 때 일부 검사가 실패해도 나머지 결과는 반환합니다2. - 미검증을 구분합니다. 공시나 공식 통계에 없는 숫자(증권사 추정치, 장중 시세 등)는 판단하지 않고
unverified로 반환합니다2.
“판단 불가”를 오류와 구분하여 사람이 최종 확인하도록 유도하는 것이 핵심입니다. hs85-newbie는 “검사를 하지 못했을 때도 조용히 넘어가지 않는다”는 점을 명확히 하며, 검사 실패와 대상 미포함을 분리했습니다2.
검증 커버리지와 실제 한계
이 서버의 역할은 원본과 본문 숫자의 일치 여부 대조로 한정됩니다. hs85-newbie는 "어떤 종목을 사라거나 팔라고 하지 않고 주가 전망도 내놓지 않습니다. 결과를 투자 판단의 근거로 쓰지 마세요"라고 명확히 선을 그었습니다2.
한계도 명확합니다. korea-finance-factcheck는 hs85-newbie 본인이 겪은 세 가지 오류 유형(비율 반전, 단위 혼동, 열 오프셋)을 기반으로 설계되었습니다2. hs85-newbie 본인도 “제 블로그에서 터진 실수들만 보고 만든 거라, 다른 분들 글에서도 쓸모가 있을지 잘 모르겠다”고 GeekNews에 적었습니다1.
따라서 이 도구 구조를 적용할 때는, 자신의 콘텐츠에서 자주 발생하는 오류 유형을 먼저 정의해야 합니다. 투자 리포트에 자주 등장하는 증권사 컨센서스나 PER, PBR 수치 오류를 잡으려면 서버 범위 밖이므로 ‘미검증’으로 반환될 가능성이 높습니다2. 또한 네이버 데이터는 약관상 범위가 좁아 네이티브로 지원하지 않습니다2. 이는 기술적 한계가 아니라 데이터 소스 약관상 사용 범위가 좁은 데 따른 설계 결정입니다.
AI 금융 글의 숫자 오류를 잡으려면 거대한 검증 플랫폼보다, 실제로 발생한 오류 유형별로 범위를 좁힌 검사 함수를 MCP 서버로 묶는 것이 효과적입니다. 각 함수가 공식 API를 직접 호출해 원본과 대조하고, 검증 불가한 항목은 skipped와 unverified로 투명하게 드러내 사람이 확인하도록 경계를 설계하는 것이 경고 피로 없이 검수를 유지하는 조건입니다.
참고자료
- AI로 쓴 금융 글, 숫자 검사기 MCP | GeekNews · news.hada.io↩
- ↩
- Model Context Protocol architecture: An executive guide · kellton.com↩