Al pulir textos financieros redactados por una IA como borrador, los profesionales suelen centrarse en la estructura de las frases y el tono. Sin embargo, hs85-newbie, quien opera el blog de comentarios sobre información financiera macromalt.com, recuerda que tras indicar en el prompt “verificar con exactitud”, solo revisó las frases durante la fase de corrección, saltándose la revisión de los datos clave, lo que provocó que se publicaran importes diferentes a los de la información financiera real1. Un texto con frases fluidas pero cifras erróneas es difícil de detectar tanto para quien lo escribe como para quien lo lee.
¿Cómo debe configurarse un “servidor MCP de fact-checking” que realice la verificación de cifras de forma automática entre la IA y los datos originales? La estructura del servidor publicado korea-finance-factcheck ofrece una respuesta a esta pregunta. La clave no es “un enorme motor que verifica cualquier cosa”, sino definir funciones de comprobación con un alcance reducido por cada tipo de error realmente observado. Cada función debe llamar directamente a las API oficiales para detectar discrepancias entre la salida de la IA y el original, y los elementos que no se puedan verificar deben tratarse explícitamente como “sin verificar”. El diseño que reduce los límites para disminuir la fatiga por advertencias es el presupuesto fundamental de su funcionamiento.
Por qué se debe verificar “los números” y no las frases
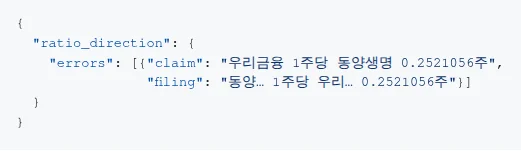
En la elaboración de informes financieros, los errores numéricos distorsionan los hechos en sí, a diferencia de las erratas. hs85-newbie se topó con tres tipos de errores al escribir textos colaborando con la IA2.
El primero es la inversión de la dirección de la proporción. En la información financiera figura “0,2521056 acciones de Woori Financial por cada acción de Dong-Ah Life”, pero la IA lo escribió invirtiendo numerador y denominador: “0,2521056 acciones de Dong-Ah Life por cada acción de Woori Financial”. El segundo es la confusión de unidades. A las cifras redactadas en unidades originales se les añadió la etiqueta “millones de wones”, inflando las ventas y el beneficio operativo por factores de 10 o 100, y este error quedó registrado tal cual en ocho artículos publicados. El tercero es la lectura incorrecta de desplazamientos (offsets). Al leer la tabla de tipos de interés del Departamento del Tesoro de EE. UU., la posición de filas y columnas se desplazó, trasladando el tipo de interés a 7 años al lugar correspondiente al de 10 años2.
Cabe destacar que estos errores no se debieron a las limitaciones lingüísticas del modelo. hs85-newbie escribió: “En los tres casos, el modelo solo transcribió lo que recibió”2. La lectura invertida de las proporciones y la adición de etiquetas de unidades fueron causadas por errores humanos de interpretación y huecos en la corrección; el modelo simplemente trasladó con fidelidad dichas entradas. Aunque se enfatice la exactitud en el prompt, si la cotejo con el original no está estructuralmente incluida en el flujo de trabajo, los errores persisten. La calidad de los informes generados por IA no es solo una cuestión del rendimiento del modelo, sino de qué tan bien conectada esté la infraestructura de verificación.
Cómo se coloca el servidor MCP entre la IA y los datos originales
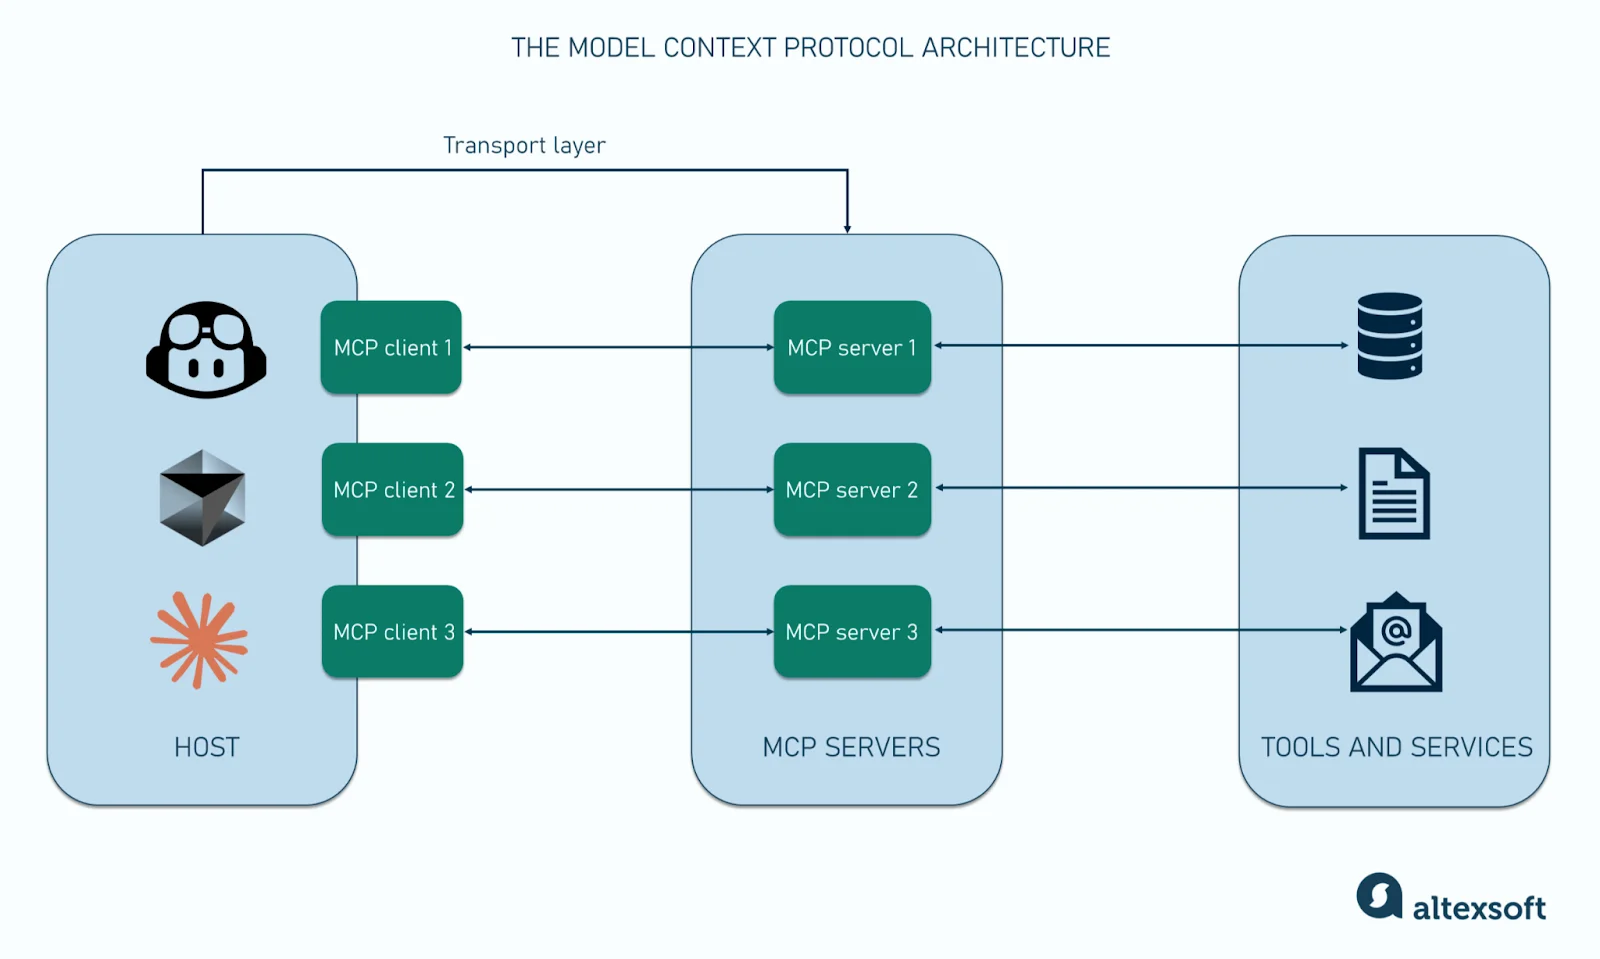
Para automatizar el fact-checking, es necesario que la IA disponga de una vía estandarizada para llamar a los datos originales. Aquí es donde se utiliza MCP (Model Context Protocol).
MCP estandariza cómo las aplicaciones de IA se conectan con fuentes de datos o herramientas externas. La estructura básica es una arquitectura tripartita: host (aplicación de IA) → cliente (conector) → servidor (programa que expone funciones), y el servidor expone herramientas (tools), recursos (resources) y prompts (prompts)3. Si una empresa tiene N aplicaciones internas de IA y M fuentes de datos, sin estándares se necesitarían N×M conexiones individuales. MCP reduce esto a un único protocolo estándar3.
El servidor korea-finance-factcheck utiliza la primitiva “tools” de esta estructura para ofrecer a los LLMs la “función de contrastar las cifras del manuscrito con datos oficiales”. Cuando Claude o un agente de IA interno transmite el manuscrito, el servidor recibe la llamada de herramienta (tools/call), consulta directamente DART, ECOS del Banco de Corea, el Departamento del Tesoro de EE. UU. y la Bolsa de Valores de Corea (KRX), y devuelve los resultados de la comparación en JSON. Cabe mencionar que en la especificación de MCP revisada el 28 de julio de 2026, la capa de protocolo cambió a stateless (sin estado). Al hacer que cada solicitud incluya su propia versión y metadatos, ahora es posible escalar horizontalmente mediante balanceo de carga round robin sin compartir estado entre instancias del servidor3.
Diseño de 4 funciones de comprobación con alcance reducido
korea-finance-factcheck es destacable porque no afirma “verificar todos los números”. hs85-newbie redujo deliberadamente el alcance de la comprobación para prevenir la fatiga por advertencias2.
1. check_ratio_direction: Error de dirección
Compara las frases sobre las proporciones de fusiones o intercambios de acciones con el texto original de la información financiera. Si el cuerpo del texto contiene “n acciones de Y por cada acción de X”, detecta las frases donde las entidades pagadoras y receptoras indicadas en la información financiera están invertidas2. Si el cuerpo del texto incluye el número de recepción, obtiene la información financiera desde DART; si no, lo contrasta con las notaciones transcritas en el cuerpo del texto.
2. check_unit_errors: Error de unidades
Contrasta las ventas, el beneficio operativo y el beneficio neto registrados junto con el código de valores (por ejemplo, Samsung Electronics 005930) con el informe de actividades anual de DART. Sin embargo, solo reporta selectivamente las cifras desviadas en órdenes de magnitud de 10, 100 o 1000 veces. hs85-newbie precisó que redujo deliberadamente el alcance porque, al captar también cifras que difieren de la información financiera por naturaleza, como las previsiones de las casas de valores, las advertencias resultaban excesivas2.
3. check_market_numbers: Error de desplazamiento en indicadores de mercado
Consulta los tipos de interés de los bonos del Estado a 2, 5, 10 y 30 años de los datos del Departamento del Tesoro de EE. UU. y los datos de ECOS del Banco de Corea, como el cierre del KOSPI, la tasa de referencia y los tipos de cambio. En particular, en la verificación de tipos de cambio, se consideran las diferencias estructurales entre el cierre semanal y la tasa de referencia de operaciones de ECOS, por lo que solo se emite una advertencia si la diferencia supera los 15 wones2. Esta es una medida para no captar como errores simples diferencias de notación menores.
4. check_stock_closes: Error de lectura del cierre
Compara los números en unidades originales donde está especificado explícitamente “cierre” o “clausura” con el cierre oficial de KRX. Se impusieron condiciones estrictas con la palabra “cierre” para evitar leer erróneamente los precios objetivos como precios de cierre. Cabe destacar que se excluyó la verificación de variaciones porcentuales. hs85-newbie escribió que no revisa las variaciones porcentuales “porque alguna vez leyó erróneamente como variación diaria rendimientos periodales como ‘caída del 18,8 % desde el 30 de septiembre’”2.
La característica común de estas cuatro comprobaciones es que son funciones donde la propia causa del error está estrechamente definida. hs85-newbie explicó que, dado que “las pruebas que solo miran números inventados manualmente no lograban detectar los errores reales”, incorporó tal cual en las pruebas las frases donde realmente se había equivocado2.
Ubicación en el flujo de trabajo y flujo de gestión de excepciones
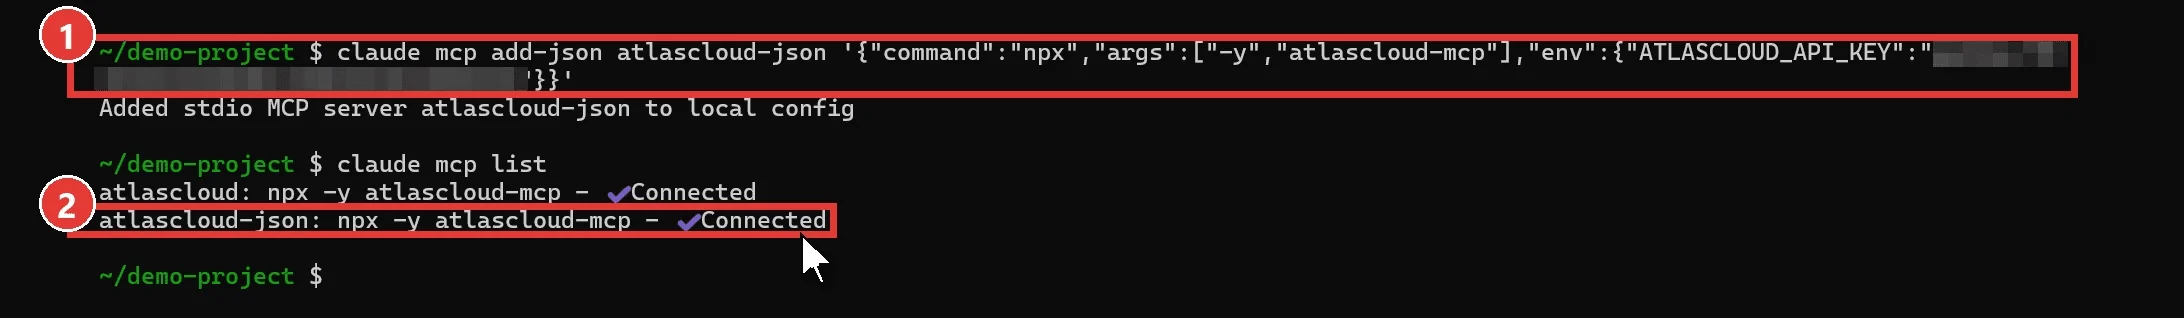
La instalación es sencilla. Si dispone de un entorno con uv, regístrelo en Claude Code con el siguiente comando2.
claude mcp add korea-finance-factcheck \
  -e DART_API_KEY=발급받은_키 \
  -e ECOS_API_KEY=발급받은_키 \
  -e KRX_API_KEY=발급받은_키 \
  -- uvx korea-finance-factcheck
En Claude Desktop, incluya la configuración mcpServers en claude_desktop_config.json2.
{
  "mcpServers": {
    "korea-finance-factcheck": {
      "command": "uvx",
      "args": ["korea-finance-factcheck"],
      "env": {
        "DART_API_KEY": "발급받은_키",
        "ECOS_API_KEY": "발급받은_키",
        "KRX_API_KEY": "발급받은_키"
      }
    }
  }
}
El punto a tener en cuenta es que debe obtener e introducir por separado las claves de autenticación de las tres instituciones (DART, ECOS, KRX). Según los términos y condiciones de cada institución, las claves de autenticación no pueden compartirse con otros, por lo que el servidor no custodia las claves del usuario como un proxy central2. La API abierta de KRX solo se permite para fines no comerciales, y al indicar los resultados se debe especificar la fuente como “KRX Statistical Information”2.
En la ubicación dentro del flujo de trabajo, lo importante es el flujo de gestión de excepciones.
- Notifica los fallos de consulta. Si falta la clave de API o la consulta en sí misma falla, especifica la razón en el campo
skipped2. - Permite fallos parciales. Al ejecutar
check_all, aunque algunas comprobaciones fallen, se devuelven los resultados de las restantes2. - Distingue lo no verificado. Los números que no existen en la información financiera o estadísticas oficiales (como estimaciones de casas de valores, cotizaciones intradía, etc.) no se juzgan y se devuelven como
unverified2.
La clave es diferenciar la “imposibilidad de juicio” de los errores, para inducir la confirmación final por parte de una persona. hs85-newbie aclaró el punto de que “no se ignora silenciosamente cuando la comprobación no se puede realizar”, separando los fallos de comprobación de los elementos no incluidos en el alcance2.
Cobertura de verificación y limitaciones reales
El papel de este servidor se limita a contrastar la coincidencia entre los números del original y del cuerpo del texto. hs85-newbie trazó claramente la línea al afirmar: “No indica qué valores comprar o vender, ni ofrece previsiones de precios. No utilice los resultados como base para decisiones de inversión”2.
Las limitaciones también son claras. korea-finance-factcheck se diseñó basándose en los tres tipos de errores que hs85-newbie experimentó personalmente (inversión de proporciones, confusión de unidades y desplazamiento de columnas)2. El propio hs85-newbie escribió en GeekNews: “Como lo creé solo viendo los errores que surgieron en mi blog, no sé si será útil también en los textos de otras personas”1.
Por lo tanto, al aplicar esta estructura de herramientas, primero debe definir los tipos de errores que surgen con frecuencia en su propio contenido. Para detectar errores en cifras como el consenso de casas de valores, PER o PBR que aparecen a menudo en los informes de inversión, es probable que se devuelvan como “sin verificar” al estar fuera del alcance del servidor2. Además, los datos de Naver no se admiten de forma nativa porque su alcance es limitado según los términos y condiciones2. Esto no es una limitación técnica, sino una decisión de diseño derivada de que el alcance de uso de la fuente de datos es estrecho según sus términos y condiciones.
Para detectar errores numéricos en textos financieros generados por IA, es más eficaz agrupar en un servidor MCP funciones de comprobación con alcance reducido por cada tipo de error realmente observado que una plataforma de verificación gigantesca. Diseñar los límites para que cada función llame directamente a las API oficiales y contraste con el original, y para que los elementos no verificables se muestren con transparencia mediante skipped e unverified permitiendo la revisión humana, es la condición para mantener la revisión sin fatiga por advertencias.
Referencias
- AI로 쓴 금융 글, 숫자 검사기 MCP | GeekNews · news.hada.io↩
- ↩
- Model Context Protocol architecture: An executive guide · kellton.com↩