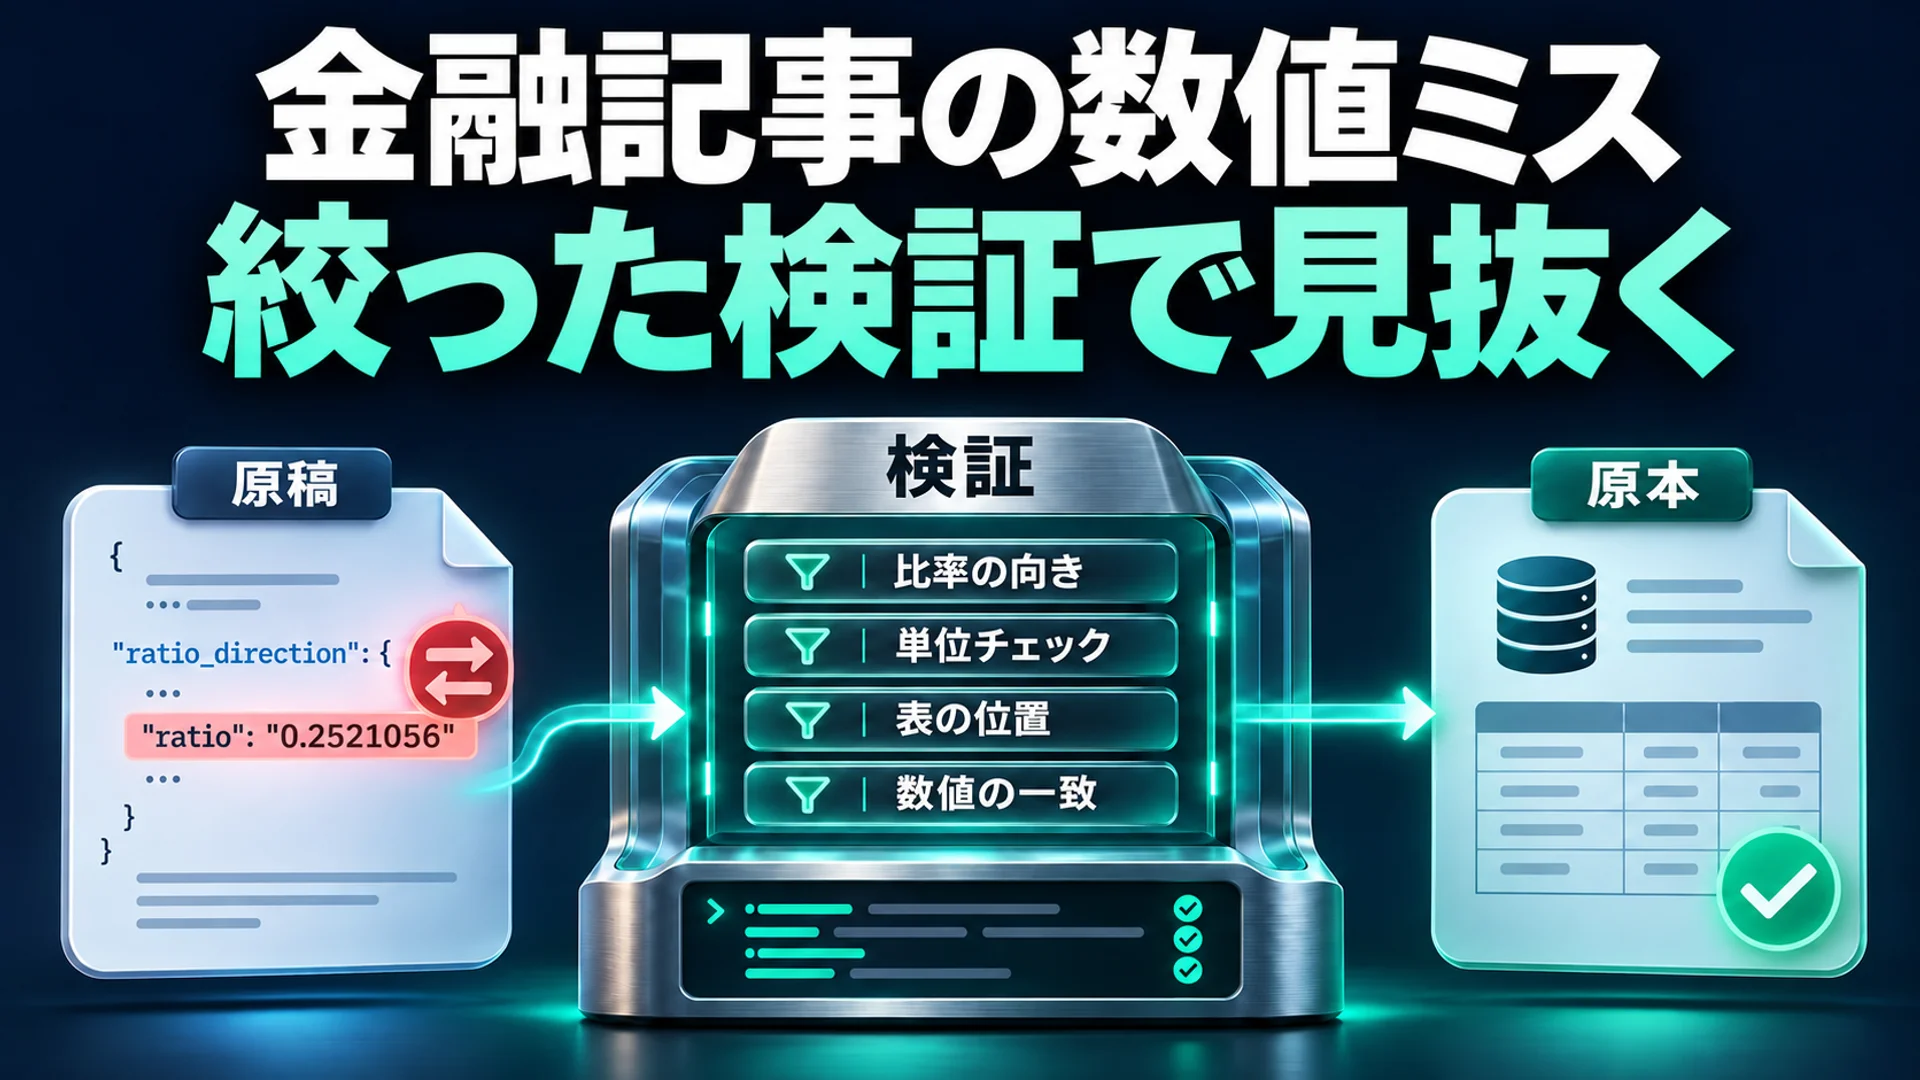
AIが草稿を書いた金融の記事を推敲する際、実務者は文の構造や語調に注目しがちです。しかし、開示解説ブログmacromalt.comを運営しているhs85-newbie氏は、プロンプトで「正確に確認せよ」と指示した後に推敲段階で文だけを点検し、核心となる数値の確認を飛ばしてしまい、実際の開示と異なる金額のまま公開してしまった経験を振り返っています1。文章は滑らかなのに数字だけが誤っている記事は、書いた人も読む人も気づきにくいものです。
AIと原データの間で数値検証を自動的に行う「ファクトチェックMCPサーバー」はどのように構成すべきでしょうか。公開されているkorea-finance-factcheckサーバーの構造がその問いに対する答えを示しています。核心は、「何でも検証してくれる巨大なエンジン」ではなく、実際に発生したエラーの類型別に範囲を狭めた検査関数を定義することです。各関数が公式APIを直接呼び出し、AIの出力と原データとの不一致を検出するようにし、検証できない項目は「未検証」として明確に処理しなければなりません。境界を狭めて警告疲れを軽減する設計が、機能の前提となります。
なぜ文章ではなく「数字」を確認すべきか
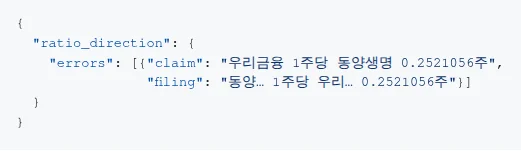
金融レポートにおける数値エラーは、誤字脱字と異なり、事実そのものを歪めます。hs85-newbie氏はAIと協力して記事を書く過程で、三つの類型のエラーに実際に直面しました2。
第一に、比率の方向逆転です。開示には「東洋生命1株あたりWOORIフィナンシャル0.2521056株」と記載されていますが、AIは「WOORIフィナンシャル1株あたり東洋生命0.2521056株」と分母と分子を入れ替えて記載しました。第二に、単位の混用です。原単位で記載された金額に「百万円」というラベルが付与され、売上高と営業利益が10倍、100倍に過大表示され、このミスは公開された記事8本にそのまま掲載されました。第三に、オフセット誤読です。米財務省の金利表を読み取る際に行・列の位置がずれて、10年債金利の箇所に7年債金利を転記しました2。
注視すべきは、これらのエラーがモデルの言語的な限界によって発生したわけではないという事実です。hs85-newbie氏は「三度ともモデルは受け取った通りに書いた」と記しています2。比率を逆に読み、単位のラベルを付与したのは人の側の誤読と推敲の空白が原因であり、モデルはその入力を忠実に転記しただけです。プロンプトで正確性を強調しても、原データとの照合がパイプラインに構造的に組み込まれていなければ、エラーは残ります。AIレポートの品質はモデル性能だけの問題ではなく、検証インフラがどれほどよく接続されているかの問題です。
MCPサーバーはAIと原データの間どのように位置づけられるか
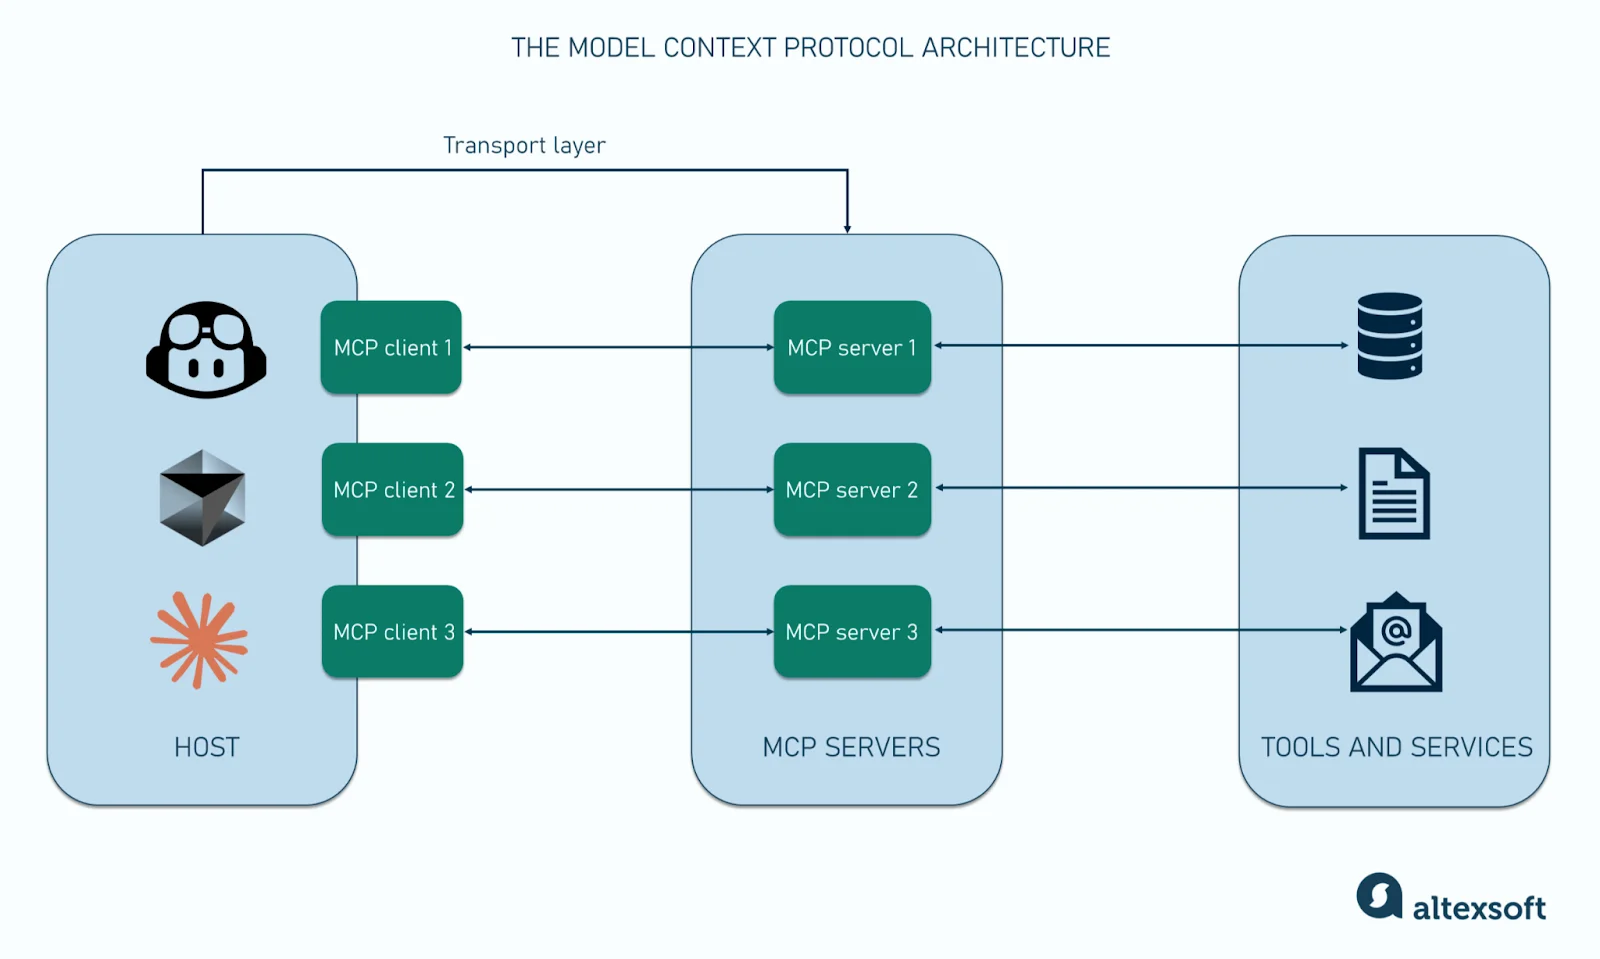
ファクトチェックを自動化するには、AIが原データを呼び出すための標準化された経路が必要です。ここでMCP(Model Context Protocol)が活用されます。
MCPはAIアプリケーションが外部データソースやツールと接続される方法を標準化します。基本構造はホスト(AIアプリケーション)→クライアント(コネクタ)→サーバー(機能公開プログラム)へとつながる三者構造であり、サーバーはツール(tools)、リソース(resources)、プロンプト(prompts)を公開します3。企業内のAIアプリがN個あり、データソースがM個ある場合、標準なしに個別のコネクタを作成するとN×M個の接続が必要になります。MCPはこれを標準プロトコル一つに削減します3。
korea-finance-factcheckサーバーは、この構造の「tools」プリミティブを活用し、LLMに対して「原稿の数字を公式データと照合する機能」を提供します。Claudeや社内AIエージェントが原稿を渡すと、サーバーはツール呼び出し(tools/call)を受け取り、DART開示、韓国銀行ECOS、米財務省、韓国取引所(KRX)などを直接照会し、比較結果をJSONで返却します。なお、2026年7月28日に改定されたMCP仕様では、プロトコル層がステートレス(stateless)へ移行しました。各リクエストが自前のバージョンとメタデータを含むよう変更され、サーバーインスタンス間で状態を共有することなくラウンドロビンロードバランシングで水平スケールが可能になりました3。
スコープを狭めた4種類の検査関数の設計
korea-finance-factcheckが注目すべき理由は、「すべての数字を検査する」と主張しないことです。hs85-newbie氏は検査範囲を意図的に狭め、警告疲れを防止しました2。
1. check_ratio_direction:方向エラー
合併・株式交換比率の文を開示原文と比較します。本文に「X 1株あたりY n株」があれば、開示に記載されている交付・受取主体が入れ替わった文を検出します2。本文に受付番号があればDARTから開示情報を取得し、なければ本文に記載された表記と照合します。
2. check_unit_errors:単位エラー
銘柄コード(例:Samsung Electronics 005930)とともに記載された売上高、営業利益、純利益をDART事業報告書と照合します。ただし、10倍、100倍、1000倍の単位でずれた数字のみを選別して報告します。hs85-newbie氏は、証券会社の予測値のように元々開示と異なる数字まで捕捉すると警告が多くなりすぎため、わざと範囲を狭めたと明示しました2。
3. check_market_numbers:市場指標のオフセットエラー
米財務省資料の2年債・5年債・10年債・30年債の国債金利と、韓国銀行ECOSのKOSPI終値・基準金利・為替レートを照会します。特に為替レートの検証では、週末の終値とECOSの売買基準率という構造的な差異を考慮し、15ウォン以上差が出た場合のみ警告を発します2。これは些細な表記の差異をエラーとして検出しないための仕組みです。
4. check_stock_closes:終値の誤読
「終値」または「引け」と明記された原単位で書かれた数字をKRX公式終値と比較します。目標株価を終値と誤読しないよう、「終値」という単語の条件を厳密に設けました。注視すべき点は、騰落率の検証を除外したことです。hs85-newbie氏は「『9月30日以降18.8%下落』のような期間収益率を一日の騰落と誤って読んだことがあったため」騰落率は見ないと記しています2。
これら4種類の検査に共通するのは、エラーの原因自体が狭く定義された関数であるという点です。hs85-newbie氏は「手で捏造した数字だけを見るテストでは実際のミスを捕捉できなかったため」、テストに実際に誤っていた文をそのまま入れたと説明しています2。
パイプラインの配置と例外処理のワークフロー
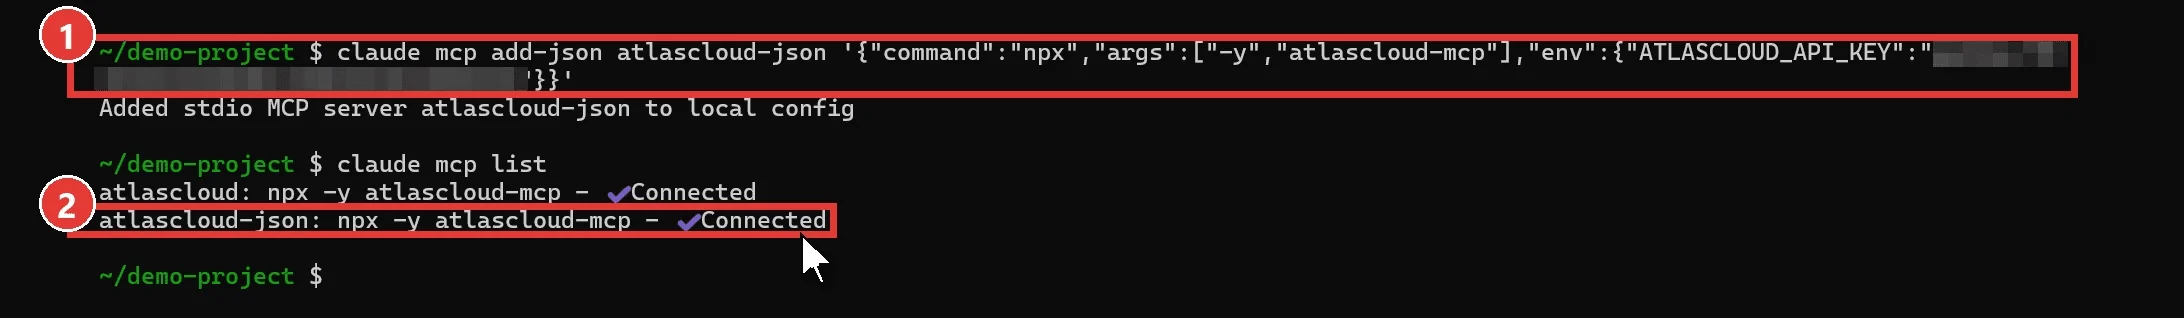
インストールは簡単です。uvがある環境であれば、Claude Codeで以下のコマンドで登録します2。
claude mcp add korea-finance-factcheck \
  -e DART_API_KEY=발급받은_키 \
  -e ECOS_API_KEY=발급받은_키 \
  -e KRX_API_KEY=발급받은_키 \
  -- uvx korea-finance-factcheck
Claude Desktopではclaude_desktop_config.jsonにmcpServers設定を入れます2。
{
  "mcpServers": {
    "korea-finance-factcheck": {
      "command": "uvx",
      "args": ["korea-finance-factcheck"],
      "env": {
        "DART_API_KEY": "발급받은_키",
        "ECOS_API_KEY": "발급받은_키",
        "KRX_API_KEY": "발급받은_키"
      }
    }
  }
}注意点として、三つの機関(DART、ECOS、KRX)の認証キーをすべてそれぞれ取得して設定する必要があります。機関の約款により認証キーを他人と共有できず、サーバーはユーザーのキーを中央プロキシのように代わりに保管しません2。KRX Open APIは非商用利用のみ許可されており、結果を表示する際は出典として「KRX統計情報」と明記する必要があります2。
パイプラインの配置で重要なのは、例外処理のワークフローです。
- 照会失敗を通知します。APIキーがない、または照会自体が失敗した場合、
skippedフィールドに理由を明記します2。 - 部分失敗を許容します。
check_allを実行する際、一部の検査が失敗しても残りの結果は返却します2。 - 未検証を区別します。開示や公式統計に存在しない数字(証券会社の推定値、取引時間中の相場など)は判断せず、
unverifiedとして返却します2。
「判断不可」をエラーと区別し、人が最終確認を行うよう促すことが核心です。hs85-newbie氏は「検査ができなかった時も静かに見逃さない」という点を明確にし、検査失敗と対象外を分離しました2。
検証カバレッジと実際の限界
このサーバーの役割は、原データと本文の数字の一致の有無の照合に限定されます。hs85-newbie氏は「どの銘柄を買うか・売るかは指示せず、株価予測も示しません。結果を投資判断の根拠として使わないでください」と明確に線引きしました2。
限界も明確です。korea-finance-factcheckは、hs85-newbie氏自身が経験した三つのエラーの類型(比率の逆転、単位の混同、列オフセット)に基づいて設計されました2。hs85-newbie氏自身も「自分のブログで発生したミスだけを見て作ったものなので、他の人たちの記事でも役立つかわからない」とGeekNewsに記しています1。
したがって、このツール構造を適用する際は、自分のコンテンツで頻繁に発生するエラーの類型をまず定義する必要があります。投資レポートに頻出する証券会社コンセンサスやPER、PBRの数値エラーを捕捉するにはサーバーの範囲外であるため、「未検証」として返される可能性が高いです2。また、Naverデータは約款上範囲が狭いためネイティブ対応していません2。これは技術的な限界ではなく、データソースの約款上使用範囲が狭いことに伴う設計上の決定です。
AI金融記事の数字のエラーを捕捉するには、巨大な検証プラットフォームよりも、実際に発生したエラーの類型別に範囲を狭めた検査関数をMCPサーバーでまとめることが効果的です。各関数が公式APIを直接呼び出し、原データと照合し、検証不可能な項目はskippedおよびunverifiedとして透明に提示し、人が確認できるよう境界を設計することが、警告疲れなく確認を維持する条件です。
参考文献
- AI로 쓴 금융 글, 숫자 검사기 MCP | GeekNews · news.hada.io↩
- ↩
- Model Context Protocol architecture: An executive guide · kellton.com↩