Sam Altman, CEO de OpenAI, declaró el 29 de octubre de 2026 en una aparición en el podcast ‘Cheeky Pint’ que la inferencia local (Local Inference) en PCs personales es una "asignación terrible de recursos". El núcleo de su argumento es que, dado que los individuos poseen cantidades significativas de DRAM cuyo suministro es limitado y cuya tasa de utilización real es de apenas el 5%, la memoria debe reubicarse en los centros de datos de la nube desde la perspectiva de la asignación global de recursos 1, 2, 3. Esta declaración se evalúa como un evento simbólico que ilustra cómo el cuello de botella estructural del mercado de infraestructura de IA está desplazándose de la velocidad de cómputo a la memoria de gran capacidad, trascendiendo la mera discusión sobre la eficiencia técnica.
Ante esta teoría de la eficiencia centrada en la nube, Elon Musk, CEO de Tesla, respondió inmediatamente el 2 de noviembre de 2026 a través de X (antes Twitter), afirmando que "las personas también merecen tener su propia RAM (RAM)" 2, 3. Este choque entre los proveedores de servicios de IA basados en la nube y la soberanía del dispositivo de los usuarios personales está generando movimientos contradictorios en el mercado, como el aumento real de los precios de los semiconductores de memoria y la estrategia paralela de OpenAI de incorporar modelos de inferencia local. Examinamos, desde la perspectiva del ecosistema de hardware, la estructura real de costos a la que se enfrenta la IA on-device y la necesidad de estrategias de infraestructura híbrida.
Restricciones de oferta y multiplexación estadística: la ineficiencia estructural señalada por Altman
Detrás de la crítica de Sam Altman a la tasa de utilización de la memoria en los PCs personales se encuentra la explosiva y extrema demanda de infraestructura de cómputo para IA. Según el análisis de la firma de investigación de mercado TrendForce, los precios contractuales de la DRAM de uso general aumentaron entre un 13 % y un 18 % en el tercer trimestre de 2026 en comparación con el trimestre anterior, y se preveía un incremento adicional del 10 % al 15 % en el cuarto trimestre 3. Esto se debe a que, al asignarse prioridad a la capacidad de producción para productos destinados a servidores de IA, toda la cadena de suministro de DRAM muestra signos de dependencia de los proyectos de construcción de centros de datos de IA 3.
La causa raíz de la "ineficiencia" señalada por Altman radica en las diferencias en los métodos de posesión de recursos. La mayor ventaja de los centros de datos en la nube no reside en el rendimiento puro del hardware, sino en la "multiplexación estadística" (Statistical Multiplexing) 4, 5. Cuando las solicitudes de inferencia independientes (sin correlación) de numerosos usuarios se agrupan en un único pool (Pool), la infraestructura en la nube puede maximizar la utilización de los recursos hasta el límite mientras minimiza la latencia 5. Por el contrario, en los PCs personales, las costosas GPU y DRAM quedan ociosas mientras los usuarios duermen o dejan sus dispositivos inactivos durante largos periodos, lo que provoca inevitablemente un desperdicio de recursos en relación con los costos fijos; esta es una crítica válida desde la perspectiva de la infraestructura en la nube 5.
Además, sumadas a las características estructurales de la inversión de los fabricantes de semiconductores, existe el riesgo de que la escasez de oferta se vuelva persistente. La mención directa por parte de Altman sobre las razones por las que los fabricantes de DRAM se ven obligados a ser extremadamente cautelosos al expandir sus instalaciones ilustra claramente esta situación. La dolorosa experiencia del pasado, en la que las empresas de DRAM invirtieron 20.000 millones de dólares en inversión de instalaciones durante una recesión, pero solo generaron 19.000 millones de dólares en beneficios, actúa como un factor clave que retrasa la expansión de nuevas líneas 3.
| Elemento de comparación | PC personal (inferencia local) | Centro de datos en la nube |
|---|---|---|
| Perspectiva de uso de memoria | Numerosas horas de inactividad (se señala una tasa de utilización del 5 %) 1, 2, 3, 6 | Utilización máxima gracias a la multiplexación estadística de múltiples usuarios 4, 5 |
| Estructura de costos | Costos iniciales de hardware, además de gastos de electricidad y refrigeración 4 | Posibilidad de distribuir los costos fijos por unidad de cómputo mediante el procesamiento en lotes masivos 4 |
| Causas del cuello de botella | Limitaciones del ancho de banda de memoria en las GPU de consumo 5 | Limitaciones físicas de la infraestructura eléctrica y de la oferta/demanda de obleas de DRAM 3 |
El Proyecto Stargate y la crisis de suministro de DRAM que sacudieron el mercado de semiconductores
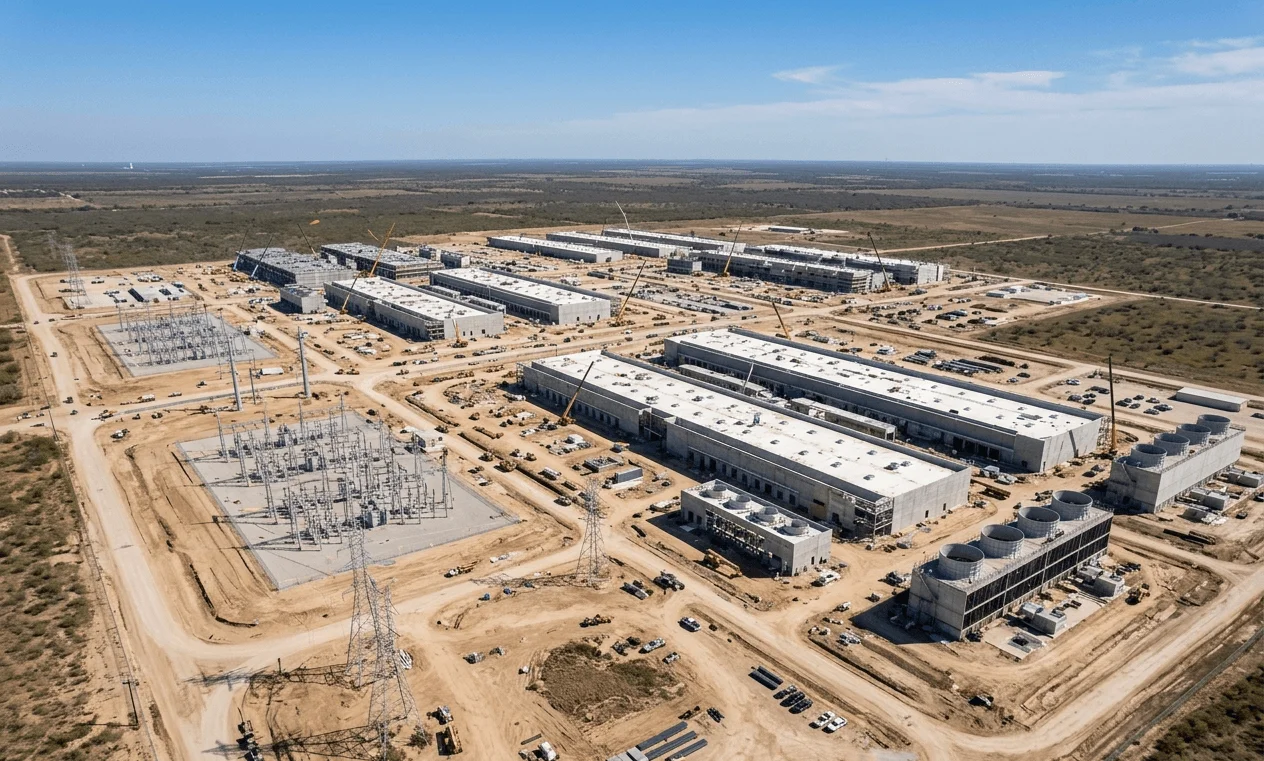
En la cadena de suministro de semiconductores de IA, mientras persiste la escasez de GPU, la oferta y demanda de memoria de gran capacidad (DRAM) y el ancho de banda de transferencia de datos se están convirtiendo en nuevos cuellos de botella 3. En este contexto, la estrategia de OpenAI para asegurar memoria está impactando directamente el mercado global de PCs y los precios de los semiconductores.
OpenAI, mientras impulsa su proyecto de construcción de centros de datos de IA conocido como ‘Stargate’ (Estrella Puerta), firmó en octubre de 2025 cartas de intención de suministro de memoria a gran escala con Samsung Electronics y SK Hynix 3. En ese momento, el grupo SK predijo que la demanda mensual máxima de DRAM requerida por el proyecto Stargate alcanzaría las 900.000 obleas (según la base de obleas) 3. Esta cifra representa aproximadamente el 40 % de la estimación de la producción mundial de DRAM, una cantidad abrumadora que constituye un ejemplo claro de cómo unas pocas empresas en la nube pueden absorber los recursos del mercado personal 3.
Este aumento explosivo de la demanda termina trasladándose a los precios del hardware que pagan los consumidores. A medida que aumenta la proporción de producción de memoria de alto ancho de banda (HBM), un producto de alto valor añadido para servidores de IA, surge una contradicción estructural en la que la DRAM de uso general, utilizada en los PCs personales, sufre escasez de oferta y sus precios suben 3. En comunidades en línea, entre otros espacios, han surgido críticas que señalan que, aunque las empresas de IA contribuyen a agudizar la escasez de suministro de memoria, cuestionan el uso de memoria en los PCs personales 3.
Punto de equilibrio de la inferencia local: condiciones para la competitividad de costos frente a la nube
¿Significa esto que la inversión en hardware de PCs personales o servidores locales es siempre un desperdicio? A pesar de las ventajas de escala de los servicios en la nube, la rentabilidad de la inferencia local se maximiza bajo ciertas condiciones. La eficiencia de costos entre la nube y la inferencia local está determinada por dos variables: el "volumen de uso" y el "control de los datos".
Según un análisis basado en datos de junio y agosto de 2026, comparar únicamente el precio unitario por token de las API en la nube al implementar un LLM (modelo de lenguaje grande) es caer en la trampa del cálculo de costos 4. Si bien los entornos locales incluyen no solo los costos iniciales de hardware, sino también costos operativos ocultos como la electricidad y la refrigeración, se alcanza el punto de equilibrio una vez que el uso supera cierto umbral 4.
| Nivel de uso (diario) | Costo estimado de la API en la nube (basado en OpenAI GPT-4.1) | Ejemplo de configuración de infraestructura en entorno local |
|---|---|---|
| Ligero (menos de 1 millón de tokens) | 105 dólares mensuales (1.260 dólares anuales) 4 | La recuperación de la inversión inicial parece lejana (Mac Studio, RTX 5090, etc.) 4 |
| Medio (de 1 a 10 millones de tokens) | Aumenta hasta 12.600 dólares anuales 4 | Es posible considerar estaciones de trabajo con doble RTX 5090 4 |
| Intensivo (más de 10 millones de tokens) | Se dispara a 126.000 dólares anuales 4 | La reducción del TCO (Costo Total de Propiedad) a largo plazo es viable mediante clusters de servidores H200 o MI325X (130.000 a 310.000 dólares) 4 |
En el caso de un entorno con una RTX 5080, si se espera un uso medio o superior a una hora diaria, se ha observado que la recuperación del costo del hardware es más rápida que el pago de las tarifas de la API. En este escenario, se puede alcanzar el punto de equilibrio en aproximadamente cinco meses 5. Además, las API en la nube no pueden evitar problemas como los límites de tasa (Rate Limit) cuando las solicitudes se disparan, y deben asumir riesgos de privacidad debido a los costos de salida de datos (Egress) y la necesidad de exponer los datos a empresas externas 4. La inferencia local goza de una ventaja insustituible para la nube bajo condiciones estrictas claras: garantiza la disponibilidad incluso en entornos sin conexión de red y no extrae los datos al exterior 5.
La estrategia de modelos locales de OpenAI, contradictoria con las declaraciones de Altman
A pesar de que Sam Altman defendió la eficiencia de la infraestructura en la nube y criticó la apropiación de recursos por parte de los dispositivos personales, la estrategia real de productos de OpenAI presenta una dualidad que abraza el entorno de inferencia local (inferencia on-device). Esto también sugiere que las declaraciones de Altman incluyen en cierta medida la perspectiva de un "vendedor de productos" que busca defender su modelo de negocio de servicios en la nube 1, 3.
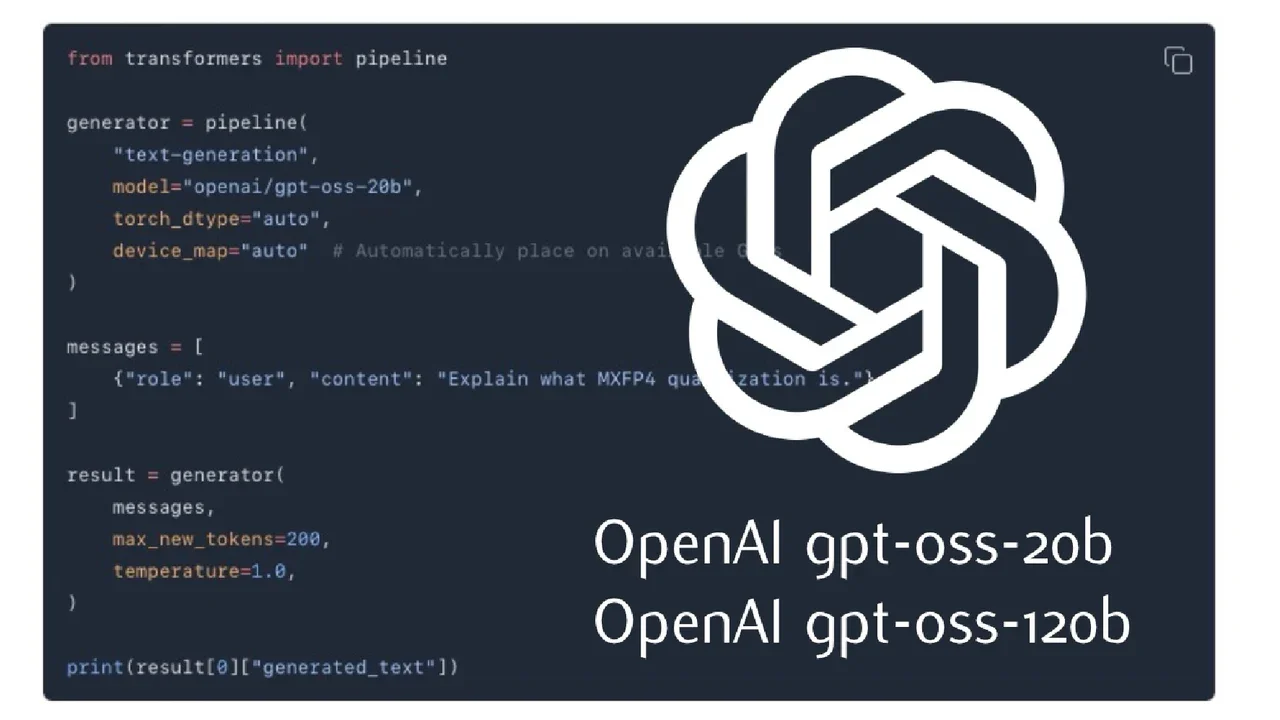
La serie de modelos de pesos abiertos de OpenAI, gpt-oss, es un ejemplo representativo de aceptación del entorno de inferencia on-device, sobre el cual se están realizando análisis a agosto de 2026 5. Un aspecto notable es que la inferencia local no implica necesariamente la ejecución en dispositivos de bajas especificaciones. La línea de estos modelos exige un límite inferior claro de hardware.
- El modelo
gpt-oss-20bestá diseñado para ejecutarse en PCs personales equipados con 16 GB de memoria 5. - El modelo grande
gpt-oss-120brequiere un entorno de GPU de más de 80 GB que supere el escritorio personal (por ejemplo, equipos de nivel workstation) 5.
A pesar de que las expectativas sobre el rendimiento del hardware siguen siendo altas, OpenAI deja abierta la posibilidad de la inferencia local. En particular, reflejando la tendencia híbrida en la que las fronteras entre la inferencia local y la inferencia en la nube se difuminan, el 28 de octubre de 2026 implementó una política que otorga a los suscriptores de pago de ChatGPT hasta 500 dólares mensuales en créditos de API para apoyar el desarrollo de aplicaciones y agentes 6.
Esta estrategia de múltiples vías puede verse como un equilibrio sofisticado que distribuye el entorno de experimentación del desarrollo de IA en entornos locales, mientras absorbe la demanda esencial que requiere inferencia compleja y procesamiento de contextos largos en su propia infraestructura en la nube. Se interpreta como la intención de demostrar la ventaja estructural de la nube de que "no se puede cortar completamente la dependencia de los centros de datos", al mismo tiempo que suministra sus propios modelos de pesos abiertos para no ser marginada por la expansión del ecosistema de IA local.
La reacción inmediata del mercado de hardware y el futuro del mercado tecnológico
La teoría del desperdicio de recursos de Sam Altman y las perspectivas de la industria de infraestructura de IA para defenderla estimularon el sentimiento de los consumidores a través de los comentarios en redes sociales de Elon Musk. Utilizando su posición como CEO de Tesla, Musk defendió la "propiedad del hardware del usuario" contra la lógica de Altman de que se debe devolver la RAM a la nube 2, 3. Esto muestra claramente el fenómeno en el que la filosofía de nivelación ascendente, que sostiene que la expansión de la infraestructura de IA no debe limitar el acceso tecnológico individual, choca con una visión intensiva en la nube 2.
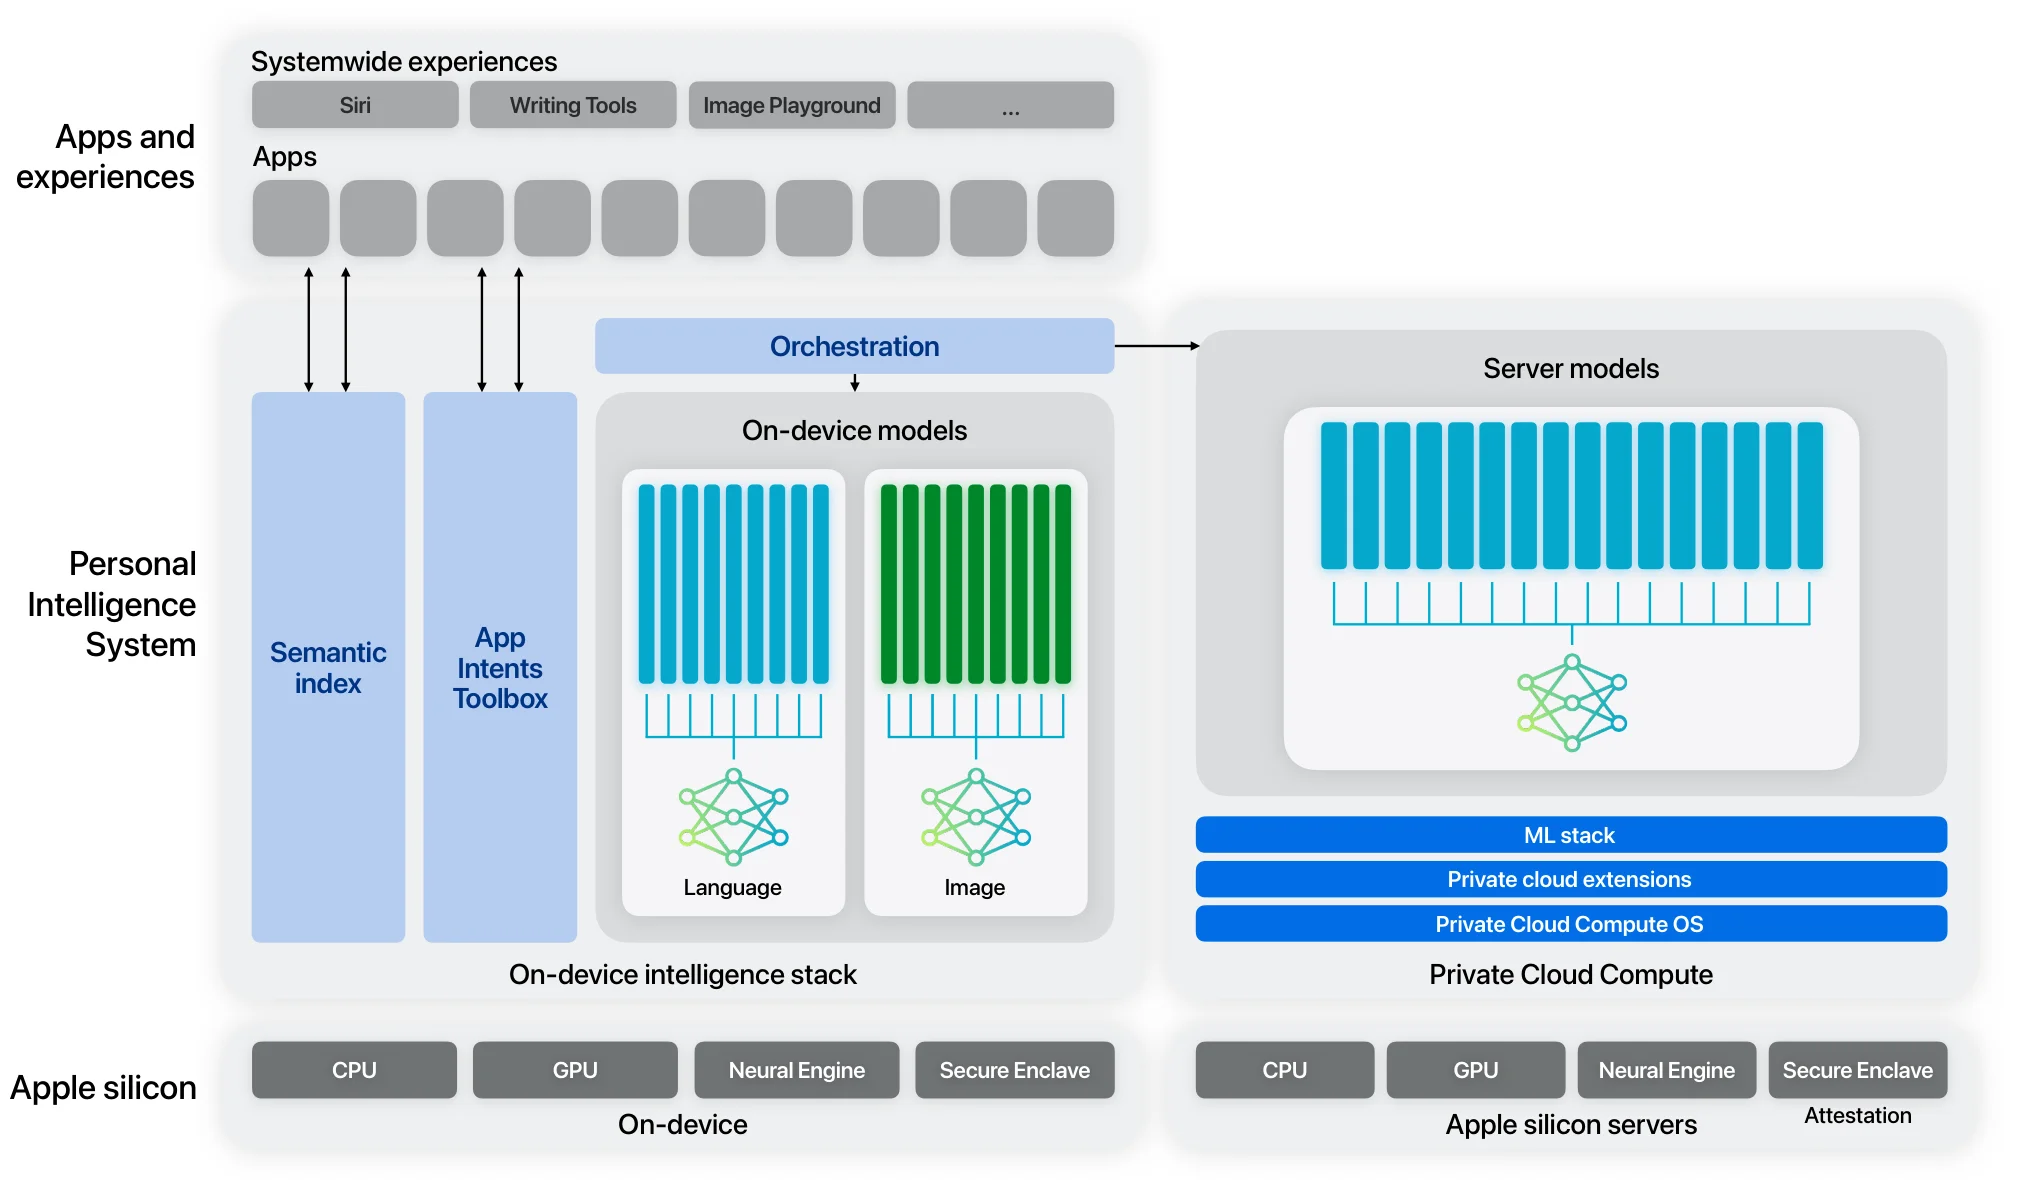
En última instancia, es probable que la situación no derive en un "juego de suma cero" donde los dispositivos locales personales o los centros de datos en la nube eliminen completamente al otro. Como demuestran la Computación Privada en la Nube (Private Cloud Compute) de Apple o las API de inferencia híbrida de Android, el mercado de dispositivos futuro evoluciona hacia formas que fusionan ambos métodos 5. La ubicación final del despliegue se determina considerando las políticas de movimiento de datos, la estabilidad de Internet, la complejidad de las tareas y la volatilidad de la demanda 5.
En una situación donde el centro de gravedad físico del cómputo de IA se ha desplazado hacia la competencia por la adquisición de memoria de gran capacidad (DRAM), los usuarios individuales y los desarrolladores deben establecer claramente criterios para elegir su infraestructura según la sensibilidad de sus datos y el volumen de procesamiento. Si bien no se puede ignorar por completo la ventaja estadística de la infraestructura en la nube de alta densidad, la justificación de los entornos locales para el procesamiento de grandes volúmenes de datos y la reducción de la dependencia de la red sigue siendo igualmente poderosa. Las palabras y acciones de Altman y Musk sobre los recursos de hardware no son simples disputas en redes sociales, sino la primera señal áspera del proceso de diferenciación del ecosistema de infraestructura de IA.
Referencias
- ↩
- 올트먼 "PC 램은 낭비"…머스크 "사람들도 램 가질 자격 있어" · gall.dcinside.com↩
- 올트먼 "PC 램은 낭비"…머스크 "사람들도 램 가질 자격 있어" [IT썰] · n.news.naver.com↩
- ↩
- Local AI vs. Cloud AI: Which Is Better? | AI Flow Harbor · aiflowharbor.com↩
- ↩



