INERITブログのコンテンツ生成ワークフローに画像生成を組み込み、代表画像も同時に作成したいと考えました。本文が完成しても、サムネイルを別々に作成してアップロードする必要があるなら、最終工程は依然として人の手作業に残るからです。コンテンツを複数の言語で提供しているため、画像内のテキストも該当する言語に合わせる必要がありました。
すでに使用していたCodexでは画像を作成できました。そこで気になる点が生まれました。この機能をブログサーバーからも呼び出せるだろうか?
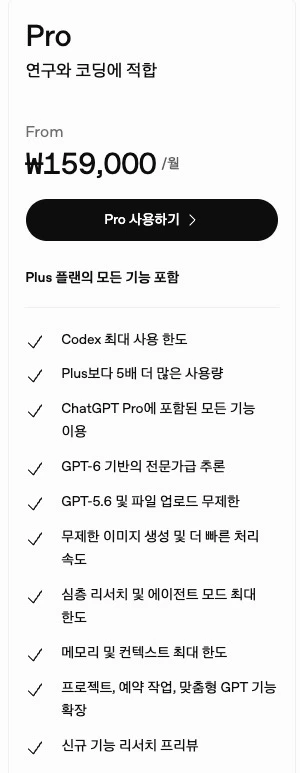
ChatGPT Pro商品の案内画面。本記事で実装した実行経路はCodex CLIです。
最終的には、ChatGPTアカウントでログインしたCodex CLIとHTTPサーバーを一つのコンテナにまとめました。ブログが画像処理をリクエストすると、ワーカーがCLIを実行し、生成されたファイルを受け取ってブログのリポジトリにアップロードします。ブログ側から見ると画像生成APIを呼び出しているように見えますが、内部で実行されているのはログイン済みのCLIです。この画像処理は、別途のImage APIクレジットを使用せず、Codexサブスクライブの使用量として処理されます。 既に利用していた機能をブログから呼び出せるようにした点が核心です。
本記事は、この接続を構築する過程で確認した動作と、サムネイルのためにコンテンツ全体を再生成せずに済むように変更したプロセスを取り上げます。確認した稼働バージョンはCodex CLI 0.164.0、Node.js 24であり、確認日は2026年11月5日です。
まず確認したのはログイン方式と実際の画像ファイル
CodexにはChatGPTサブスクリプションでログインする方法と、APIキーで認証する方法があります。今回の実装では前者を使用しました。ブログに設定するキーは、自社製のHTTPサーバーにアクセスするためのアプリキーであり、Codexのログイン資格情報はサーバー内部で個別に管理しています。つまり、2つの認証を分離した形です。公式認証ドキュメント
公式ドキュメントには、内蔵画像生成が通常のCodex使用量制限に含まれる旨が記載されています。また、codex execは保存済みのCLI認証情報を再利用でき、--jsonで実行イベントを送信できます。この2つの機能を連携させれば、サーバー側で扱えるだろうと判断しました。画像生成ドキュメント、非対話型実行ドキュメント
ただし、コマンドを実行できるという事実だけでは、画像生成まで完了するとは断定できません。確認すべきは、サーバーの非対話型実行環境でも内蔵画像ツールが呼び出され、実際の結果ファイルが生成されるかどうかでした。
稼働中のバージョンでは、この経路でPNGを取得できました。ワーカーはcodex exec --jsonのthread.startedイベントから実行IDを取得し、該当する実行のCODEX_HOME/generated_images/<thread-id>ディレクトリから結果を収集します。
ここで成功条件を、モデルの最終的な回答には置きませんでした。「画像を作成しました」という文章や、プロセスの終了コードだけでは、ブログに添付するファイルが存在することは保証できません。該当する実行のPNGが存在し、ファイル形式とサイズの検査を通過して初めて、画像処理を成功として扱いました。 指定サイズに変換する際には、実際の画像デコードまで実行しています。
generated_imagesのパスとイベント処理方式は、このバージョンの実装を基準に確認した動作です。これが、CLIバージョンを固定した理由でもあります。
CLIの前に小さなジョブAPIを設置した
ブログが、CLIの出力やログインファイルを直接扱うことはしませんでした。Node.jsサーバーに必要なリクエストだけを定義し、その内部でCLIを実行するという構成に分離しました。
呼び出しの流れは以下の通りです。
블로그 워커 → 내부 HTTP API → Codex CLI → PNG 검증 → 블로그의 WebP 저장
画像APIとCLIは同じコンテナ内で実行します。生成ファイルを回収しやすく、CLIのバージョンと実行環境も一緒に固定できるからです。ブログ側には、プロンプト、解像度、ジョブステータスなど、必要な値のみを公開しました。
リクエストの形式は次のように定めました。以下のパスとパラメータは自社製ラッパーの仕様です。
POST /images HTTP/1.1
Authorization: Bearer <internal-app-key>
Idempotency-Key: <saved-request-id>
Content-Type: application/json

{
  "prompt": "블로그 썸네일. 터미널에서 이미지 작업이 실행되는 장면. 큰 한글 제목은 'Codex로 썸네일 자동화'.",
  "size": "1920x1080",
  "effort": "medium"
}
サーバーは、画像が完成するまでこの接続を保持する代わりに、HTTP 202とジョブIDを返します。ブログはGET /images/{id}でステータスを確認し、成功すればGET /images/{id}/fileでPNGを取得します。ステータス照会とダウンロードにも、同じアプリ認証が必要です。
同期応答を返す互換性のある経路も実装しましたが、ブログ側ではジョブIDを受け取る方式を使用しています。生成に時間がかかる場合や、ブログのプロセスが再起動された場合でも、どのジョブを待っていたかを識別できるようにする必要がありました。
CLIの実行には、Node.jsのspawn()を使用しました。コマンドとオプションは引数配列として渡し、shell: falseで実行します。画像の説明は標準入力経由で伝えます。プロンプトをシェルコマンドの文字列に結合したりはしません。
また、ワーカーの環境変数を必要な項目に限定しました。ブログのアプリキーや別個のOpenAI APIキーを、CLIの子プロセスにそのまま継承せず、画像生成に不要なシェル・アプリ・プラグインタスクも無効化しました。このワーカーの役割は、内蔵ツールで画像を1枚作成することだけです。
サムネイルが失敗したからといって、コンテンツを書き直す必要はなかった
画像を1枚作成することよりも、失敗後の処理に気を配りました。
タイトルと本文の画像が準備できていた状態で、サムネイル生成や保存中にエラーが発生した場合、最初から再実行する方式では、既に完了した処理まで繰り返すことになります。新しく書き直された本文が前回と異なる可能性もあり、画像生成も重複する恐れがあります。
そのため、ブログのサムネイル段階で、以下の情報を保持するようにしました。
- 確定済みの画像プロンプトとリファレンス
- 画像サーバーに送信したリクエストID
- 画像サーバーが返したジョブID
- 生成済みだが、まだリポジトリにアップロードしていない画像バイトデータ
失敗の位置によって、継続すべき作業が異なります。画像サーバーにはジョブが受け付けられているものの、応答を受け取る前に接続が切断された場合、同じリクエストIDで既に受け付けられたジョブを探します。PNGを取得後にリポジトリへのアップロードだけが失敗した場合、保存しておいたバイトデータでアップロードを再試行します。
ここで使用するものがIdempotency-Keyです。同じアプリが同じキーとリクエスト内容で再送信した場合は既存のジョブを返し、同じキーで異なる内容を送信した場合は409を返すようにしました。
しかし、これだけでは復旧には不十分でした。サーバー再起動の間に、画像サイズやプロンプト設定が変更されると、ブログが再構築したリクエストが、最初に送信した内容と異なる可能性があるためです。既に受け付けたジョブが存在する場合でも、再リクエストが競合することがあります。
そこで、リクエストキーでジョブを検索する照会経路も追加しました。
GET /images?request_id=<saved-request-id>
Authorization: Bearer <internal-app-key>
ブログは保存済みのジョブIDがなくても、この経路から確認を開始します。既存のジョブがあればその結果を引き継ぎ、存在しない場合のみ新規リクエストを行います。これは、現在の設定から過去の送信内容を再作成して送る処理と、過去の送信内容自体を検索する処理を区別したことになります。
もちろん、画像ワーカーのプロセス自体が終了した場合は異なります。待機中のジョブは復元しますが、実行中に切断されたジョブはinterruptedとして終了処理を行います。終了したCLIの実行をそのまま継続して生成できると保証はしません。新しい画像ジョブが必要になっても、ブログの本文と前段階の結果は残ります。
解像度とリファレンスは自社製APIの契約事項だった
プロンプト以外に何をパラメータとして受け取るかも決定する必要がありました。ブログでは記事ごとに複数枚を一括リクエストする必要がなかったため、1つのリクエストで1枚の画像を作成するよう制限しました。
| パラメータ | このラッパーでの意味 |
|---|---|
prompt | 画像の内容と構図 |
size | 最終的に返すファイルの幅と高さ |
effort | Codexの推論努力レベルの設定 |
reference_images | 必要に応じて添付する参照画像 |
transparent_background | 透明背景のリクエスト |
特にsizeとeffortは、名前だけ見て意味を誤解しやすい項目です。
size: "1920x1080"は返されるPNGのサイズを指します。まず該当比率で生成するようリクエストしますが、内蔵ツールが別のサイズを返す場合があるため、サーバー側で最終サイズを調整しています。元の縦横比が異なる場合は中央を基準に切り抜いてリサイズするため、端の文字や被写体が切れる可能性があります。生成プロンプトでも安全マージンを確保するよう指示しており、サムネイルを確認する際はサイズだけでなく構図も併せて見る必要がありました。この設定は、モデルのネイティブ生成解像度を保証するものではありません。
effortは、Codexのmodel_reasoning_effortに接続しました。画像APIの品質レベルと同じ値として扱うことはしていません。
リファレンスは選択的に使用します。実際の製品や画面の形状が重要である場合は役立ちますが、抽象的な開発テーマに無関係な写真を無理に添付する必要はありません。ブログ側では候補画像の実内容を確認して使用可否を判断し、選択したファイルのみをワーカーに渡します。
サーバーはリモート画像URLや任意のファイルパスを受け取る代わりに、サイズが制限されたPNG・JPEG・WebPバイトデータを受け取り検証します。これをジョブディレクトリに保存し、CLIの--image入力と内蔵ツールの参照パスとして渡します。現在の実装では最大5枚に制限しています。この数値は、稼働中のCodex内蔵ツールに合わせた制限であり、公式Image APIの入力上限と同一であるとは仮定していません。
完成したPNGは、ブログでWebPに変換してからオブジェクトストレージに保存します。現在の画質は85で、長い辺が3840ピクセルを超える場合は縮小しています。読者のブラウザはこの保存された画像を読み込むため、ページを開くたびにCodexを呼び出す必要はありません。
Kubernetesではログイン情報とジョブステータスを永続化した
コンテナにCLIをインストールするだけでは、サブスクリプションログインを維持できません。ポッドが交換された際に認証情報が失われると、画像生成も再ログインするまで停止してしまいます。
サーバーにはアカウントごとのCODEX_HOMEを置き、永続ボリュームに保存しました。ブラウザのないサーバーでログインする際は、デバイスコード認証を使用しました。
codex login --device-authサーバーが表示したアドレスをユーザーのブラウザで開いてコードを入力すると、ログイン結果が該当するCLI環境に保存されます。ログインファイルは資格情報であるため、コンテナイメージやGitリポジトリには含めません。この方式とファイルの扱い基準は、公式認証ドキュメントでも説明されています。ヘッドレス環境でのログイン
アプリに渡すキーと、このログインファイルは寿命も異なります。ブログの呼び出しキーを入れ替えたからといって、Codexアカウントに再ログインする必要はありません。画像サーバーにはアプリキーのハッシュ値を保存し、リクエストの所有者を基準にジョブやファイルへのアクセスを区別しています。
現在の画像サーバーは、ファイルベースのキューを使用する単一インスタンス構成です。Kubernetesへのデプロイも、単一レプリカとRecreate戦略を使用しており、ファイルロックで同一データディレクトリを2プロセスが同時に操作しないようにしています。この構成では、デプロイ中に短い停止時間が発生します。HTTPサーバーのレプリカだけを拡張しても、安全にスケールアウトできる構成だとは見なしませんでした。
同時実行数と待機列にも上限を設けています。使用量制限に達した場合は待機状態として扱い、生成タイムアウトとリトライ回数を制限しています。安全システムが構図を遮断した場合は、一般的な一時的なエラーと区別して返します。
ブログに組み込んだ後に変わったこと
現在、ブログは記事のタイトルと本文からサムネイル用ガイドを作成し、必要に応じてリファレンスを選択した後、この内部APIを呼び出しています。生成された画像をWebPで保存すれば記事にリンクされ、エラーが発生した場合はサムネイル段階のステータスが記録されます。本文を書き直さなくても、画像処理を継続できるようになりました。
実装の検証を進める中で、ラッパーの自動テスト14件も実行しました。重複リクエストの処理、再起動後のキュー復元、実行中断時の状態、リクエストの所有者別ファイルアクセス、リファレンス入力制限、実際のPNG収集とサイズ変換を確認しています。これらのテストは、生成器をスタブに置き換えてサーバーの動作を検査するものであり、すべてのテストがOpenAIに画像を生成させるわけではありません。
サブスクリプション制限は、依然として稼働上の制約条件です。公式ドキュメントでは、内蔵画像生成が画像を使用しない類似タスクよりも、含まれる制限を平均3〜5倍速く消費する場合があると説明しています。したがって、スループットを高めるには、生成時間と残りの使用量を併せて見る必要があります。公式にプログラムから画像を生成する経路はImage APIであり、本記事で説明しているのはブログ向けに構築したCLIラッパーです。画像生成と使用量制限
実装後に、APIクレジットの特典も判明した
本記事を整理する過程で、条件を満たしたProサブスクリプションは、自身のAPI組織を連携させてAPIクレジット特典を受け取れることも判明しました。このクレジットは公式のImages APIにも使用できます。特典を使用するには、API組織の連携や有効化など、該当する条件を満たす必要があります。サブスクライバー向けAPIクレジットのご案内
新たに知ったこの選択肢と今回の実装は、消費する使用量が異なります。APIクレジットで公式Image APIを呼び出した場合は、そのクレジットから減算されます。私が作成したラッパーは、ログイン済みCodexの内蔵ツールを実行するため、別途のImage APIクレジットを消費しません。
今回の構成により、APIクレジット残高とは別に、既に保有しているCodexの使用量制限をブログの画像生成に活用できるようになりました。 公式APIとサブスクリプションログイン方式が異なる使用量を消費することを知った結果、タスクの性質に応じて選択できる経路が1つ増えました。
翻訳のように待機できるタスクにも活用できる可能性がある
INERITブログのサムネイルは、読者がページを開く瞬間に生成する必要はありません。公開準備段階でジョブを任せ、結果を保存すれば十分です。即時応答が必要なチャットサービスよりも、生成の順序を待機する余地があります。
多言語翻訳も、同じ観点から拡張を検討する価値があります。原文と対象言語をジョブキューに投入し、CLIが返したタイトルと本文を検証した後に翻訳版として反映する方式です。コードブロック、リンク、引用、数値が保持されているかを確認し、失敗した言語のみ再処理すれば、原文を再作成する必要もありません。この経路を翻訳に適用することは、まだ実装していない今後の検証課題です。
ただし、CLIへ移行するからといって、翻訳に必要なトークン自体が減少するわけではありません。有料APIで処理していたタスクであれば、その一部をサブスクリプション使用量へ移行することで、別途APIで課金される使用量とコストを削減できる余地があります。その代わり、Codexの制限、待機時間、結果検証、リトライ運用の負担が生じます。現在、ブログ翻訳のトークン数やコストが削減されたことは測定していません。
今回実際に接続したのはサムネイル生成です。ブログは内部API経由で画像ジョブをリクエストし、Codexはサブスクリプションでログインした環境で生成を実行し、結果ファイルはブログが保存します。必要だったのは、迅速な一度の応答よりも、待機して利用可能な画像と、失敗後も残るジョブステータスでした。その条件のおかげで、Codexのサブスクリプション機能をブログからAPIのように活用できるようになりました。