Al crear el flujo de trabajo para generar publicaciones en el blog INERIT, quise crear también la imagen destacada. La razón es que, aunque el cuerpo del texto esté terminado, si debo crear y subir la miniatura por separado, el último paso sigue dependiendo de la intervención humana. Como ofrezco los textos en varios idiomas, también era necesario adaptar los textos dentro de las imágenes al idioma correspondiente.
En Codex, que ya utilizaba, era posible generar imágenes. Así que me surgió la duda: ¿Podría invocar esta función también desde el servidor del blog?
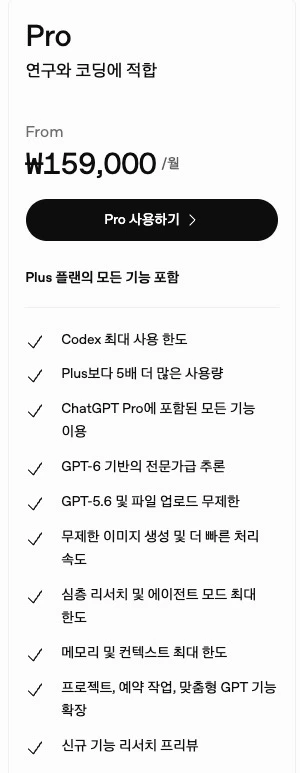
Pantalla informativa del producto ChatGPT Pro. La ruta de ejecución implementada en este texto es Codex CLI.
Finalmente, integré Codex CLI, autenticado con una cuenta de ChatGPT, y un servidor HTTP en un mismo contenedor. Cuando el blog solicita una tarea de imagen, un worker ejecuta la CLI, recupera los archivos generados y los sube al almacén del blog. Desde la perspectiva del blog, parece una llamada a una API de generación de imágenes, pero lo que se ejecuta internamente es una CLI autenticada. Esta tarea de imagen se gestiona mediante el consumo de uso de la suscripción a Codex, sin utilizar créditos separados de la API de Imágenes. Lo esencial es que logré invocar desde el blog una funcionalidad que ya estaba utilizando.
Este texto trata sobre el comportamiento verificado durante la creación de esa conexión y sobre el proceso de modificaciones realizadas para evitar que un fallo en la miniatura obligue a regenerar todo el texto. Las versiones operativas verificadas son Codex CLI 0.164.0 y Node.js 24, y la fecha de verificación es el 5 de noviembre de 2026.
Primero verifiqué el método de inicio de sesión y los archivos de imagen reales
En Codex, hay dos formas de autenticación: mediante una suscripción a ChatGPT o mediante una clave API. Para esta implementación utilicé la primera. Las claves incorporadas en el blog son claves de aplicación para acceder a mi propio servidor HTTP, mientras que las credenciales de inicio de sesión de Codex se gestionan por separado dentro del servidor. Así, separé las dos autenticaciones. Documentación oficial de autenticación
La documentación oficial indica que la generación integrada de imágenes está incluida en los límites de uso generales de Codex. Además, codex exec reutiliza las credenciales de la CLI guardadas, y se pueden emitir eventos de ejecución mediante --json. Al conectar estas dos funciones, determiné que era posible gestionarlas desde el servidor. Documentación de generación de imágenes, Documentación de ejecución no interactiva
Sin embargo, no se puede dar por hecho que la generación de imágenes funcionará solo por el hecho de que se pueda ejecutar un comando. Lo que debía verificar era si, en la ejecución no interactiva del servidor, se invocaba la herramienta integrada de imágenes y si se generaba realmente un archivo de resultado.
En la versión operativa, pude obtener PNGs por esta ruta. El worker recibe el ID de ejecución mediante el evento thread.started de codex exec --json y recopila los resultados desde el directorio CODEX_HOME/generated_images/<thread-id> de dicha ejecución.
En este punto, no definí la última respuesta del modelo como condición de éxito. Ni una frase como “se ha creado la imagen” ni el código de salida del proceso garantizan que exista un archivo para insertar en el blog. El éxito de la tarea de imagen se definía solo si existía el PNG correspondiente a esa ejecución y pasaba las comprobaciones de formato y tamaño de archivo. Cuando se convierte al tamaño especificado, incluso se ejecuta la decodificación real de la imagen.
Las rutas de generated_images y el modo de procesar los eventos son comportamientos verificados basados en la implementación de esta versión. Esa es también la razón por la que fijé la versión de la CLI.
Añadí una pequeña API de tareas ante la CLI
No permití que el blog manipule directamente la salida de la CLI o los archivos de autenticación. Definí en el servidor Node.js únicamente las solicitudes necesarias y establecí una división donde la CLI se ejecuta internamente.
El flujo de invocación es el siguiente:
블로그 워커 → 내부 HTTP API → Codex CLI → PNG 검증 → 블로그의 WebP 저장
La API de imágenes y la CLI se ejecutan en el mismo contenedor. Así, es fácil recuperar los archivos generados y fijar conjuntamente la versión de la CLI y el entorno de ejecución. Al blog solo se le expusieron los valores necesarios, como la solicitud, la resolución y el estado de la tarea.
La forma de la solicitud se definió de la siguiente manera. Las rutas y parámetros siguientes son la especificación del wrapper personalizado.
POST /images HTTP/1.1
Authorization: Bearer <internal-app-key>
Idempotency-Key: <saved-request-id>
Content-Type: application/json

{
  "prompt": "블로그 썸네일. 터미널에서 이미지 작업이 실행되는 장면. 큰 한글 제목은 'Codex로 썸네일 자동화'.",
  "size": "1920x1080",
  "effort": "medium"
}
En lugar de mantener la conexión hasta que la imagen esté completa, el servidor devuelve HTTP 202 y un ID de tarea. El blog comprueba el estado mediante GET /images/{id} y, en caso de éxito, obtiene el PNG mediante GET /images/{id}/file. La autenticación de la aplicación es necesaria también para la consulta de estado y la descarga.
Aunque implementé una ruta compatible que devuelve una respuesta síncrona, el blog utiliza el método de obtención de un ID de tarea. Era necesario poder identificar qué tarea se estaba esperando, incluso si la generación tardaba o si el proceso del blog se reiniciaba.
Para la ejecución de la CLI, utilicé spawn() de Node.js. El comando y las opciones se pasan como un arreglo de argumentos y se ejecutan mediante shell: false, mientras que la descripción de la imagen se transmite mediante la entrada estándar. No concateno la solicitud a la cadena del comando shell.
Además, limité las variables de entorno del worker a las necesarias. No transmití directamente a los procesos hijos de la CLI la clave de la aplicación del blog ni claves OpenAI API separadas, y desactivé también las herramientas de shell, aplicación y complementos que no eran necesarias para la generación de imágenes. La tarea de este worker es crear una sola imagen con la herramienta integrada.
No se debía reescribir el texto si fallaba la miniatura
Puse más atención en el comportamiento posterior al fallo que en la creación de una sola imagen.
Si el texto y las imágenes del contenido están listos, pero hay un error al generar o guardar la miniatura, un enfoque que vuelve a ejecutar todo desde el principio repite también trabajos ya finalizados. El cuerpo recién escrito podría diferir del anterior, y también podría haber duplicación en la generación de imágenes.
Por ello, hice que la etapa de miniaturas del blog conservase la siguiente información:
- La solicitud de imagen y la referencia confirmadas
- El ID de solicitud enviado al servidor de imágenes
- El ID de tarea devuelto por el servidor de imágenes
- Los bytes de imagen generados pero aún no subidos al almacén
La tarea a retomar varía según dónde se produjo el fallo. Si la tarea fue aceptada por el servidor de imágenes pero la conexión se interrumpió antes de recibir la respuesta, se busca la tarea ya aceptada mediante el mismo ID de solicitud. Si el PNG se recibió por completo pero falló únicamente la subida al almacén, se reintenta la subida con los bytes almacenados.
En este caso, se utiliza Idempotency-Key. Hice que, si la misma aplicación reenvía con la misma clave y el mismo contenido de solicitud, se devuelva la tarea existente; si se envía contenido diferente con la misma clave, se devuelva 409.
Sin embargo, solo con esto la recuperación no era suficiente. Si la configuración del tamaño de imagen o de la solicitud cambiaba entre reinicios del servidor, la solicitud reconstruida por el blog podría diferir de la enviada originalmente. Podría producirse un conflicto de reenvío incluso cuando ya existiera una tarea aceptada.
Por ello, añadí también una ruta de consulta que busca tareas mediante la clave de solicitud.
GET /images?request_id=<saved-request-id>
Authorization: Bearer <internal-app-key>
Incluso cuando el blog no tiene un ID de tarea guardado, primero comprueba esta ruta. Si hay una tarea existente, continúa recibiendo su resultado; solo realiza una nueva solicitud si no hay ninguna. Así, se distingue entre recrear y reenviar solicitudes pasadas con la configuración actual, y buscar en sí las solicitudes pasadas.
Por supuesto, el caso en que el propio proceso del worker de imágenes termina es diferente. Las tareas que estaban en cola se restauran, pero las interrumpidas durante la ejecución se cierran como interrupted. No se garantiza que la continuación de una ejecución de CLI terminada prosiga la generación tal cual. Aunque sea necesario iniciar una nueva tarea de imagen, el cuerpo del blog y los resultados de etapas anteriores permanecen.
La resolución y las referencias eran el contrato de la API personalizada
Además de la solicitud, también debí decidir qué recibir como parámetros. En el blog no era necesario solicitar varias imágenes a la vez por cada texto, así que limité que una solicitud generase una imagen.
| Parámetro | Significado en este wrapper |
|---|---|
prompt | Contenido y composición de la imagen |
size | Ancho y alto del archivo devuelto final |
effort | Configuración del esfuerzo de razonamiento de Codex |
reference_images | Imágenes de referencia adjuntas cuando sea necesario |
transparent_background | Solicitud de fondo transparente |
En particular, size e effort son fáciles de malinterpretar si solo se miran los nombres.
size: "1920x1080" significa el tamaño del PNG devuelto. Primero se solicita la generación con esa proporción, pero como la herramienta integrada puede devolver otras medidas, el servidor ajusta el tamaño final. Si la proporción original es distinta, se recorta y se redimensiona con el centro como referencia, por lo que los textos o sujetos de los bordes pueden quedar cortados. En la solicitud de generación también se exigió un margen de seguridad, y al revisar las miniaturas tuve que comprobar tanto el tamaño como la composición. Esta configuración no garantiza la resolución nativa de generación del modelo.
effort se conectó a model_reasoning_effort de Codex. No lo traté como un valor equivalente a la categoría de calidad de la API de Imágenes.
Las referencias se utilizan de forma opcional. Ayudan si es importante la forma de un producto real o de una interfaz, pero no hace falta forzar fotos irrelevantes para temas abstractos de desarrollo. En el blog decido si utilizarlas observando el contenido real de las imágenes candidatas y solo transmito al worker los archivos seleccionados.
En lugar de aceptar URL de imágenes remotas o rutas de archivos arbitrarias, el servidor recibe y valida bytes PNG, JPEG o WebP de tamaño limitado. Los guarda en el directorio de trabajo y los transmite como entrada --image de la CLI y como rutas de referencia de la herramienta integrada. La implementación actual limita a 5 imágenes como máximo. Esta cifra es un límite ajustado a la herramienta integrada de Codex en producción, y no asumí que fuera igual al límite de entrada de la API oficial de Imágenes.
El PNG completado lo convierte el blog a WebP y lo guarda en el almacenamiento de objetos. Actualmente, la calidad de conversión es 85, y si el lado mayor supera 3840 píxeles, se reduce. El navegador del lector lee esta imagen guardada, por lo que Codex no se invoca cada vez que se abre la página.
En Kubernetes conservé la autenticación y el estado de las tareas
Con solo instalar la CLI en un contenedor, no se puede mantener el inicio de sesión por suscripción. Si las credenciales desaparecen cuando se reemplaza un Pod, la generación de imágenes también se detiene hasta volver a iniciar sesión.
En el servidor configuré CODEX_HOME por cuenta y lo guardé en un volumen persistente. Para iniciar sesión desde un servidor sin navegador, utilicé la autenticación mediante código de dispositivo.
codex login --device-authSi se abre la URL mostrada por el servidor en el navegador del usuario e introduce el código, el resultado de la sesión se guarda en el entorno de esa CLI. Como los archivos de inicio de sesión son credenciales, no los incluyo en la imagen de contenedor ni en el repositorio Git. La documentación oficial de autenticación también explica este método y los criterios de manejo de archivos. Inicio de sesión en entornos headless
La clave que se otorga a la aplicación y este archivo de inicio de sesión también tienen ciclos de vida distintos. Reemplazar la clave de invocación del blog no obliga a volver a iniciar sesión en la cuenta de Codex. En el servidor de imágenes guardé el hash de las claves de aplicación y separé el acceso a tareas y archivos según el propietario de la solicitud.
Actualmente, el servidor de imágenes es una única instancia que usa una cola basada en archivos. El despliegue en Kubernetes también usa un solo replicado y la estrategia Recreate, con bloqueos de archivo para impedir que dos procesos operen simultáneamente el mismo directorio de datos. Esta configuración implica una breve interrupción durante el despliegue. No consideré que la estructura se ampliara de forma segura solo aumentando los replicados del servidor HTTP.
También establecí límites en el número de ejecuciones concurrentes y en la cola. Si se alcanza el límite de uso, se trata como estado en espera y se limitan el tiempo de espera de generación y el número de reintentos. Cuando el sistema de seguridad bloquea la composición, lo devuelvo diferenciado de los errores transitorios habituales.
Lo que cambió después de integrarlo en el blog
Ahora, el blog crea una guía de miniaturas a partir del título y el cuerpo del texto, selecciona referencias si es necesario y luego invoca esta API interna. Si la imagen generada se guarda en WebP, se vincula al texto; si hay un error, se conserva el estado de la etapa de miniaturas. Así, se puede continuar la tarea de imagen sin reescribir el cuerpo.
Al revisar la implementación, también ejecuté 14 pruebas automáticas del wrapper. Verifican el manejo de solicitudes duplicadas, la restauración de la cola tras reinicios, los estados de ejecución interrumpida, el acceso a archivos por propietario de solicitud, los límites de entrada de referencias y la recopilación real de PNG y la conversión de tamaño. Estas pruebas cambian el generador por un simulador para comprobar el comportamiento del servidor; no todas hacen que OpenAI genere una imagen.
El límite de suscripción sigue siendo una condición operativa. La documentación oficial explica que la generación integrada de imágenes puede consumir el límite incluido de 3 a 5 veces más rápido que tareas similares sin imágenes. Por tanto, para aumentar el caudal, debo mirar a la vez el tiempo de generación y el límite restante. La ruta oficialmente documentada para generar imágenes programáticamente es la API de Imágenes, mientras que lo aquí descrito es un wrapper CLI configurado para mi blog. Generación de imágenes y límites de uso
Después de implementar también conocí el beneficio de créditos API
Al redactar este texto, también me enteré de que las suscripciones Pro que cumplen las condiciones pueden beneficiarse de créditos API conectando una organización API propia. Dichos créditos también se pueden usar en la API oficial de Imágenes. Para utilizar el beneficio hay que cumplir condiciones como conectar y activar la organización API. Información sobre créditos API para suscriptores
Esta opción que acabo de conocer y la implementación actual utilizan límites diferentes. Si se invoca la API oficial de Imágenes con créditos API, se descuentan de esos créditos. Mi wrapper ejecuta la herramienta integrada de Codex autenticada, por lo que no consume créditos separados de la API de Imágenes.
Con esta configuración, pude aprovechar el límite de uso de Codex que ya poseo para la generación de imágenes del blog, aparte del saldo de créditos API. Al saber que la API oficial y el método de suscripción con inicio de sesión consumen cantidades distintas, surgió una ruta más que se puede elegir según la naturaleza del trabajo.
También se puede usar en trabajos que puedan esperar, como la traducción
Las miniaturas del blog INERIT no necesitan generarse en el momento en que el lector abre la página. Basta con delegar la tarea durante la preparación de la publicación y guardar el resultado. Hay margen para esperar el orden de generación, a diferencia de los servicios de chat que requieren respuestas inmediatas.
La traducción multilingüe también se puede explorar desde la misma perspectiva. Sería una forma de colocar el original y el idioma destino en una cola de tareas, verificar el título y el cuerpo devueltos por la CLI y luego incorporarlos como traducción. Si se comprueba que se preservaron los bloques de código, los enlaces, las citas y las cifras, y solo se vuelve a procesar el idioma fallido, tampoco hace falta recrear el texto original. Aplicar esta ruta a la traducción es todavía una tarea de validación futura que aún no he implementado.
No obstante, trasladarlo a la CLI no reduce por sí mismo los tokens necesarios para traducir. Si el trabajo se procesaba mediante una API de pago, existe el margen de reducir la cantidad consumida y el costo facturado en una API separada al trasladar parte del trabajo al uso de la suscripción. A cambio, asumo los límites de Codex, los tiempos de espera y la operación de verificación y reintentos de resultados. No he medido una reducción actual de los tokens o el costo de la traducción del blog.
Lo que realmente conecté en esta ocasión fueron las miniaturas. El blog solicita tareas de imagen mediante la API interna, Codex genera en un entorno autenticado con suscripción y el blog guarda los archivos de resultado. Lo que se necesitaba no era una rápida respuesta única, sino imágenes disponibles tras la espera y un estado de trabajo que permaneciera incluso después de un fallo. Gracias a esas condiciones, pude utilizar funciones de suscripción de Codex desde el blog como si fueran una API.