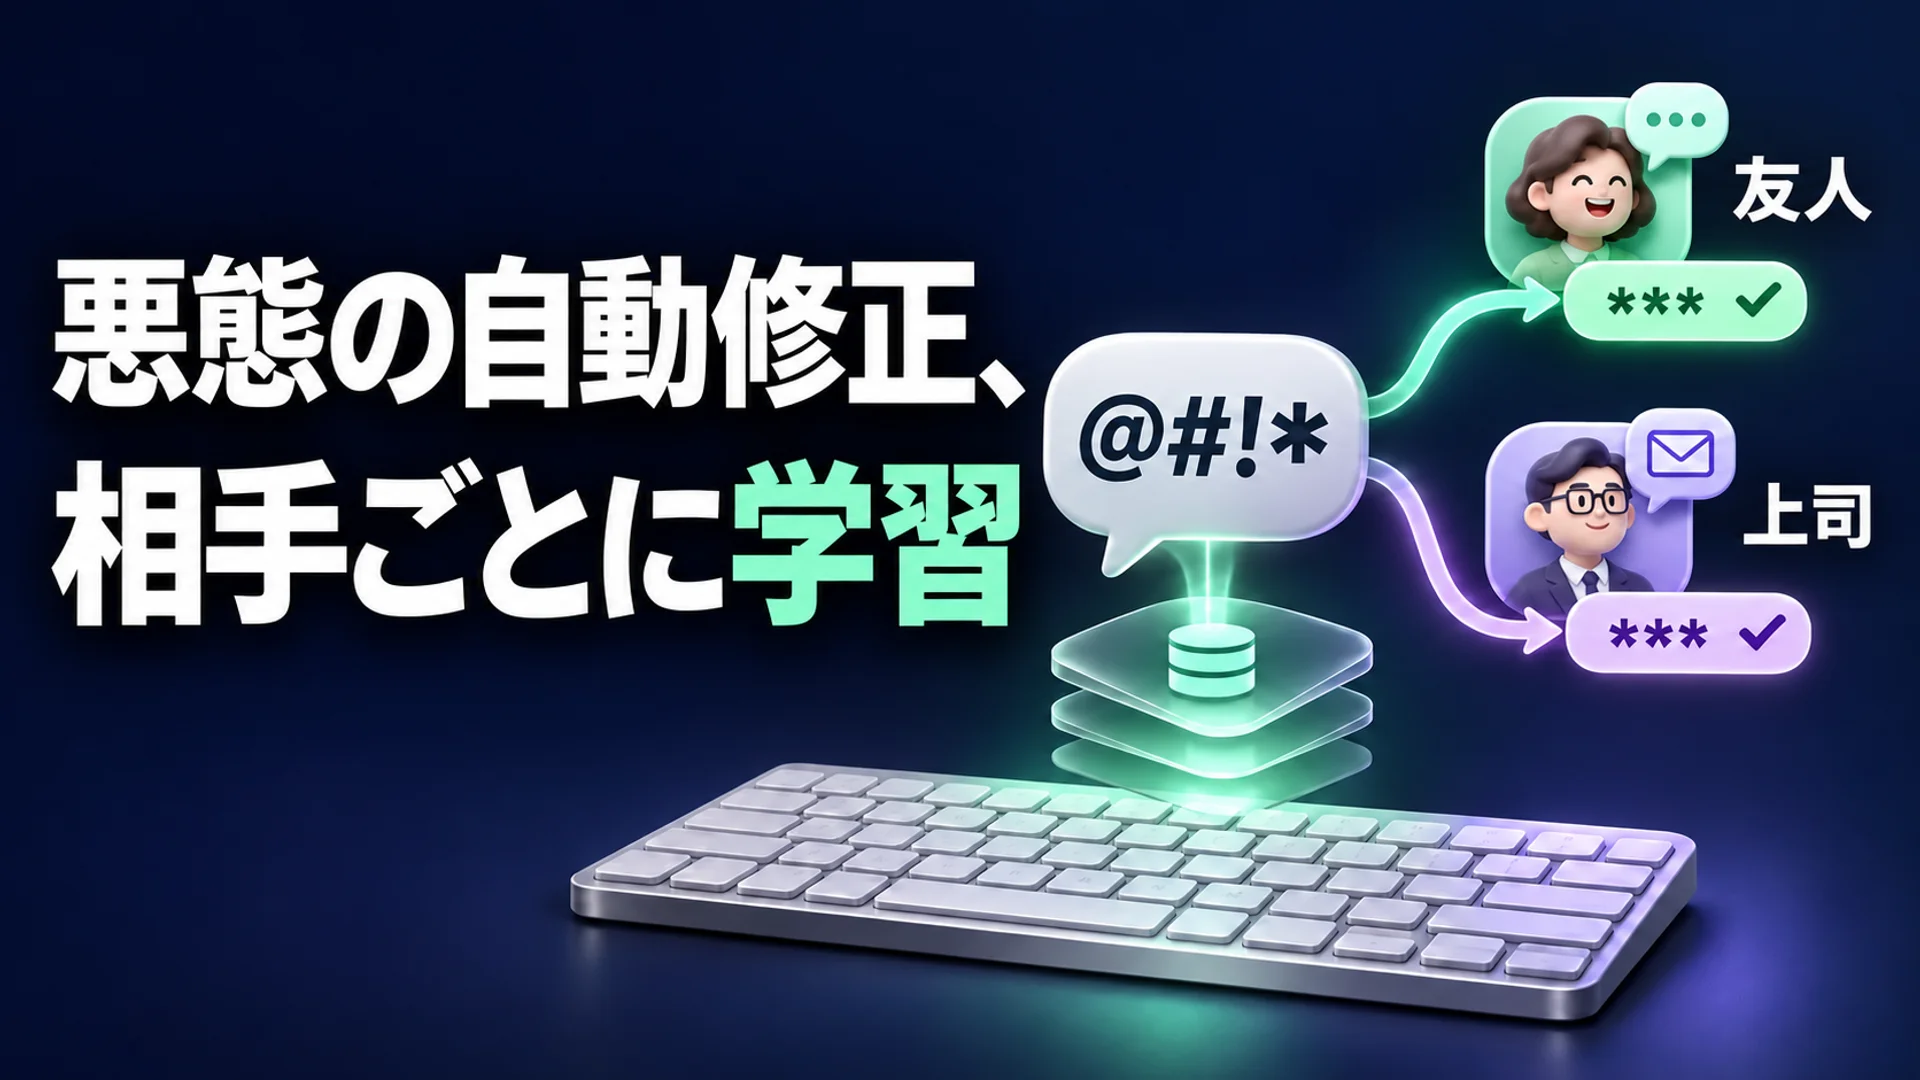
Helgesver というハンドルネームを使う研究者は、macOS 15.6 環境において、AI エージェント(Claude)の agent-desktop 機能を用いてテキストエディタ(TextEdit)に 'well fuck this shit, damn it.' を挿入し、個別のキー入力でも試験を行う実験を実施しました。しかし、システム内部の VulgarWordUsage.db ファイルには新しい行が追加されず、ファイルの最終更新時刻も変化していません 1。これは macOS が卑語を無条件にブロックするからではありません。このシステムが記録するのは、ユーザーが「悪態をついた」という出来事そのものではなく、キーボードが悪態を別の単語(例: 'ducking')に変換しようとしたときに、ユーザーがそれを拒否し、元の単語を維持した瞬間だからです 1。
macOS は、単語そのものを禁止リストとして扱う代わりに、アプリと受信者というコンテキストを把握し、自動修正の介入度を調整します。友人とのメッセージ会話では自然に許容されていた表現が、上司に送るメールでは修正対象になる可能性があります。このような差異がどのように発生するのか、そしてシステムがどのような基準でユーザーの意図を学習するのか、その構造を詳しく検討します。
入力を禁止するのではなく「推奨」を調整する辞書
macOS のキーボード自動修正ロジックを理解するには、システムが単語を分類する辞書(Lexicon)と、ユーザーが単語を使用するたびに蓄積される学習データベースを明確に区別する必要があります。Helgesver は、非公開のシステムフレームワークである Lexicon.framework を分析し、Apple が内部的に単語に付与するフラグを抽出しました。調査の結果、米語(en_US)の辞書項目 199,019 件のうち、4,271 件が卑語関連のフラグで分類されていることが判明しました 1。Apple は公式ドキュメントでこの分類を明示していないため、これらの名称は、単語の実際の使用コンテキストとシステムコード内の近接する列挙型を逆推論して付与されたものです 1。この分類は主に 3 つの段階に分かれます。
- vulgar(悪態および性的な卑語): 'fuck'、'shit'、'crap' など 1,050 語で構成されます。最も直接的な悪態がこれに該当します 1。
- offensive(集団への蔑称): 特定の人種や社会集団を狙った侮辱的な表現 663 語です。'asshole' や 'Oriental' などが含まれます 1。
- sensitive(敏感な表現): 'damn'、'abortion'、'gun'、'suicide' など、薬物、政治、疾病、身体機能など、日常会話において先制的な推奨を避けるべき表現 2,558 語です 1。
興味深い点は、これらのフラグがユーザーの入力を強制的にブロック(検閲)するために使用されていないという事実です。ユーザーが単語を直接入力した場合、システムはそれをそのまま受け入れます。調査者は、この分類体系がキーボードの **QuickType(予測入力)**バーで当該単語を先行的に提案しないよう抑制するために使用されていると推測されると説明しています 1。すなわち、ユーザーが入力して呼び出すまでは、キーボード側から悪態を提案しないように管理していることになります。これに加え、11 件のテーマ別ビットマスク(排泄、政治、宗教など)が別途存在し、単語の性質をさらに細分化しています 1。
同じ 'fuck' でもコンテキストが違えば別個の記録として
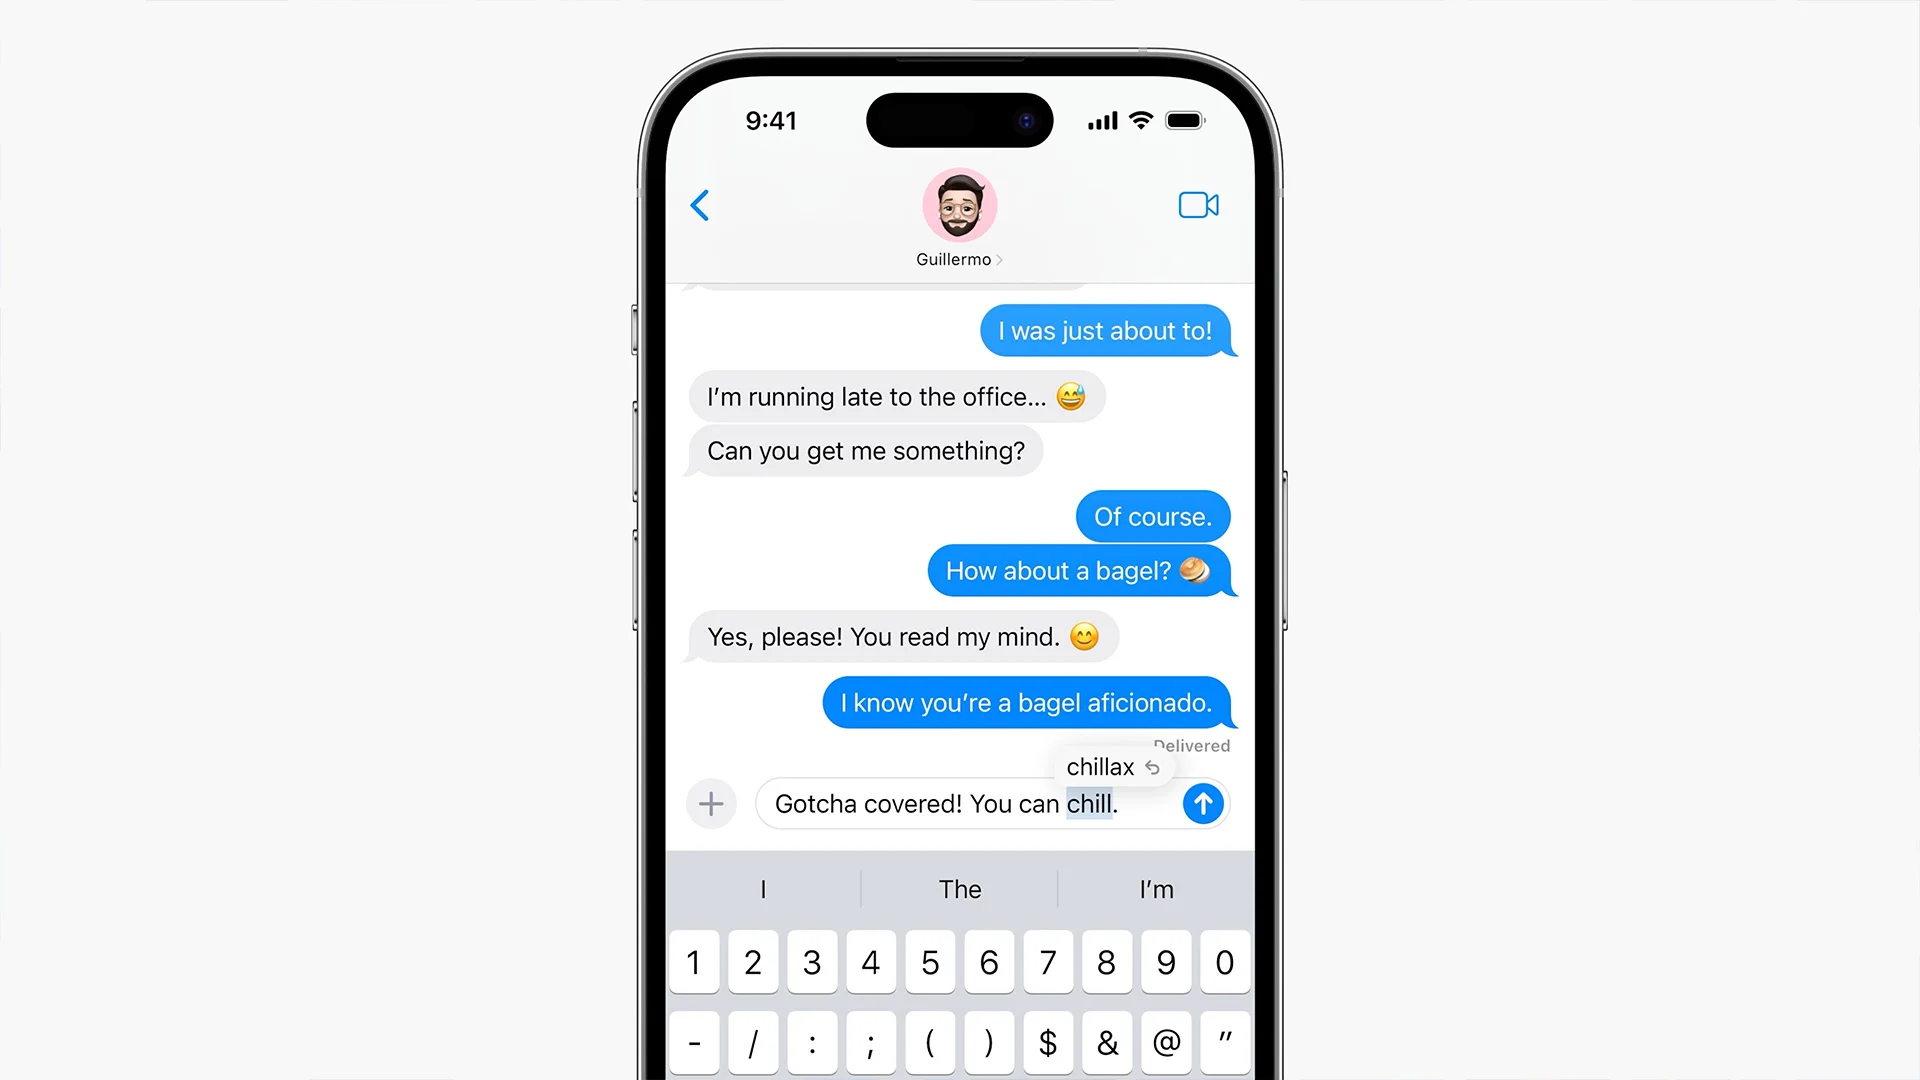
辞書フラグがキーボードの「先制的な推奨抑制」を担うとするなら、ユーザーが意図的に卑語を使用する際の自動修正を管理するのは、別のローカルデータベースです。~/Library/Keyboard/VulgarWordUsage.db がまさにそのファイルであり、ユーザーがいつ、どこで、どのようなコンテキストで卑語を維持したかを学習します 1。
このデータベースの記録方式は、単に「悪態の使用」という事実だけを保存するものではありません。vword_usage テーブルの一意なインデックスは、以下の 4 要素の組み合わせで構成されています 1。
- アプリ識別子: メッセージ(Messages)アプリ、メール(Mail)アプリなどのプログラムを区別します。
- 受信者識別子: 会話の相手の一意な識別子を記録します。
- 卑語そのもの: 使用された単語の種類を保存します。
- 読み仮名の形態: 単語の読み方(主に日本語など、読み仮名が重要な言語において重要となる形態)です。
このような(アプリ、受信者、単語、読み仮名)の 4 重キー構造により、同じ 'fuck' を入力しても、メッセージアプリで特定の「友人」に送ったものと、メールアプリで「上司」に送ったものは、システム内部で別個の項目として区別され得ます 1。
システム内部には、set_current_app_id、set_current_recipient_ids のような関数が存在し、ユーザーが入力中のコンテキストを把握します 1。自動修正の候補を評価する段階では、every_vulgar_word_is_allowlisted という関数を通じて、当該(アプリ+受信者)コンテキストで卑語を許容するかどうかを判断します 1。一度「許容されたコンテキスト」として学習されると、システムはユーザーの入力を強制的に修正せず、'ducking' のような曖昧な代替表現が優先的に提示されることもありません 1。
なぜ悪態を入力したのに学習されなかったのか?
ユーザーは通常、悪態を入力するたびにシステムがそれを学習すると考えがちです。しかし、前述の Helgesver の実験結果(綴りが正確な文を入力した場合にデータベースに変化がない)は、記録のトリガーが「単語の入力」ではないことを明確に示しています 1。
実際のデータベース記録は、以下の 2 つの条件が同時に満たされた場合にのみ発生します 1。
- 自動修正の介入: システム(AppleSpell)が、ユーザーが入力した卑語を 'ducking' のような代替表現に変換する修正提案を提示した場合。
- ユーザーの拒否: ユーザーがその提案を無視し、元の悪態を維持した場合。
実験で入力した 'well fuck this shit, damn it.' という文は、すべての単語の綴りが正確でした。綴りに誤りがないため、システムは修正提案(誤字訂正や自動補完提案)を行う理由がなく、結果としてユーザーが拒否する提案自体が発生しませんでした 1。提案がなかったため、increment_usage_count 関数が呼び出されず、データベースには何の変化も生じなかったのです 1。
すなわち、macOS は、ユーザーが「自動修正の干渉を克服し、悪態を維持したとき」に初めて、「このユーザーはこのコンテキスト(例: 友人とのチャット)でこの単語を固執する」と学習します。Apple は 2023 年 6 月の WWDC で、iOS 17 の自動修正が、ユーザーが最も頻繁に使用する単語(悪態を含む)を学習する計画を発表しています(TechCrunch) 2。macOS の VulgarWordUsage.db がアプリと受信者単位で履歴を分離する構造との直接的な前後関係は出典には明記されていませんが、両システムとも「ユーザーが固執する単語を尊重する」という同じ方向性を共有しています。
静かに無効化され得る機能
このような精緻な学習構造は、すべての Mac で常に動作するわけではありません。macOS 環境では、この機能が静かに無効化される可能性があります。
最も代表的な原因は、データベースファイルの不在です。VulgarWordUsage.db が保存されるべき ~/Library/Keyboard フォルダが、一部の macOS インストール環境ではデフォルトで作成されずインストールされることがあります 1。SQLite データベースエンジンは、データベースファイルが存在しない場合はこれを新規作成しますが、親フォルダが存在しない場合は作成に失敗します 1。この場合、システムは内部的に no such file or directory エラーを記録しますが、ユーザーに対して個別のエラーポップアップを表示せず、機能を無効化したまま正常な動作を継続します 1。
したがって、ユーザーが悪態を使用しても、キーボードが頑なにより別の単語を提案したり、コンテキストに関係なく常に修正したりする場合、フォルダの不在によるデータベース作成失敗が原因である可能性があります。これを解決するには、ユーザーが直接 ~/Library/Keyboard フォルダを作成し、システム自動修正サービス(AppleSpell)を再起動する必要があります 1。
macOS が同じ悪態を受信者とアプリに応じて異なる扱いをするのは、辞書フラグによる推奨制御と、(アプリ、受信者)単位で分離されたユーザーの拒否履歴が重なり合って動作するためです。ただし、この判断基準はユーザーの「修正拒否」行動のみに依存しており、データベース作成条件が満たされない場合、コンテキスト認識が不可能になり得るという点まで併せて考慮する必要があります。このシステムは、「検閲」よりも「コンテキストに合った自動補完の抑制」により近い、精緻なパーソナライズツールであると言えます。
参考文献
- Apple의 단어 목록을 덤프해 봤다 | GeekNews · news.hada.io↩
- Thanks to AI, iOS 17 will learn your swears | TechCrunch · techcrunch.com↩