Un investigador que utiliza el apodo «Helgesver» realizó un experimento en un entorno de macOS 15.6. Usó la función agent-desktop del agente de IA (Claude) para insertar la frase 'well fuck this shit, damn it.' en el editor de texto TextEdit y probó también mediante pulsaciones de teclas individuales. Sin embargo, no se añadió ninguna línea nueva al archivo VulgarWordUsage.db interno del sistema, y la última hora de modificación del archivo tampoco cambió 1. Esto no ocurre porque macOS bloquee incondicionalmente las groserías. Lo que este sistema registra no es el hecho en sí de que el usuario «dijera» una grosería, sino el momento en que el teclado «intentaba» cambiar la grosería por otra palabra (por ejemplo, 'ducking') y el usuario rechazaba ese cambio para mantener la palabra original 1.
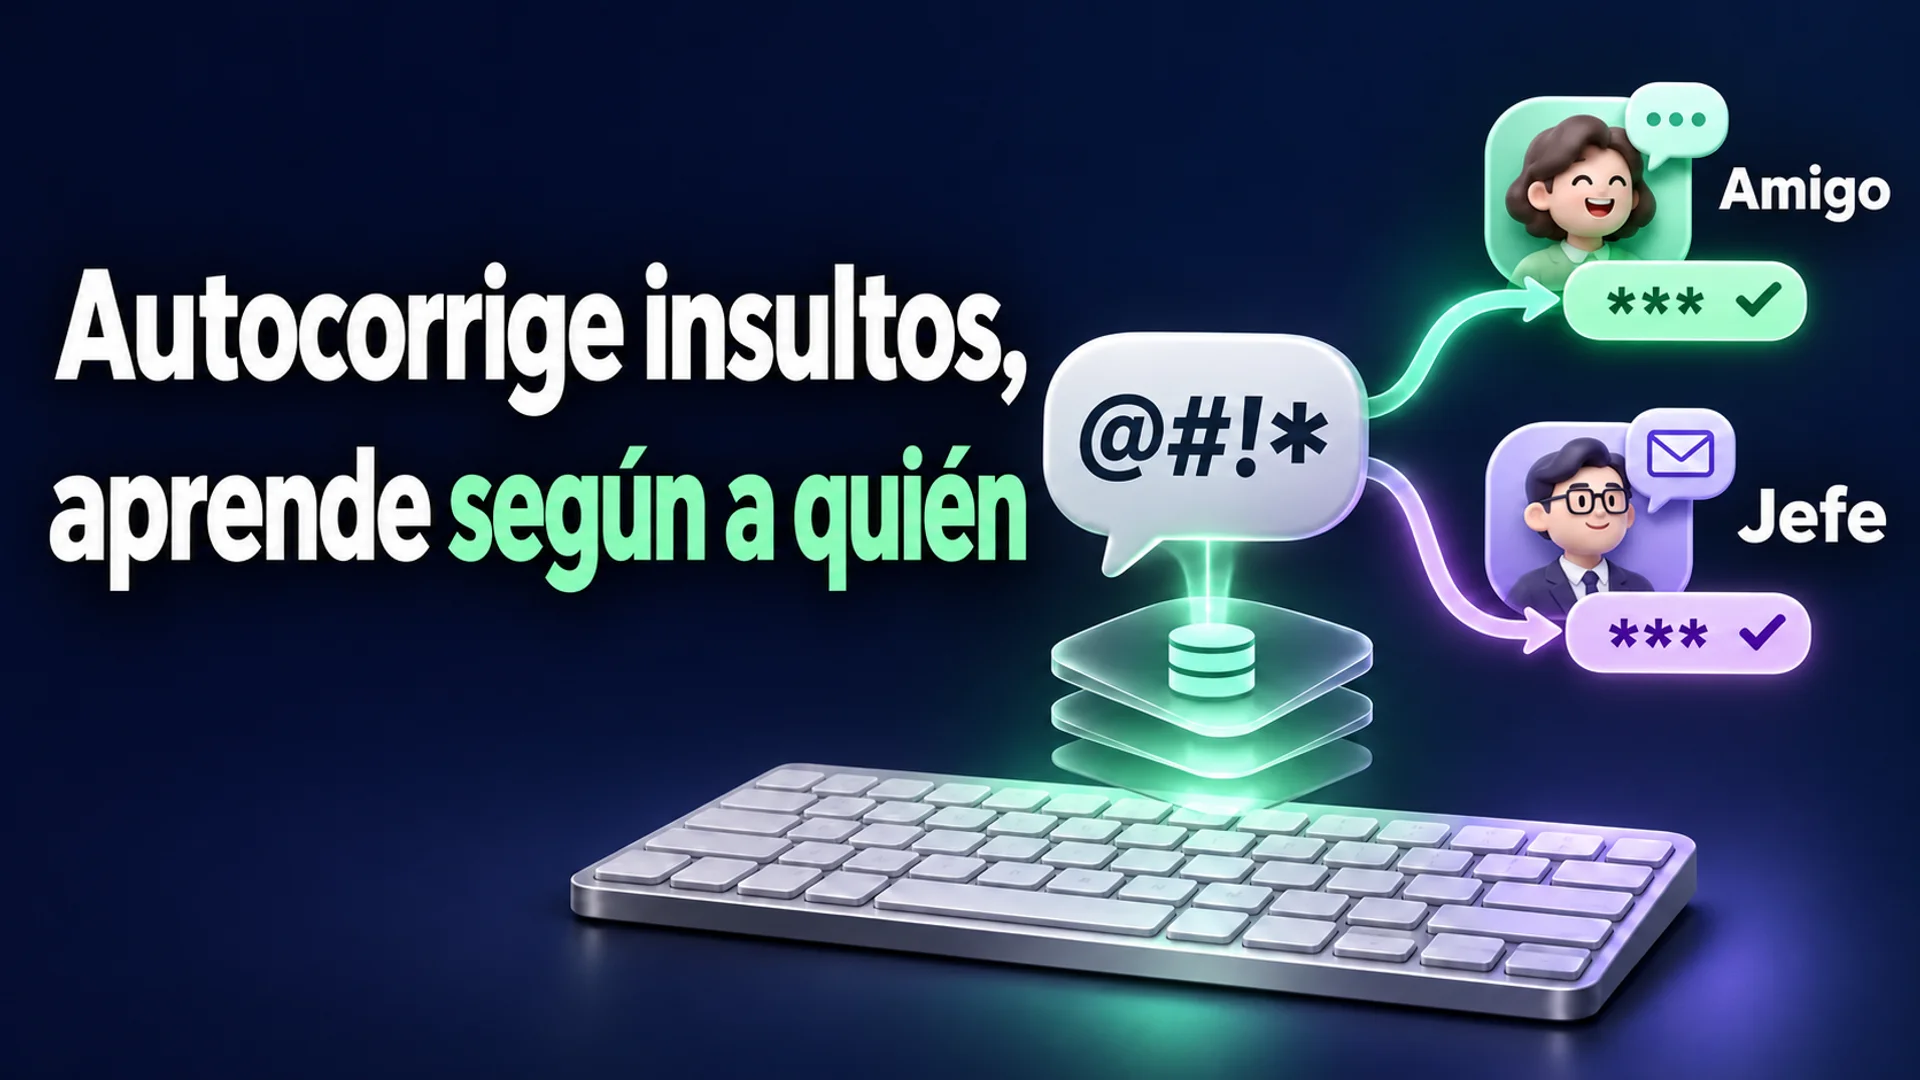
macOS no gestiona las palabras mediante una lista negra de prohibición, sino que ajusta el grado de intervención de la autocorrección tras identificar el contexto, determinado por la app y el destinatario. Una expresión permitida de forma natural en una conversación de mensajería con un amigo puede pasar a ser un objetivo de corrección en un correo dirigido a un superior. En este artículo se examina en detalle cómo surgen estas diferencias y bajo qué criterios el sistema aprende la intención del usuario.
Un diccionario que regula las «sugerencias», no la prohibición de la entrada
Para comprender la lógica de autocorrección del teclado en macOS, es necesario distinguir con claridad entre el diccionario (Lexicon), mediante el cual el sistema clasifica las palabras, y la base de datos de aprendizaje que se acumula cada vez que el usuario utiliza una palabra. Helgesver analizó Lexicon.framework, un framework privado del sistema, para extraer las marcas que Apple asigna internamente a las palabras. Los resultados de la investigación indican que, de 199 019 entradas del diccionario en inglés de Estados Unidos (en_US), 4 271 están clasificadas con marcas relacionadas con la vulgaridad 1. Dado que Apple no explicita esta clasificación en su documentación oficial, dichos nombres se han asignado mediante inferencia retroactiva a partir del contexto real de uso de las palabras y de los enum adyacentes presentes en el código del sistema 1. Esta clasificación se divide principalmente en tres categorías.
- vulgar (groserías y slang sexual): incluye 1 050 palabras, como 'fuck', 'shit' y 'crap'. Aquí se encuentran las groserías más directas 1.
- offensive (términos despectivos hacia colectivos): abarca 663 expresiones ofensivas dirigidas a grupos étnicos o colectivos sociales concretos. Incluye palabras como 'asshole' u 'Oriental' 1.
- sensitive (expresiones sensibles): contiene 2 558 expresiones, como 'damn', 'abortion', 'gun' y 'suicide', relativas a drogas, política, enfermedades o funciones corporales, para las que conviene evitar sugerencias proactivas en la conversación cotidiana 1.
Lo interesante es que estas marcas no se emplean para bloquear (censurar) de forma forzosa la entrada del usuario. Si el usuario escribe y teclea una palabra directamente, el sistema la acepta sin más. El investigador señala que este sistema de clasificación parece destinarse a suprimir que dichas palabras se ofrezcan como sugerencia previa en la barra de QuickType (entrada predictiva del teclado 1. Es decir, se gestiona que el teclado no proponga una grosería de antemano, a menos que el usuario la introduzca en primer lugar. Además, existen por separado 11 máscaras de bits temáticas (excreción, política, religión, etc.) que especifican aún más el carácter de las palabras 1.
Un mismo 'fuck' puede originar registros distintos si el contexto difiere
Si las marcas del diccionario asumen el control de la «supresión de sugerencias proactivas» del teclado, lo que regula la autocorrección cuando el usuario emplea deliberadamente una grosería es una base de datos local independiente. Ese archivo es ~/Library/Keyboard/VulgarWordUsage.db, el cual aprende cuándo, dónde y en qué contexto el usuario ha mantenido una grosería 1.
El método de registro de esta base de datos no se limita a almacenar el mero hecho del «uso de una grosería». El índice único de la tabla vword_usage se compone de la combinación de los siguientes cuatro elementos 1.
- Identificador de la app: distingue entre aplicaciones como Mensajes (Messages) o Mail.
- Identificador del destinatario: registra el identificador único de la persona con la que se conversa.
- La propia grosería: guarda el tipo de palabra utilizada.
- Forma de representación fonética: la forma en que se lee la palabra (relevante principalmente en lenguas donde la lectura importa, como el japonés).
Gracias a esta estructura de clave cuádruple (app, destinatario, palabra, fonética), introducir un mismo 'fuck' se distingue internamente en el sistema como entradas diferentes, según se envíe a un «amigo» concreto desde la app Mensajes o a un «superior» desde la app Mail 1.
En el interior del sistema existen funciones como set_current_app_id e set_current_recipient_ids que determinan el contexto en el que el usuario está escribiendo en ese momento 1. Durante la evaluación de los candidatos de autocorrección, una función denominada every_vulgar_word_is_allowlisted decide si se permite una grosería en el contexto concreto (app + destinatario) 1. Una vez que el sistema aprende un «contexto permitido», no corrige a la fuerza la entrada del usuario ni ofrece como prioridad expresiones alternativas ambiguas, como 'ducking' 1.
¿Por qué no se aprendió la grosería que escribí?
Es fácil suponer que el sistema aprende cada vez que el usuario escribe una grosería. Sin embargo, el resultado del experimento de Helgesver antes mencionado (sin cambios en la base de datos al introducir una frase con ortografía correcta) muestra con claridad que el desencadenante del registro no es la «entrada de la palabra» 1.
El registro real en la base de datos solo se produce cuando se cumplen simultáneamente las dos siguientes condiciones 1.
- Intervención de la autocorrección: el sistema (AppleSpell) presenta una propuesta de corrección que pretende cambiar la grosería tecleada por una expresión alternativa, como 'ducking'.
- Rechazo del usuario: el usuario ignora esa propuesta y mantiene la grosería original.
En el experimento, la frase introducida 'well fuck this shit, damn it.' tenía todos los términos con la ortografía correcta. Al no existir errores ortográficos, el sistema no tenía motivo para formular una propuesta de corrección (corrección de erratas o autocompletado) y, por consiguiente, no se generó ninguna propuesta que el usuario pudiera rechazar 1. Al no haber propuesta, no se invocó la función increment_usage_count y la base de datos permaneció inalterada 1.
Es decir, macOS aprende «este usuario insiste en esta palabra en este contexto (por ejemplo, chat con un amigo)» únicamente cuando el usuario «defiende la grosería frente a la intervención de la autocorrección». Apple anunció en la WWDC de junio de 2023 que la autocorrección de iOS 17 aprendería las palabras más utilizadas por el usuario, incluidas las groserías (TechCrunch) 2. La fuente no especifica una relación directa de precedencia entre la estructura de VulgarWordUsage.db en macOS, que separa el historial por app y destinatario, y esta afirmación; no obstante, ambos sistemas comparten la misma orientación: «respetar las palabras en las que el usuario insiste».
Una función que puede apagarse silenciosamente
Esta sofisticada estructura de aprendizaje no está siempre activa en todos los Mac. En el entorno de macOS, la función puede desactivarse de forma silenciosa.
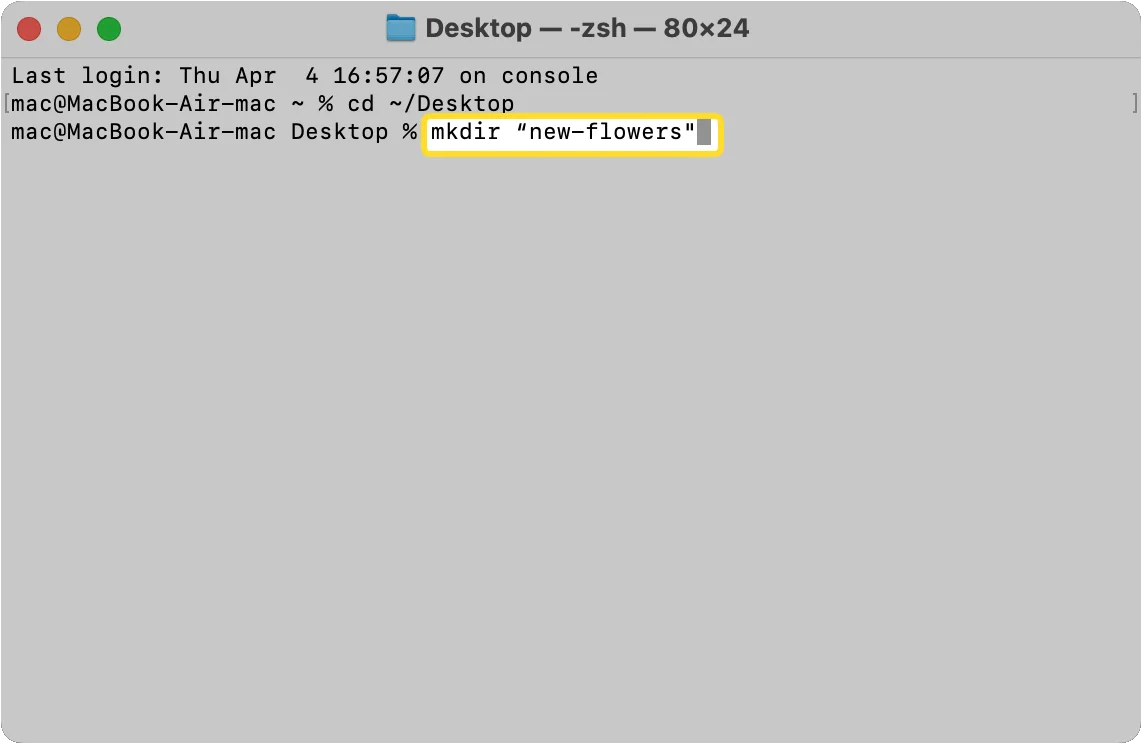
La causa más representativa es la ausencia del archivo de base de datos. En algunas instalaciones de macOS, la carpeta ~/Library/Keyboard, donde debe guardarse VulgarWordUsage.db, puede instalarse sin crearse por defecto 1. El motor de bases de datos SQLite crea un nuevo archivo si este no existe, pero falla al crearlo si la carpeta superior no está presente 1. En ese caso, el sistema registra internamente un error no such file or directory, pero no muestra ningún pop-up de error al usuario y continúa funcionando con normalidad, aunque con la función desactivada 1.
Por tanto, si el usuario emplea groserías y el teclado insiste en proponer otras palabras, o corrige siempre sin atender al contexto, la causa podría ser un fallo en la creación de la base de datos por ausencia de la carpeta. Para resolverlo, el usuario debe crear manualmente la carpeta ~/Library/Keyboard y reiniciar el servicio de autocorrección del sistema (AppleSpell) 1.
Que macOS trate una misma grosería de forma distinta según el destinatario y la app se debe a la confluencia del control de sugerencias basado en las marcas del diccionario y del historial de rechazos del usuario, separado por (app, destinatario). No obstante, cabe tener presente que este criterio de decisión depende únicamente de la acción de «rechazo de la corrección» del usuario y que, si no se cumplen las condiciones de creación de la base de datos, puede no ser posible reconocer el contexto. En definitiva, este sistema se asemeja menos a la «censura» y más a una herramienta sofisticada de personalización orientada a la «supresión del autocompletado según el contexto».
Referencias
- Apple의 단어 목록을 덤프해 봤다 | GeekNews · news.hada.io↩
- Thanks to AI, iOS 17 will learn your swears | TechCrunch · techcrunch.com↩